


Datology AI
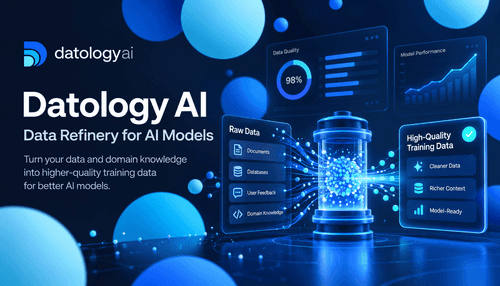
NexusAi Zusammenfassung: Datology veredelt Unternehmensdaten und öffentliche Daten zu kuratierten Trainingsdatensätzen für Mid-Training oder Pre-Training. Die Pipeline erhöht den Informationsgehalt pro Token und ermöglicht kleinere, schnellere Modelle mit messbaren Verbesserungen bei der Evaluation sowie die Bereitstellung in einer Private Cloud.
NexusAi Überblick
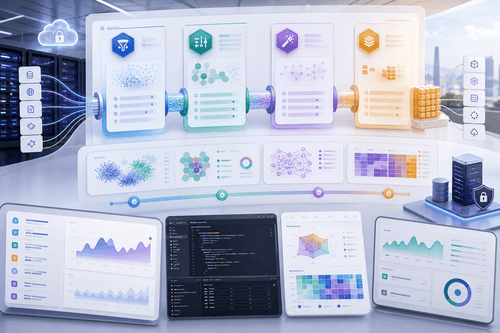
Datologys Workflow nimmt Daten aus Unternehmen und dem Web auf, beseitigt Formatierungsprobleme und Kontamination und wendet anschließend Qualitätsfilter und Aufgabentaxonomien an. Synthetisch generierte Beispiele schließen Lücken, während kuratierte Mischungen als gestaffelte Datensätze bereitgestellt werden, die auf nachgelagerte Evaluationen abgestimmt sind.
Funktionen
Die Lösung eignet sich besonders für ML-Forschende, Data Engineers und technische Entscheider, die eigene Basismodelle entwickeln oder Open-Modelle für domänenspezifische Aufgaben anpassen. Teams in den Bereichen Recht, Suche, Sprache und spezialisierten Branchen profitieren besonders, wenn proprietäre Korpora und gekennzeichnetes Fachwissen das Modellverhalten im Vergleich zu allgemeinem Pre-Training deutlich verändern.
- Clean entfernt in großem Umfang fehlerhaft formatierte und durch Evaluationen kontaminierte Dokumente.
- Calibrate stimmt Datenqualität, Aufgaben und Taxonomie auf konkrete Ziele ab.
- Create generiert gezielte Beispiele, um Aufgabenrelevanz und Vielfalt zu erhöhen.
- Compose kombiniert Quellen optimal zu gestaffelten Trainingsdatensätzen für Trainingsläufe.
- Die Bereitstellung in einer Private Cloud schützt proprietäre Daten und macht ihre Verarbeitung nachvollziehbar.
Nachweise und Leistung
Kundenperspektive
Vereinbaren Sie zunächst eine Demo und teilen Sie mit, was Sie mit Ihren Datensätzen erreichen möchten. Das Onboarding von Datology umfasst Konnektoren für gängige Speicherlösungen, ein auf Nachvollziehbarkeit ausgelegtes Kuratierungsstudio und Exportformate für Trainingsframeworks. Teams können die Datenraffinerie in einer Private Cloud oder auf einer vollständig isolierten Infrastruktur betreiben. Erste Projekte konzentrieren sich in der Regel auf einen gezielten Mid-Training-Durchlauf oder ein kuratiertes Pre-Training-Korpus. Dokumentation und Forschungsnotizen helfen Teams dabei, Kuratierungsentscheidungen zu reproduzieren und die Leistungssteigerung nach dem Training zu messen.
NexusAi: „Sie wissen, was wir wissen – viele der Leistungssteigerungen, die man durch mehr Rechenleistung zu erreichen versucht, stecken ungenutzt in den Daten.“ — Forschungsleiter, Thomson Reuters
Erste Schritte
Datology bündelt Forschungs- und Produktionsverfahren in einer kuratierten Pipeline, die die Modellleistung durch bessere Trainingssignale steigert. Die Kombination aus dem Entfernen von Kontamination, gezielter synthetischer Datengenerierung und gestaffelter Zusammenstellung ermöglicht kleinere, schnellere Modelle für domänenspezifische Aufgaben – bei gleichzeitigem Schutz und nachvollziehbarer Verarbeitung von Unternehmensdaten.
Öffne das Tool und prüfe die zentrale Produkterfahrung.
Erstelle ein Konto oder greife auf deinen bestehenden Workspace zu.
Nutze eine eigene Aufgabe, um Geschwindigkeit, Qualität und Passung zu bewerten.
Prüfe ähnliche KI-Tools, bevor du eine endgültige Entscheidung triffst.
Datology AI
DatologyAI ist ein spezialisiertes Data-Engineering-Unternehmen, das Unternehmens- und Webdaten in Trainingskorpora mit hohem Informationsgehalt umwandelt. Das Team verbindet wissenschaftliche Expertise mit praxistauglichen Tools, damit Modellbauer kuratierte Datensätze reproduzierbar erstellen und bereitstellen können.
Datology ist eine Datenraffinerie, die proprietäre, lizenzierte und öffentliche Webdatenquellen in hochwertige Trainingsdaten für Modellbauer umwandelt. Das Produkt wird mit Kundendaten betrieben – Datology verkauft keine Tokens und beschafft sie auch nicht. Stattdessen kommt eine vierstufige Pipeline zum Einsatz: Bereinigung zur Entfernung von Störsignalen und Evaluationskontamination, Kalibrierung zur Abstimmung von Qualität und Taxonomie, synthetische Generierung zur Erweiterung der Aufgabenrelevanz und Zusammenstellung zu gestaffelten Trainingskorpora. Datology richtet sich an Mid-Training- und Pre-Training-Workflows, lässt sich in bestehende Datenspeicher und Datenaufnahmeprozesse integrieren und bietet praxiserprobte Tools auf Forschungsniveau, die sich auch im Frontier-Maßstab bewährt haben. Das Ergebnis: mehr Informationsgehalt pro Token, geringere Rechenkosten bei gleicher Leistung sowie Optionen für die Bereitstellung in einer Private Cloud und die Einhaltung von Compliance-Vorgaben.
Datology AI besuchen
Kommentare (0)
Keine Kommentare gefunden