


Fireworks
NexusAi Zusammenfassung: Fireworks ist eine Trainings- und Inferenzplattform, die leistungsstarke offene Modelle in spezialisierte Intelligenz verwandelt. Sie bietet OpenAI-kompatible APIs, hochskalierbare Bereitstellung und eine umfassende Trainings-API, damit Teams iterieren, bereitstellen und Kosten im Produktionsmaßstab kontrollieren können.

NexusAi Überblick
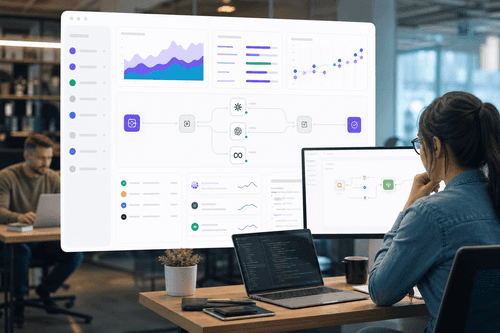
Teams beschreiben eine Aufgabe, prüfen den Plan und die voraussichtlichen Kosten und starten geführte oder konfigurationsbasierte Trainingsläufe. Jeder Checkpoint kann auf derselben Infrastruktur in die Produktion überführt werden. Wählen Sie serverlose Prioritäts-/Schnellwarteschlangen, dedizierte On-Demand- oder reservierte Kapazitäten, routen Sie zum besten Modell und überwachen Sie die Leistung bei vorhersehbaren Kosten.
Fähigkeiten
Fireworks eignet sich für Plattform-Teams, die den KI-Zugang standardisieren, Produktgruppen, die Assistenten oder Agenten ausliefern, sowie Forschungsteams, die RL oder Fine-Tuning im großen Maßstab iterieren. Es ist auch ideal für technische Führungskräfte, die Kosten und Latenz bei Coding-Assistenten, Enterprise-Chat und langkontextigem RAG optimieren. Organisationen, die Wert auf vorhersehbare Leistung, schnelle Checkpoint-Freigabe und Multi-Modell-Optionen legen, profitieren am meisten.
- OpenAI- und Anthropic-kompatible Endpunkte für serverlose, bedarfsorientierte und reservierte Inferenz.
- Die Trainings-API umfasst geführte, konfigurationsbasierte und vollständig individuelle RL- oder überwachte Läufe.
- Trainings-Checkpoints können in Sekunden auf derselben Infrastruktur in die Produktion überführt werden.
- Die Modellbibliothek bietet optimierte offene Modelle mit langem Kontext und zuverlässigem Durchsatz.
- Adapterbasiertes Fine-Tuning unterstützt Multi-LoRA-Workflows für kompakte, unternehmensgerechte Spezialisierung im großen Maßstab.
Highlights
Wer sollte Fireworks nutzen
Erstellen Sie ein Konto, generieren Sie einen API-Schlüssel und rufen Sie sofort OpenAI-kompatible Chat- oder Completion-Endpunkte auf. Verwenden Sie die CLI oder Konsole, um ein Modell aus der Bibliothek auszuwählen, oder reichen Sie einen Trainingsjob über das Training-SDK für geführte oder individuelle Pipelines ein. Beginnen Sie mit serverlosen Prioritäts-/Schnellwarteschlangen für Experimente und skalieren Sie dann auf On-Demand- oder reservierte Bereitstellungen für Produktions-SLAs. Überwachen Sie Durchsatz, Latenz und Ausgaben und fördern Sie Checkpoints mit einem einzigen Workflow zur Inferenz. Für komplexe Workloads ziehen Sie das Team hinzu, um Pläne und Kosten vor der Ausführung zu prüfen.
NexusAi: Bauen Sie spezialisierte Intelligenz auf, indem Sie Training, Routing und Bereitstellung auf einem verlässlichen Stack selbst steuern.
Erste Schritte
Fireworks vereint Training und Inferenz, sodass Teams die Lernschleife selbst steuern, Workloads intelligent routen und strenge Latenz- und Kostenziele erreichen können. Mit OpenAI-kompatiblen APIs, einer kuratierten Modellbibliothek und elastischen Bereitstellungen reduziert es Integrationsrisiken und beschleunigt Iterationen. Nutzen Sie es, um offene Modelle in verlässliche, spezialisierte Intelligenz zu industrialisieren, ohne die Kontrolle abzugeben.
Öffne das Tool und prüfe die zentrale Produkterfahrung.
Erstelle ein Konto oder greife auf deinen bestehenden Workspace zu.
Nutze eine eigene Aufgabe, um Geschwindigkeit, Qualität und Passung zu bewerten.
Prüfe ähnliche KI-Tools, bevor du eine endgültige Entscheidung triffst.
Fireworks
Fireworks AI entwickelt grundlegende Trainings- und Inferenzinfrastruktur für spezialisierte Intelligenz, geführt von Ingenieuren mit tiefgreifender Erfahrung in großskaligen ML-Systemen und Mitwirkenden aus der PyTorch-Community. Das Unternehmen konzentriert sich darauf, offene Modelle in produktionsreife, kosteneffiziente Lösungen für Agenten, Coding, Chat und Enterprise RAG zu verwandeln.
Fireworks ist eine End-to-End-Plattform für das Training und die Bereitstellung leistungsstarker LLMs und multimodaler Modelle. Sie stellt eine nahtlos einsetzbare, OpenAI- und Anthropic-kompatible API mit Multi-Provider-Routing bereit sowie eine Trainings-API, die geführte Jobs, konfigurationsbasierte Läufe und vollständig individuelle RL- oder überwachte Pipelines abdeckt. Checkpoints können in Sekunden auf derselben Infrastruktur in die Produktion überführt werden, was die Reibung zwischen Experimentieren und Bereitstellung minimiert. Serverlose, bedarfsorientierte und reservierte Kapazitäten ermöglichen es Teams, Latenz, Durchsatz und Kosten auszubalancieren, während die Modellbibliothek beliebte offene Modelle mit Fokus auf Qualität und Effizienz bereitstellt. Die Produktions-Engine ist über den gesamten Stack hinweg für konstante Latenz und hohen Token-Durchsatz optimiert und unterstützt Agenten-, Coding-, RAG- und Evaluierungs-Workloads. Fireworks unterstützt zudem adapterbasiertes Fine-Tuning, einschließlich Multi-LoRA-Workflows und Varianten mit langem Kontext, sowie Prioritäts- und Schnellwarteschlangen mit Abrechnung pro Token. Das Ergebnis sind vorhersehbare Leistung und deutlich geringere End-to-End-Kosten für Codierung und Bereitstellung.
Fireworks besuchen
Kommentare (0)
Keine Kommentare gefunden