

NexusAi logo

NexusAi

  • Produkte
  • Kategorie
  • Prompts
  • Suche
  • Einblicke
  • Preise
  • Bewerben
  • Kontakt
Anmelden
NexusAi LogoNexusAi

NexusAI hilft Ihnen dabei, KI-Tools mit Leichtigkeit zu entdecken, zu vergleichen und zu erlernen. Von Experten-Einblicken bis hin zu Trainingsressourcen befähigen wir Einzelpersonen und Unternehmen, KI-Technologie für klügere Entscheidungen, Innovation und Wachstum zu nutzen.

Nützliche Links

  • Über uns
  • AI-Produkte
  • AI-Kategorien
  • AI-Prompts
  • AI-Suche
  • AI Insights

Dienste & Rechtliches

  • Präsentation & Werbung
  • Mitgliedschaftspläne
  • Allgemeine Geschäftsbedingungen
  • Rückerstattungsrichtlinie
  • Datenschutzrichtlinie
  • Haftungsausschluss

Kontaktieren Sie uns

88 Tribune Street
South Brisbane, QLD, Australien, 4101
Webseite: www.nexusai-tech.com
E-Mail: info@nexusai-tech.com

© Urheberrecht 2026 NexusAi Alle Rechte vorbehalten

Entwickelt von DStudio Technology
Startseite/AI-Einblick/KI-Modell- & Plattform-Updates/Anthropic: Claude-Schutzmaßnahmen senken Angriffe zur Modelldestillation um bis zu 99 %
KI-Modell- & Plattform-UpdatesÜberwachung der Modell-Extraktion

Anthropic: Claude-Schutzmaßnahmen senken Angriffe zur Modelldestillation um bis zu 99 %

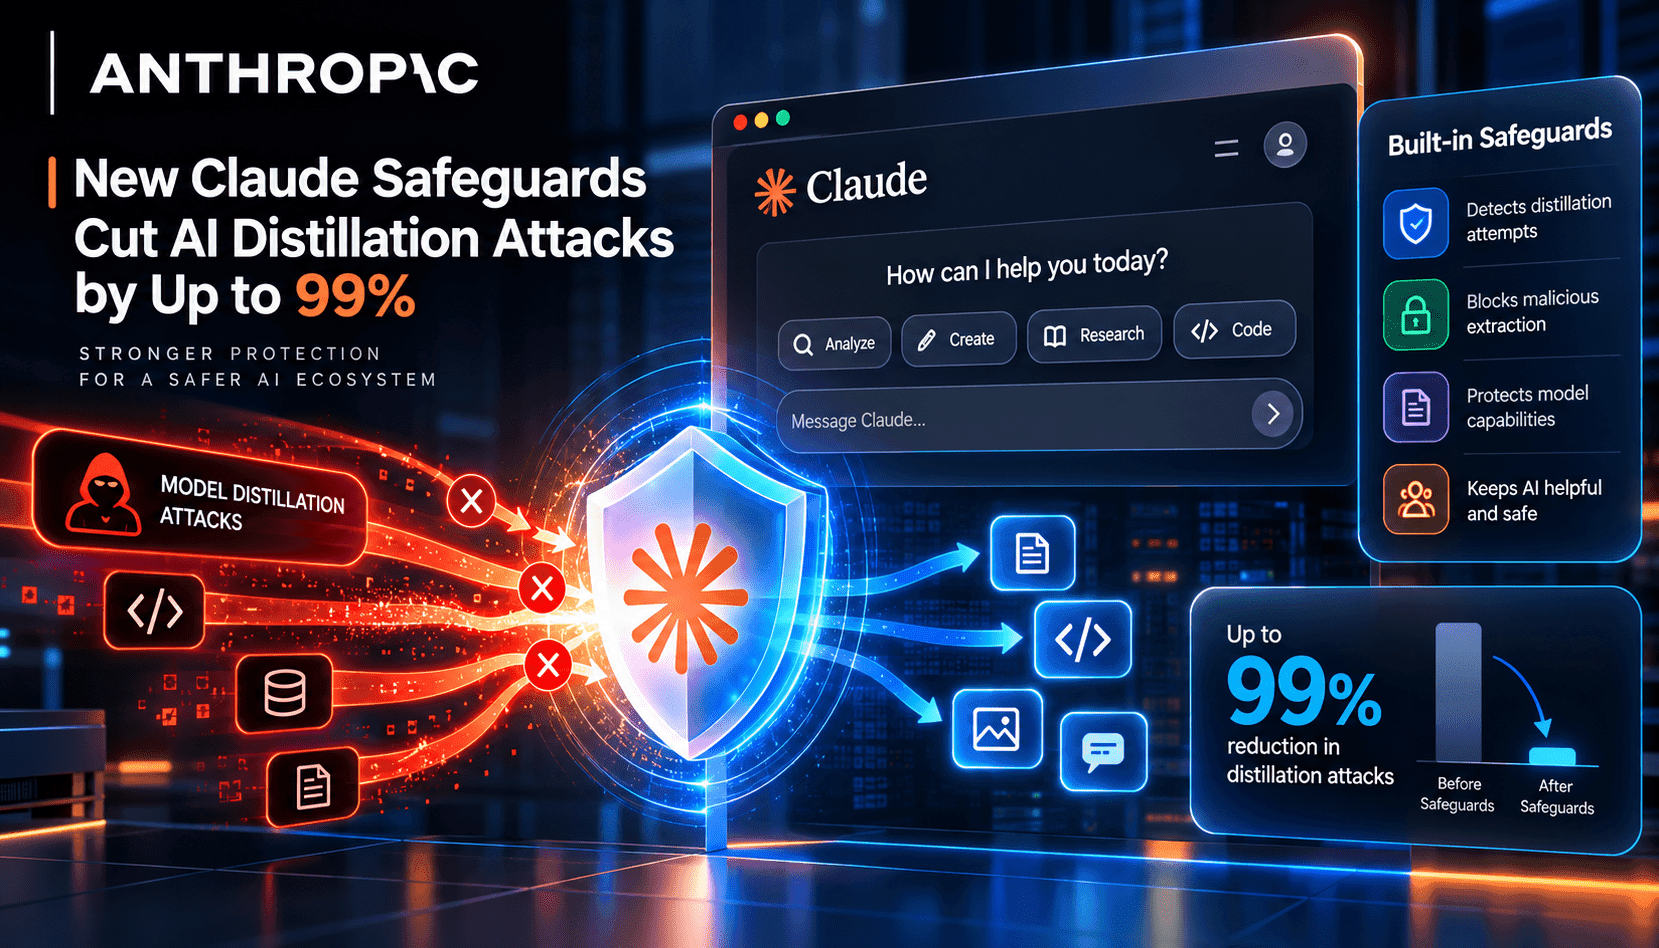
Anthropic zufolge reduzieren neue Schutzmaßnahmen für Claude das Abschöpfen von Reasoning-Tokens zur Modelldestillation um etwa 90 bis 99 %. Diese Analyse erklärt, was Destillation bedeutet, welche technischen Gegenmaßnahmen Anthropic eingeführt hat und welche Zielkonflikte bei Erkennung und Richtlinien entstehen. Außerdem zeigt sie, wie Gründer, Plattformbetreiber und Sicherheitsteams geistiges Eigentum schützen und zugleich Forschungsoffenheit und API-Zugang ermöglichen können.

NexusAI Editorial Desk16. Okt. 20262.0K Aufrufe8 Min. Lesedauer
Anthropic: Claude-Schutzmaßnahmen senken Angriffe zur Modelldestillation um bis zu 99 %
AI-Briefing

Anthropic berichtet, nach der Einführung mehrerer Schutzmaßnahmen gegen Destillation deutlich weniger „Reasoning-Tokens“ von Claude preiszugeben. Das Unternehmen gibt an, dass 90 bis 99 % weniger Reasoning-Tokens abgeschöpft werden und die Falsch-Positiv-Rate unter 0,1 % liegt. Zudem hat es öffentlich einen mutmaßlichen Destillationsversuch im Entwicklungsprozess von GLM-5.3 eines anderen Labors benannt. Der Beitrag erklärt die Funktionsweise der Modelldestillation und die konkreten Schutzmaßnahmen, die Anthropic nach eigenen Angaben einsetzt – Zugangsbeschränkungen, Proxy-Erkennung, Drosselung koordinierter Abfragen und Kontosperrungen. Außerdem bewertet er Belege und Grenzen und erläutert die praktischen Folgen für API-Richtlinien, Wettbewerbsforschung und die Sicherheitslage von KI-Anbietern und ihren Kunden.

Anthropics Ankündigung macht ein wachsendes Problem für Anbieter führender KI-Modelle deutlich: groß angelegte Destillationskampagnen, die darauf abzielen, die privaten Reasoning-Spuren eines Modells abzuschöpfen und in konkurrierende Systeme zu übertragen. Bei dieser Form der Destillation geht es weniger darum, die Modellgröße zu reduzieren, als vielmehr darum, die Schritt-für-Schritt-Reasoning-Tokens abzugreifen, die ein Modell beim schrittweisen Schlussfolgern ausgibt. Anthropic zufolge reduzieren die neuen Schutzmaßnahmen die Zahl abgeschöpfter Reasoning-Tokens in überwachten Tests um etwa 90 bis 99 %. Für Betreiber und Kunden ist das relevant, weil in Reasoning-Spuren wertvolle emergente Fähigkeiten und Ergebnisse des Prompt-Engineerings sichtbar werden – und sich dort geistiges Eigentum sowie potenzielle Dual-Use-Risiken konzentrieren.

Als Wettbewerbsmethode setzt Destillation technisch auf systematische Abfragen, mit denen Modelle dazu gebracht werden, Zwischenschritte ihres Reasonings, Chain-of-Thought oder wichtige Hinweise preiszugeben, die anschließend in eine nachgelagerte Trainingspipeline einfließen können. Angreifer können Millionen von Prompts automatisieren, sie über Proxy-Netzwerke oder Kontofarmen leiten und die Ausgaben zu Datensätzen zusammenfügen. Ziel ist es, Fähigkeiten nachzubilden, ohne Zugriff auf Trainingsdaten oder Modellgewichte zu haben. Anthropics Einordnung macht deutlich, warum große KI-Labore das massenhafte Abschöpfen von Reasoning inzwischen sowohl als Angriff auf geistiges Eigentum als auch als sicherheitspolitisch relevantes Risiko betrachten: Die Ausgaben können konkurrierenden Modellen ermöglichen, höher entwickelte Verhaltensweisen nachzuahmen, ohne dass dafür vergleichbare Investitionen in Forschung und Entwicklung nötig sind.

Anthropic nennt mehrere eingeführte Schutzmaßnahmen: den Zugang zu geschütztem Reasoning beschränken, Proxy-Nutzung und koordinierte Abfragemuster algorithmisch erkennen, Abschöpfungsverhalten automatisch drosseln und blockieren sowie gezielt Konten sperren, die mit Destillationskampagnen in Verbindung stehen. Das Unternehmen gibt außerdem an, dass die systemweite Falsch-Positiv-Rate unter 0,1 % liegt. Zusammengenommen verbinden diese Maßnahmen Verhaltensanalysen, Richtlinienvorgaben und die Durchsetzung auf der Plattform. Für Unternehmenskunden der API und Plattformarchitekten stellt sich vor allem die Frage nach den Zielkonflikten: Wie lässt sich missbräuchliches Abschöpfen begrenzen, ohne legitime Forschung, Entwicklertests und Fine-Tuning-Workflows zu behindern?

Anthropic wirft Z.ai vor, bei der Entwicklung von GLM-5.3 versucht zu haben, die Fähigkeiten von Claude zu destillieren. Dieser Vorwurf wirft ernsthafte Wettbewerbs- und Rechtsfragen auf. Die öffentliche Zuschreibung verschärft die Dynamik des Wettrüstens: Labore werden ihre Schutzmaßnahmen öffentlich stärken und im Hintergrund ausgefeiltere Erkennungssysteme einsetzen, während Angreifer Proxys, langsame und unauffällige Abschöpfung sowie synthetische Prompt-Verschleierung weiterentwickeln. Der Streit setzt auch die Branchenstandards für verantwortungsvolle Forschung unter Druck: Welche Experimente sind legitim, welche missbräuchlich, und wann sollten unabhängige Prüfungen durch Dritte oder gemeinsame Regeln greifen?

Für alle, die Modelle entwickeln oder einkaufen, gibt es zwei zentrale praktische Erkenntnisse. Erstens müssen Plattformen von Anfang an Telemetrie zur Erkennung von Abschöpfungsversuchen und klare API-Bedingungen vorsehen, die zulässiges Forschungsverhalten und Schwellenwerte für die automatisierte Erkennung von Missbrauch festlegen. Zweitens müssen Produkt- und Sicherheitsteams auf Fehlalarme und Konflikte mit legitimer Forschung vorbereitet sein: Es braucht Abhilfewege, Einspruchsverfahren und Zugangsstufen für Forschende, damit Innovation nicht ausgebremst wird und zugleich geistiges Eigentum sowie die Sicherheit nachgelagerter Anwendungen geschützt sind.

Wichtigste Erkenntnisse

Reasoning-Tokens sind eine wertvolle Angriffsfläche

Zwischenausgaben des Chain-of-Thought können abgeschöpft werden, um konkurrierende Modelle zu trainieren. Ihr Schutz trägt dazu bei, Fähigkeitsvorsprünge und den Wert geistigen Eigentums zu erhalten.

Schutzmaßnahmen müssen Telemetrie, Richtlinien und menschliche Prüfung verbinden

Automatisierte Erkennung und Drosselung sind notwendig, reichen aber nicht aus. Einspruchsmöglichkeiten, spezielle Forschungszugänge und Prüfprozesse für Ermittler verringern Fehlalarme und betriebliche Reibungsverluste.

Branchenstandards und Verträge bestimmen, wie offen die Zukunft ist

Klare API-Bedingungen, überprüfte Forschungsprogramme und mögliche behördliche Leitlinien sind nötig, um Sicherheit, Innovation und Wettbewerb in Einklang zu bringen.

Was Anthropic geändert hat: konkrete Schutzmaßnahmen

Anthropics Maßnahmen scheinen Richtlinienbeschränkungen mit signalbasierter Erkennung zu kombinieren. Laut Unternehmensbeschreibung wird der Zugriff auf geschütztes Reasoning auf strengere API-Tarife beschränkt und durch Abfragelimits sowie gegen Paraphrasierungen resistente Zugangskontrollen geschützt. Bei der Erkennung weisen Telemetriedaten auf Proxy-IP-Pools, wiederkehrende semantische Prompt-Strukturen und koordinierte Aktivitäten über mehrere Konten hin. Zusammen mit automatischer Drosselung und Kontosperrungen sollen diese Maßnahmen massenhafte Abschöpfungsketten eindämmen. Entscheidend ist, dass die Abwehr Destillation als verteiltes Missbrauchsmuster behandelt, das sich nur anhand korrelierter Signale erkennen lässt – nicht bloß anhand von Heuristiken für einzelne Anfragen.

Wie Modelldestillation funktioniert und warum Reasoning-Tokens wichtig sind

Bei der Destillation zur Nachbildung von Fähigkeiten geht es darum, Zwischenergebnisse des Reasonings zu extrahieren – etwa Chain-of-Thought, Begründungen oder strukturierte Schritt-für-Schritt-Antworten. Diese Tokens enthalten Verhaltensabkürzungen und latente Strategien zur Problemlösung. Abgeschöpfte Reasoning-Tokens lassen sich zu Trainingsdatensätzen zusammenstellen, mit denen ein kleineres Modell oder ein Modell mit anderer Architektur diese Verhaltensweisen nachahmen lernt. Dadurch sind Reasoning-Tokens deutlich wertvoller als oberflächliche Antworttexte. Für die Abwehr besteht die Herausforderung darin, legitime erklärende Ausgaben von solchen zu unterscheiden, die systematisch zu Trainingszwecken abgeschöpft werden.

Erkennungsmethoden und bekannte Grenzen

Die Erkennung beruht auf der Zusammenführung verschiedener Telemetriedaten: Netzwerkmuster (Proxy-Pools, ungewöhnliche ASNs), Anfrageformen (vorlagenbasierte Prompts, abgestufte Umformulierungen), Zeitmuster (hohes Volumen in gleichmäßigen Abständen) und Kontohistorie (verknüpfte KYC- oder Gerätesignale). Anthropics Angabe einer Falsch-Positiv-Rate von <0,1 % deutet auf konservative Schwellenwerte und sorgfältige Abstimmung hin. Solche Systeme können jedoch langsam durchgeführte Kampagnen, gegnerische Prompt-Verschleierung oder ausgeklügelte Umleitungen über Drittanbieter übersehen. Betreiber sollten automatisierte Blockierungen daher mit Prüfprozessen für Ermittler und Einspruchsmöglichkeiten für Forschende verbinden, um Grenzfälle zu bearbeiten und Betriebsstörungen zu verringern.

Richtlinien, Recht und Forschungsnormen: die größeren Zielkonflikte

Die Beschränkung von Reasoning-Tokens wirft schwierige politische Fragen auf. Strengere Zugangskontrollen erschweren unabhängige Forschung und die Reproduzierbarkeit, erleichtern aber den Schutz geistigen Eigentums. Die öffentliche Benennung mutmaßlicher Täter verschärft den Wettbewerbsdruck und kann die Zusammenarbeit hemmen. Branche, Förderorganisationen und Aufsichtsbehörden müssen klären, welche Formen des Reverse Engineering zulässig sind, welche Wege für verantwortungsvolle Offenlegung bestehen und wann eine öffentliche Zuschreibung angemessen ist. Für Hochschulen und unabhängige Forschende könnten ausdrücklich geregelte Safe-Harbor-Kanäle oder überprüfte Forschungszugänge legitime Untersuchungen ermöglichen, ohne eine umfassende Abschöpfung von Fähigkeiten zu begünstigen.

Praktische Schritte für Kunden, Betreiber und Investoren

Kunden sollten von Anbietern Auskunft über Maßnahmen gegen Modell-Extraktion und den Umgang mit Fehlalarmen verlangen. Betreiber sollten ihre Telemetrie für die Erkennung koordinierter Anfragen auslegen und Einspruchswege für markierte Nutzer einrichten. Produktteams sollten abgestufte Zugangsklassen und Datenverträge gestalten, die Training durch Destillation ausdrücklich untersagen. Investoren, die führende KI-Labore bewerten, sollten Schutzmaßnahmen und das Risikomanagement der Plattform als Wettbewerbsvorteile berücksichtigen – zugleich aber mögliche rechtliche Folgen falsch zugeschriebener Vorwürfe im Blick behalten. Investitionen in Schutzmaßnahmen werden zunehmend in Bewertungen und Vertragsverhandlungen einfließen.

Häufig gestellte Fragen

Wie verlässlich ist Anthropics Aussage, dass die Schutzmaßnahmen die Extraktion um bis zu 99 % reduzieren?

Die viel zitierte Zahl weist auf eine erhebliche Eindämmung in den getesteten Szenarien hin. Eine unabhängige Überprüfung ist jedoch nötig, da die Wirksamkeit der Erkennung vom jeweiligen Bedrohungsmodell abhängt. Die Kennzahlen können je nach Fähigkeiten des Angreifers, Proxy-Nutzung und Kampagnen mit geringem Anfragevolumen variieren. Betreiber sollten Anbieterangaben als Fortschrittsnachweis, nicht als Garantie verstehen und nach Möglichkeit transparente Messverfahren sowie Ergebnisse von Red-Team-Tests verlangen.

Werden strengere Maßnahmen gegen Destillation legitime akademische Forschung blockieren?

Das ist möglich, sofern Anbieter keine formellen Forschungszugänge mit geprüften Nachweisen, Auditierbarkeit und Vereinbarungen zur Datennutzung schaffen. Praktische Lösungen sind begrenzte Abfragen, synthetische Testumgebungen, die Reasoning-ähnliches Verhalten ohne sensible Ausgaben zeigen, sowie beschleunigte Einspruchs- oder Freigabeverfahren für legitime Forschungsprojekte.

Was sollten Plattformkunden jetzt von Modellanbietern verlangen?

Kunden sollten Offenlegung der Richtlinien gegen Modell-Extraktion, Angaben zu Falsch-Positiv-Raten und Abhilfeverfahren, Vertragsklauseln gegen das Training Dritter mit destillierten Daten sowie die Bereitschaft zur Zusammenarbeit bei Zuschreibung und Reaktion auf Sicherheitsvorfälle verlangen. Darüber hinaus helfen technische SLAs zur Aufbewahrung von Telemetriedaten und Prüfungsrechte dabei, das eigene Risiko einzuschätzen.

#Modellextraktion im Industriemaßstab#KI-Modell-Extraktion#Modell-Destillation#Modell-Destillation & Kompression#Grenzmodell-Sicherheit#Frontier Modellrisiko#Modellsicherungen#Strategie für den Modellzugriff#richtlinienbasierter Modellzugriff#Governance für Frontier-Modelle#Grenzmodelle#Diebstahl von Schlussfolgerungen#API-Zugriffsrichtlinie#Sicherheit für Frontier-KI#Distillationserkennung

AI-Insight-Newsletter

Erhalten Sie die neuesten AI-Updates, Tool-News und Einblicke direkt in Ihren Posteingang.

Kein Spam. Jederzeit abbestellbar.
Auf dieser Seite
1.Was Anthropic geändert hat: konkrete Schutzmaßnahmen2.Wie Modelldestillation funktioniert und warum Reasoning-Tokens wichtig sind3.Erkennungsmethoden und bekannte Grenzen4.Richtlinien, Recht und Forschungsnormen: die größeren Zielkonflikte5.Praktische Schritte für Kunden, Betreiber und Investoren
Diesen Artikel teilen

Ähnliche Artikel

ServiceNows AI Passport: Eine Runtime-Autoritätsebene für Unternehmensagenten
AI-Produktnews

ServiceNows AI Passport: Eine Runtime-Autoritätsebene für Unternehmensagenten

17. Okt. 2026

Googles nachweislich vertrauliches Federated Learning für Gboard: Wie TEEs, Transparenzprotokolle und DP zusammenspielen
KI-Modell- & Plattform-Updates

Googles nachweislich vertrauliches Federated Learning für Gboard: Wie TEEs, Transparenzprotokolle und DP zusammenspielen

5. Okt. 2026

MorningAI’s Multi-Model Agents Fügen GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 und Grok 4.7 Hinzu – Mit Integrierter Sanity CMS Veröffentlichung
AI-Produktnews

MorningAI’s Multi-Model Agents Fügen GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 und Grok 4.7 Hinzu – Mit Integrierter Sanity CMS Veröffentlichung

28. Sept. 2026

Alibaba’s AgentCore vereint Multi-Modell-Agenten mit MCP-Tools und Unternehmenssteuerung
AI-Produktnews

Alibaba’s AgentCore vereint Multi-Modell-Agenten mit MCP-Tools und Unternehmenssteuerung

27. Sept. 2026

Genesis AI’s Eno setzt auf Räder statt Beine für einen vielseitigen physischen Agenten
AI-Produktnews

Genesis AI’s Eno setzt auf Räder statt Beine für einen vielseitigen physischen Agenten

25. Sept. 2026

Zugehörige AI-Tools

Alle anzeigen
Claude von Anthropic: KI-Modelle, Agenten und Sicherheitsplattform auf Spitzenniveau

Claude von Anthropic: KI-Modelle, Agenten und Sicherheitsplattform auf Spitzenniveau

KI-Assistenten & Agenten