

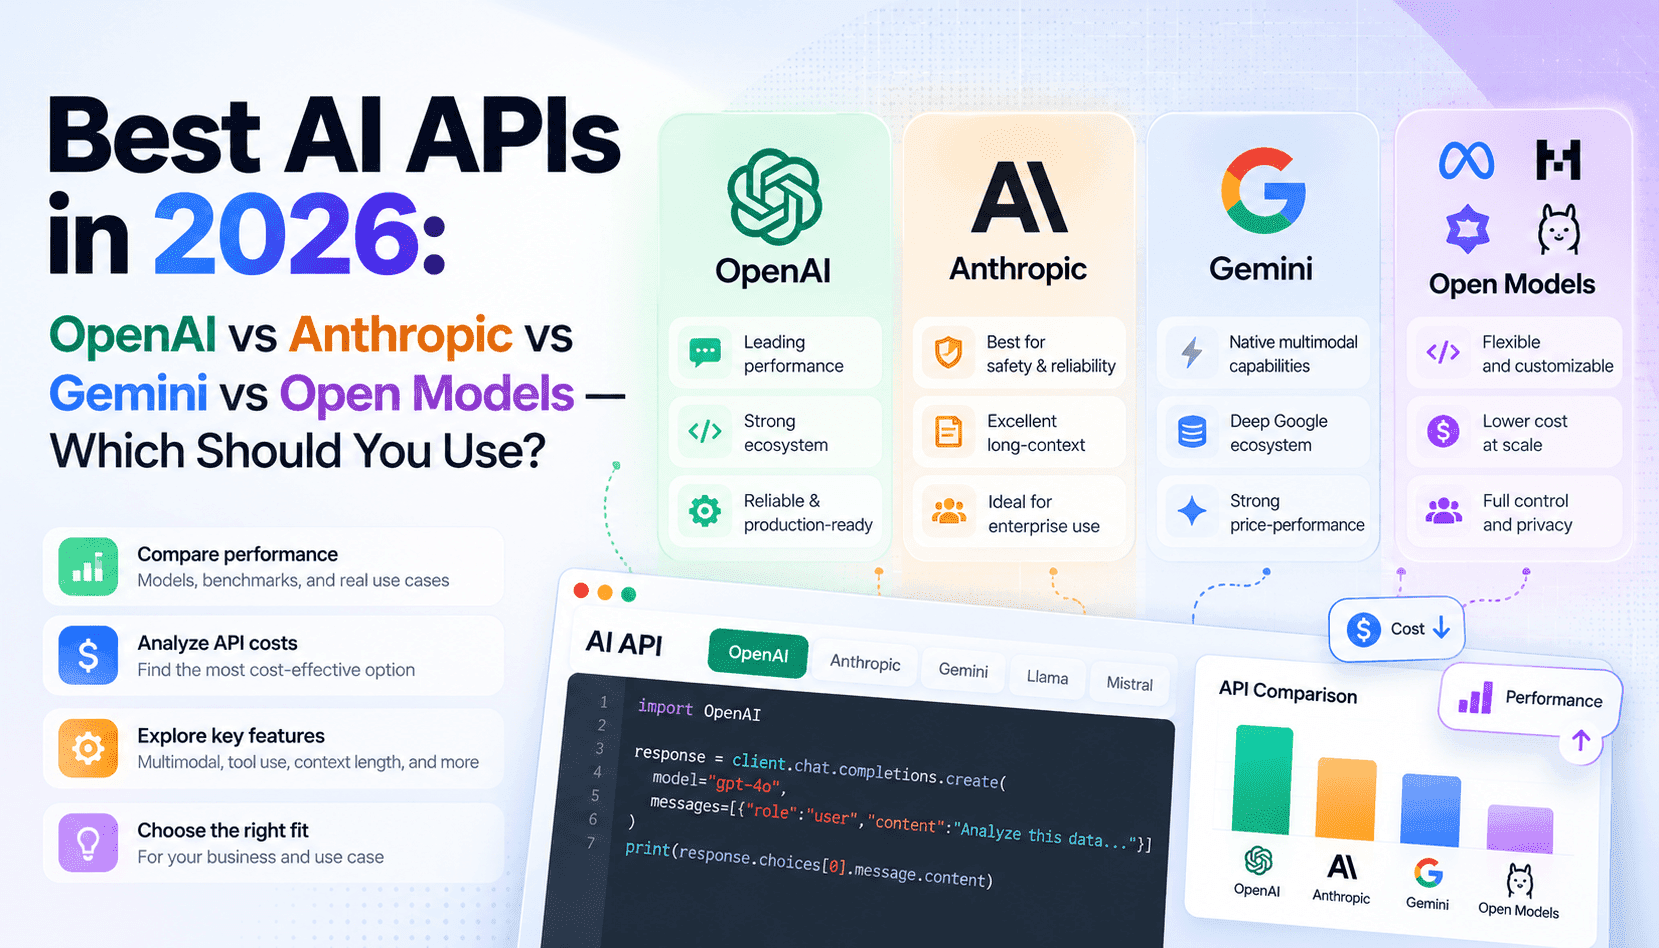
Die Auswahl einer KI-API im Jahr 2026 fühlt sich weniger danach an, einen einzigen Sieger zu küren, als vielmehr danach, die jeweiligen Workloads mit den wirtschaftlichen und technischen Anforderungen des eigenen Produkts in Einklang zu bringen. Der Markt gliedert sich inzwischen in mehrere praxisrelevante Gruppen: geschlossene APIs mit kontinuierlich aktualisierten Hochleistungsmodellen (OpenAI, Anthropic, Gemini), große Modelle mit offenen Gewichten, die sich für mehr Kontrolle und Datenschutz selbst hosten lassen, sowie Multi-Modell-Gateways, die für eine optimale Kombination aus Kosten und Leistungsfähigkeit zwischen Anbietern routen. Jede Option verlagert den Aufwand zwischen Entwicklung, Compliance und Betrieb. Welche die richtige ist, hängt von Ihren Latenzzielen, Datenschutzvorgaben und davon ab, ob deterministisches Modellverhalten oder maximale Schlussfolgerungsqualität Vorrang hat.
Aus Sicht technischer Entscheider sollte die Bewertung anhand klarer Kriterien erfolgen und auf konkreten Experimenten beruhen. Führen Sie kleine, repräsentative Benchmarks durch: Few-Shot-Aufgaben zum logischen Schlussfolgern für Produktlogik, echte Code-Umschreibungen für Entwicklertools, multimodale Prompts für Dokumenten- und Bildverarbeitung sowie Tests strukturierter Ausgaben für die Übernahme in Datenbanken. Messen Sie nicht nur die Qualität, sondern auch die Kosten pro nutzbarem Token, die P95-Latenz bei synchronen Abläufen, den Batch-Durchsatz für Offline-Aufträge und das Verhalten bei Ausfällen unter schlechten Netzwerkbedingungen. Fassen Sie diese Signale zu einem „Abnahmeschwellenwert“ pro Workload zusammen und wählen Sie den günstigsten Anbieter, der Ihr SLA erfüllt.
Betriebliche Aspekte sind ebenso entscheidend wie die Modellgenauigkeit. Die Bindung an einen Anbieter zeigt sich oft schleichend: Proprietäre Tool-Integrationen, spezielle Semantiken für Function Calling oder geschlossene Audit-Funktionen können den Start erleichtern, spätere Migrationen jedoch erschweren. Modelle mit offenen Gewichten bieten maximale Kontrolle über den Speicherort der Daten und die Inferenzkosten. Dafür übernehmen Ihre Infrastrukturteams die Verantwortung für Skalierung, Sicherheitsupdates und Zuverlässigkeit. Multi-Modell-Gateways und Modell-Router bringen zusätzliche Abstraktion und Komplexität mit sich, ermöglichen aber eine Kombination aus günstigeren Basismodellen und einem hochwertigen Fallback. So lassen sich kurzfristige Stückkosten gegen langfristigen Entwicklungsaufwand abwägen.
Dieser Artikel bietet eine pragmatische Entscheidungsmatrix, Einsatzszenarien und einen Betriebsleitfaden – mit Modell-Routing, Fallback-Strategien, Observability-Signalen und Methoden zur Kostenüberwachung. So können Teams eine modulare Architektur einführen. Ziel ist nicht, einen einzelnen Anbieter zu empfehlen, sondern einen wiederholbaren Prozess zu vermitteln: Anforderungen für Workloads definieren, gezielte Evaluierungen durchführen, die einfachste passende Architektur wählen und den Stack so gestalten, dass ein Anbieterwechsel zur betrieblichen Konfiguration wird statt zu einem kostspieligen Neuaufbau.