

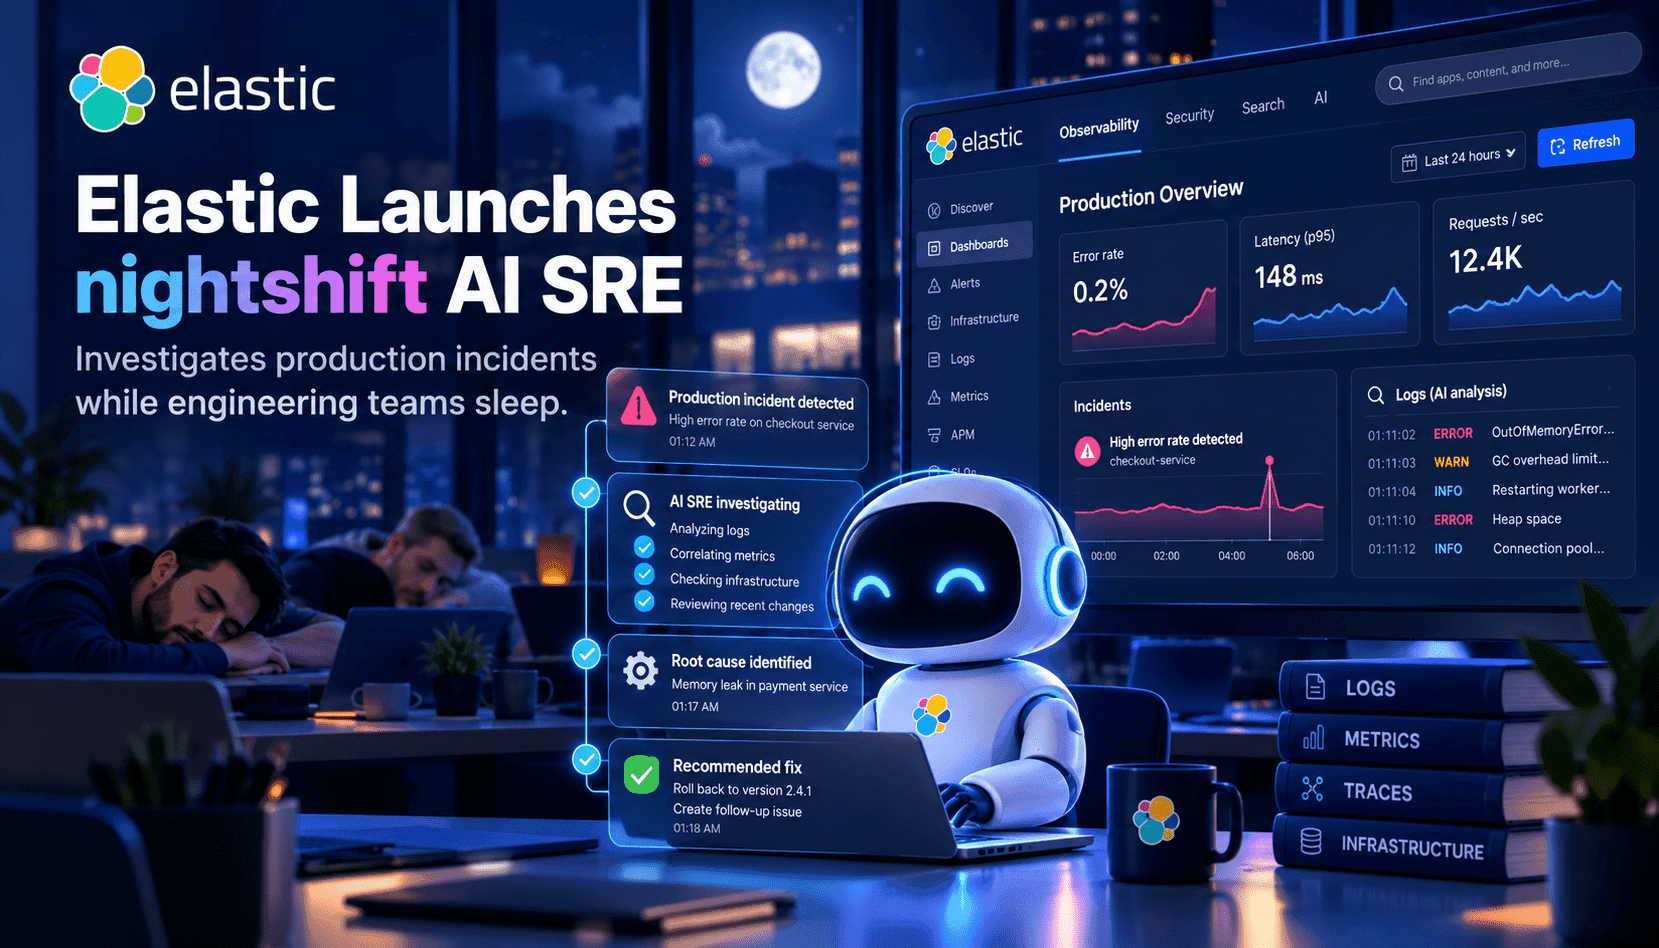
Elastics neuer Nightshift AI SRE setzt einen autonomen Agenten an die vorderste Front der Zuverlässigkeit: Statt darauf zu warten, dass ein Mensch Dashboards abfragt, überwacht der Agent kontinuierlich Logs, Metriken, Traces und Kontextdaten, um Anomalien zu erkennen, Vorfälle zu priorisieren und Belege zusammenzutragen. Der praktische Nutzen zeigt sich sofort: Wird ein Engineer alarmiert, kann die Untersuchung bereits strukturiert beginnen – mit korrelierten Ereignissen, wahrscheinlichen Ursachen und vorgeschlagenen Behebungsschritten. Diese Vorarbeit grenzt den Suchbereich ein und verkürzt den aufwendigsten Teil der Reaktion auf Vorfälle: sich in unübersichtlichen, verteilten Telemetriedaten zurechtzufinden.
Technisch beruht Nightshift auf drei ineinandergreifenden Fähigkeiten: einer umfassenden Erfassung und Abfrage von Logs, Metriken und Traces, einem Kontextspeicher, der Runbooks und Topologie mit Telemetriedaten verknüpft, sowie agentengestützter Schlussfolgerung, die Lese-, Synthese- und Handlungsschritte aufeinander abstimmt. Elastics Stack bietet bereits leistungsstarke Möglichkeiten zur Datenerfassung und Suche. Der entscheidende Schritt besteht darin, diese Funktionen in dauerhaft aktive Agenten zu bündeln, die über Stunden hinweg ihren Zustand beibehalten und nur dann eskalieren, wenn menschliches Urteilsvermögen gefragt ist. Damit verändert sich, wie Observability-Daten aufbereitet, priorisiert und bereitgestellt werden: Agenten werden zu aktiven Nutzern und Kuratoren der Telemetriedaten – nicht zu passiven Betrachtern von Dashboards.
Im Betrieb verkürzen kontinuierliche Agentenuntersuchungen die mittlere Zeit bis zur Erkennung und Behebung, indem sie die Suche nach Ursachen und die Korrelation von Ereignissen fortlaufend übernehmen. Nightshift kann Logs zusammentragen, eine Ereigniszeitleiste erstellen, Hypothesen anhand historischer Vergleichswerte überprüfen und abgesicherte Behebungsschritte ausführen, etwa Circuit Breaker aktivieren, den Log-Level ändern oder einen sicheren Failover auslösen. Der Nutzen des Modells hängt jedoch von vertrauensbildenden Maßnahmen ab: testbaren Playbooks, transparenter Herkunftsdokumentation für Agentenaktionen und klaren Eskalationsgrenzen. So behalten Teams die Verantwortung und profitieren zugleich von automatisierter Arbeit außerhalb der Geschäftszeiten.
Für Engineering-Leitungen und SREs, die Agenten nach dem Nightshift-Prinzip bewerten, stellen sich zunächst ganz praktische Fragen: Wie werden Runbooks eingebunden? Welche Qualität müssen die Telemetriedaten haben? Wie werden Rollback- und Begrenzungen des Wirkungsradius durchgesetzt? Und wie lässt sich der ROI messen? Pilotprojekte sollten sich auf klar eingegrenzte Vorfalltypen konzentrieren – etwa Speicherlecks, übermäßige Wiederholungsversuche oder Ausfälle externer Abhängigkeiten –, bei denen die Korrelationsregeln eindeutig sind und sichere Behebungsschritte zur Verfügung stehen. Zu den Erfolgskriterien sollten weniger unnötige Weckrufe, eine kürzere Zeit bis zur Identifizierung und Behebung sowie qualitative Vertrauensbewertungen der Bereitschaftsteams gehören.