

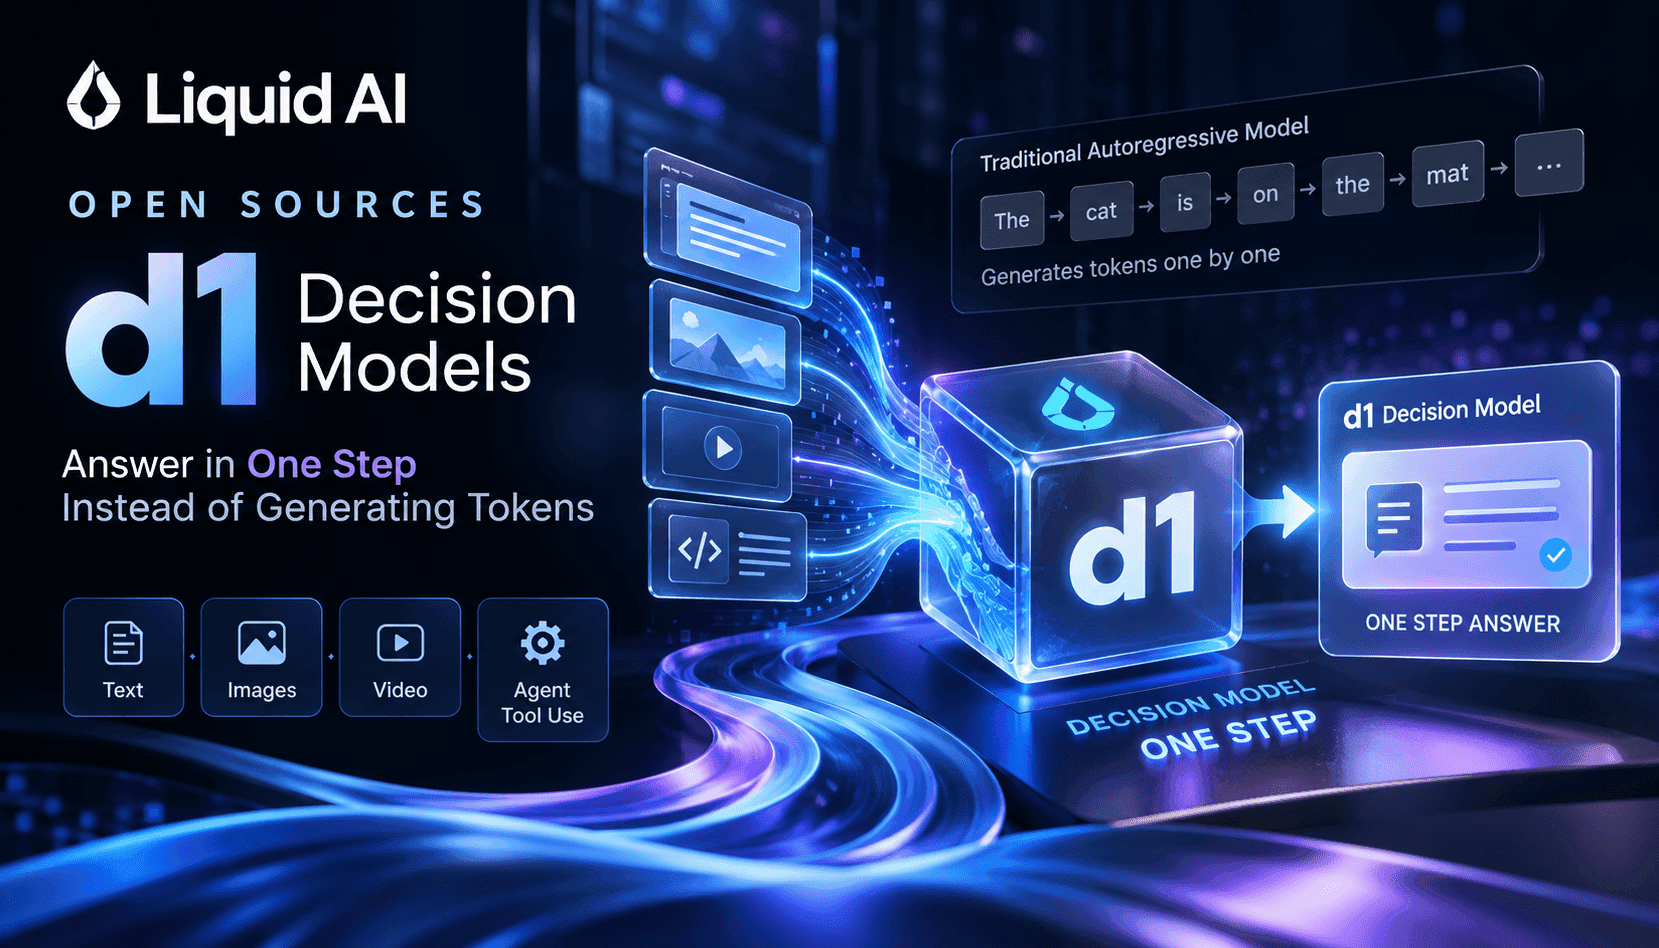
Mit der Veröffentlichung von d1 vollzieht Liquid AI einen bewussten Kurswechsel: weg von der autoregressiven Token-Generierung und hin zu Modellen, die strukturierte Entscheidungen ausgeben – kalibrierte Wahrscheinlichkeitsverteilungen über diskrete Labels in einem einzigen Forward Pass. Anders als LLMs, die Antworten Token für Token formulieren, werten diese Entscheidungsmodelle eine Eingabe aus und liefern einen kompakten Vektor mit Konfidenzwerten. Auf API-Ebene mag das subtil wirken, hat aber erhebliche Auswirkungen auf Systeme, die deterministische, schnelle und nachvollziehbare Ergebnisse statt dialogorientierter Texte benötigen.
In der Praxis sind d1-3B und d1-omni-600M für Einsatzbereiche gedacht, in denen Durchsatz und Interpretierbarkeit wichtiger sind als flüssige Textgenerierung. Ticket-Routing, Spamfilterung, Inhaltsmoderation, die Priorisierung von Fällen in der Fertigungsqualitätssicherung und industrielle Klassifizierung profitieren von einer Entscheidung in einem Schritt: Sie verkürzt den Anfragepfad, beseitigt Schwankungen beim Decoding und liefert Wahrscheinlichkeiten, die sich schwellenwertbasiert auswerten, kalibrieren und protokollieren sowie ohne zusätzliche Parsing-Schritte oder Halluzinationsrisiko an nachgelagerte Regel-Engines und Automatisierungs-Pipelines weitergeben lassen.
Für Entwickler und Produktverantwortliche bringt das konkrete operative Vorteile: Deterministische Ausgaben vereinfachen die Überwachung, reduzieren Wiederholungsversuche aufgrund von Tokenisierungsproblemen und senken die Rechenkosten, weil autoregressive Decoding-Schleifen entfallen. Für Compliance und Prüfpfade lässt sich ein Wahrscheinlichkeitsvektor samt Modellversion einfacher dokumentieren und nachvollziehen als Freitext. Die Einführung von Entscheidungsmodellen erfordert allerdings neue Evaluationsmethoden: Die Kalibrierung muss über verschiedene Produktionssegmente hinweg geprüft und für Fälle außerhalb der Trainingsverteilung ein praktikables Fallback-Verhalten festgelegt werden.
Dieser Artikel zeigt, was sich geändert hat, wie sich der Nutzen von Entscheidungen in einem Schritt messen lässt, welche Bereitstellungsmuster sich für Edge und Cloud eignen und welche Integrationsfallen es gibt. Außerdem enthält er eine kompakte operative Checkliste für Teams, die in Produktionsabläufen Lösungen zur Token-Generierung durch kalibrierte Entscheidungsmodelle ersetzen möchten.