

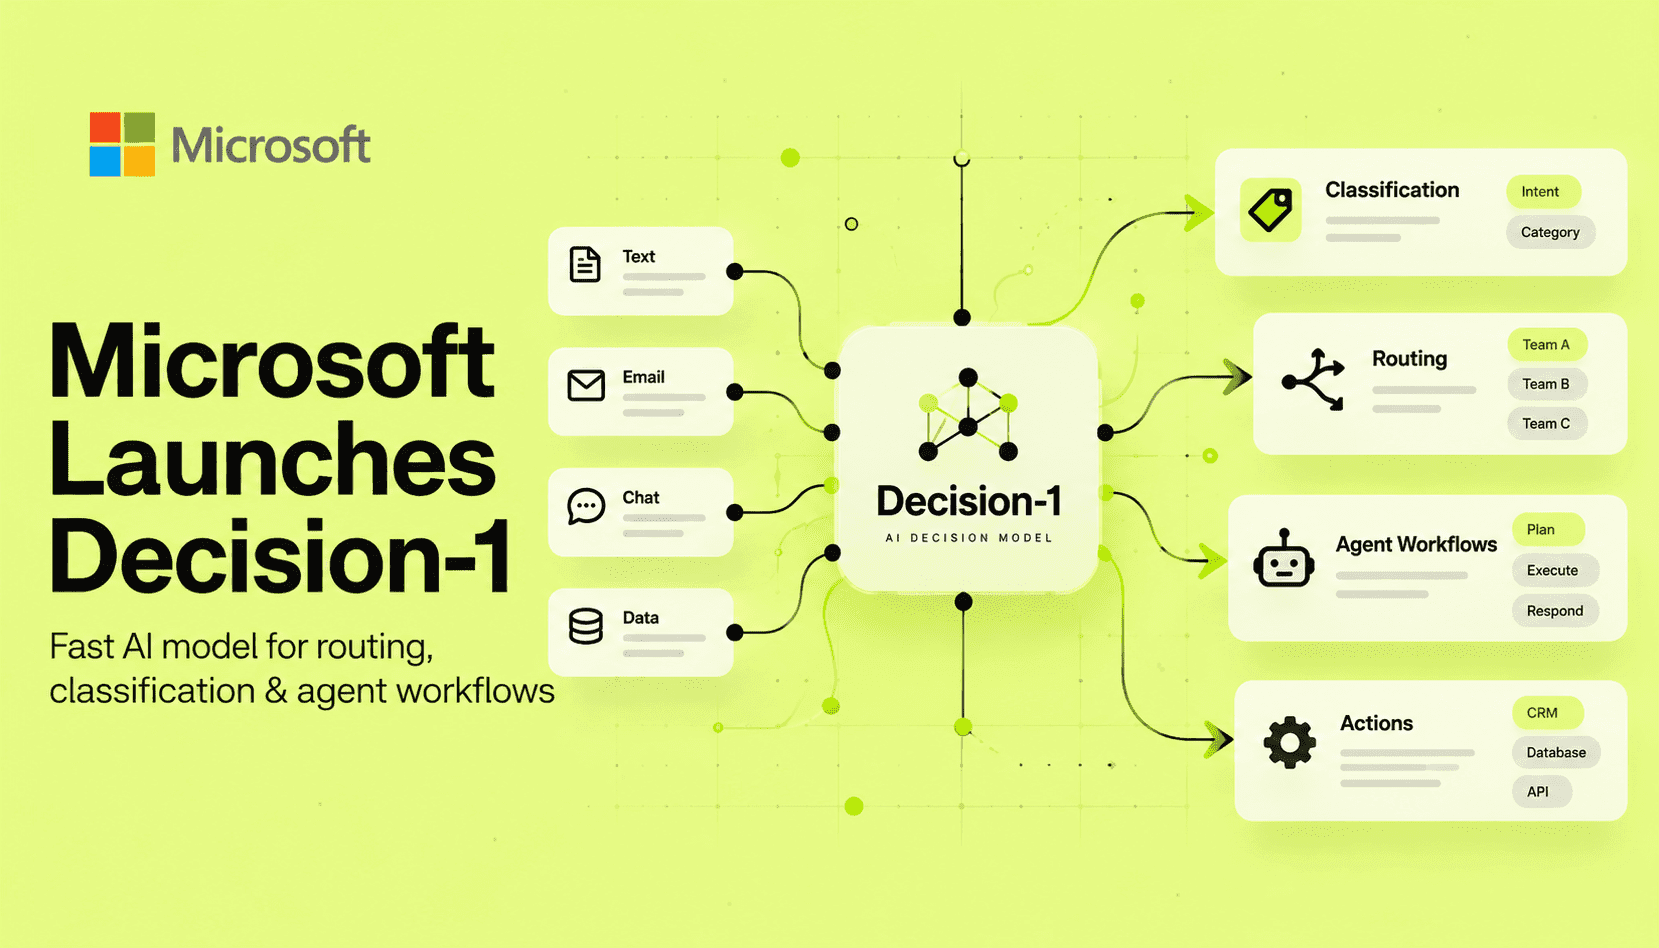
Microsoft-Decision-1 ist ein spezialisiertes Bewertungsmodell für Software, die Entscheidungen treffen muss – etwa auswählen, sortieren, klassifizieren, überprüfen oder bewerten – statt Inhalte zu generieren. Anders als universell einsetzbare LLMs, die auf flüssige Textausgabe ausgelegt sind, liefert dieses Modell strukturierte Ergebnisse und kalibrierte Wahrscheinlichkeiten in einem einzigen Vorwärtsdurchlauf. Für Produktteams ist dieser Unterschied entscheidend: Entscheidungsintensive Aufgaben werden so von teuren, langsamen LLM-Aufrufen zu kompakten, deterministischen Bewertungsschritten, die sich für Echtzeit-Agenten, Webhooks und Moderationspipelines mit hohem Durchsatz eignen.
Technisch beschreibt Microsoft das Modell als auf Qwen3.5‑9B basierend und auf Kalibrierung sowie Inferenz mit geringer Latenz optimiert. Es gibt Wahrscheinlichkeiten für vorgegebene Auswahlmöglichkeiten aus, sodass Software den Wahrscheinlichkeitsvektor direkt für Routing oder Entscheidungen anhand von Schwellenwerten nutzen kann. Dadurch entfallen zusätzliche Aufrufe eines textgenerierenden LLM ebenso wie nachgelagerte Parsing- oder Heuristikschritte. Die kalibrierten Scores aus einem einzigen Durchlauf vereinfachen außerdem die Telemetrie: Teams können Konfidenz messen, Schwellenwerte abstimmen und Schutzmechanismen einführen – ohne aufwendiges Prompt-Engineering oder mehrstufige Verifikationsketten.
Microsofts Benchmark-Ergebnisse sind bemerkenswert: Decision‑1 lag in einem Vergleich mit 36 Benchmarks bei der Genauigkeit vorn und war – besonders wichtig – deutlich schneller als generative Vergleichsmodelle. In den Tests berichtet Microsoft von einem Geschwindigkeitsvorteil um den Faktor 35 gegenüber einem GPT-6-Sol-Vergleichsmodell. Eine solche Verbesserung ist relevant, wenn Latenz, Kosten pro Inferenz und Durchsatz die Produktanforderungen bestimmen. Allerdings spielen auch Benchmark-Kontext, Hardware, Batching und die Übereinstimmung der Datensätze eine Rolle. Teams sollten daher wichtige Mikrobenchmarks auf ihrem Produktions-Stack nachstellen, bevor sie ihre Architektur ändern.
In der Praxis liegt Decision‑1 zwischen leichtgewichtigen Klassifikatoren und großen LLMs: Es ist stärker auf bestimmte Aufgaben zugeschnitten als ein kleiner Klassifikator, da es für zahlreiche Entscheidungsaufgaben trainiert und kalibriert wurde, zugleich aber deutlich günstiger und schneller als ein vollständiges generatives LLM, das erst Inhalte analysieren und anschließend entscheiden muss. Für Entwicklungsteams ergibt sich daraus eine klare Vorgehensweise: Vollständige LLM-Aufrufe ersetzen, wenn es um Auswahl, Routing, Bewertung oder Verifizierung geht, und generative LLMs für kreative Aufgaben, Zusammenfassungen oder umfangreiche Synthesen einsetzen.
Der produktive Einsatz eines Entscheidungsmodells erfordert besondere Aufmerksamkeit für Kalibrierung, Verteilungsverschiebungen und die Integration in bestehende Agenten-Toolchains. Teams sollten Konfidenzschwellen überwachen, bei Anzeichen für eine nachlassende Kalibrierung oder Datenverschiebungen auf generative LLMs zurückgreifen und Trainings- sowie Evaluierungszyklen einrichten, die das Modell auf geschäftsspezifische Klassen und Kostenanforderungen abstimmen. Richtig eingesetzt kann Decision‑1 die Latenz und Inferenzkosten senken und entscheidungsintensive Abläufe deterministischer machen.