

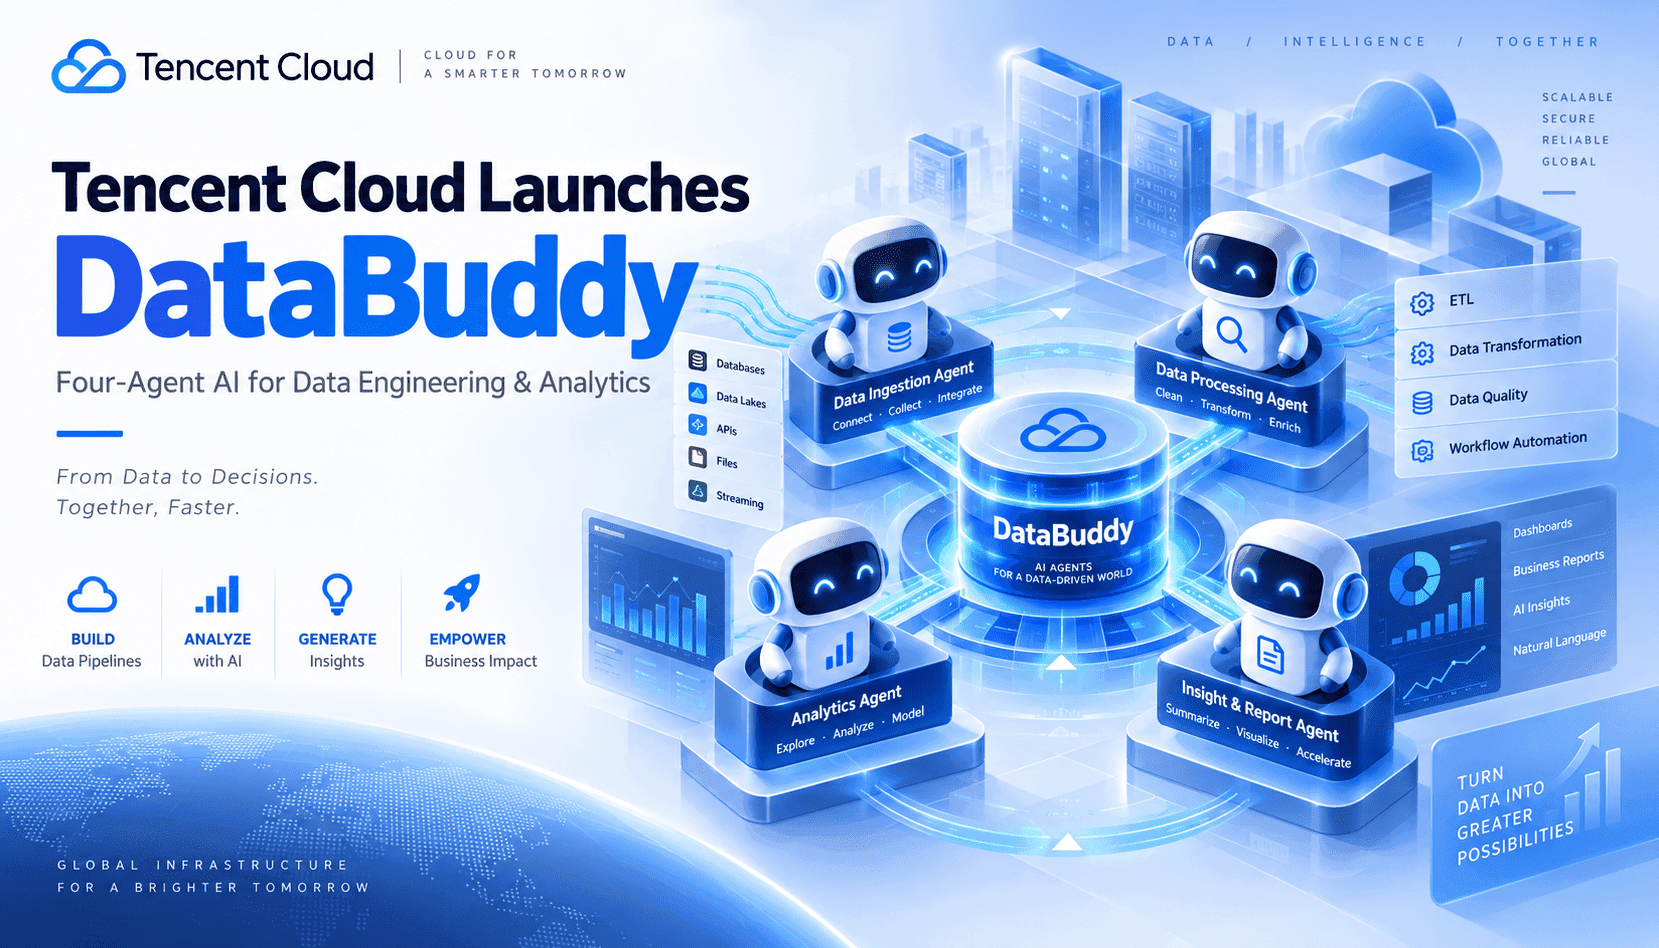
Tencent Clouds DataBuddy verpackt ein Vier-Agenten-Modell in einen Service, der das chronischste Datenproblem in Unternehmen adressiert: langsame, ticketbasierte ETL- und BI-Änderungen. Anstatt Anfragen über überlastete Ingenieure zu leiten, orchestriert DataBuddy Agenten, die Pipelines zusammenstellen, SQL schreiben und Ausgaben unter Governance-Regeln erklären. Der Ansatz ist meinungsstark, aber pragmatisch: Routinedatenarbeit wird in Agentenrollen kodifiziert, diese werden wie Services gemessen und Menschen bleiben für Zugriff, Datenschutz und Kosten in der Überprüfung. Dieser Wandel spiegelt die Entwicklung von DevOps wider – Werkzeuge, Automatisierung und Richtlinien ersetzen Heldentaten und Tabellenkalkulationen.
Im Hintergrund plant ein Agent Aufgaben, ein anderer agiert als Dateningenieur und erstellt Konnektoren, Transformationen und SQL, ein dritter fungiert als Analyst und produziert Erkenntnisse und Erzählungen, und ein vierter überprüft Qualität und Richtlinienkonformität. Diese letzte Rolle ist entscheidend: Sie prüft Schemaannahmen, Joins, Risiken von Datenlecks und PII-Exposition, bevor Ergebnisse an Dashboards oder Notebooks geliefert werden. Bei richtiger Instrumentierung erfassen Protokolle Eingaben, Entscheidungen, generierten Code und Datenherkunft, sodass Teams Ergebnisse reproduzieren, Änderungen zurückrollen und Agentenleistungen über Datensätze vergleichen können – entscheidend für Vertrauen und Audits.
Wo passt das hin? Betrachten Sie DataBuddy als eine Steuerungsebene zwischen Ihrem Lakehouse und Ihren Nutzern. Es sollte bestehende Spark/SQL-Jobs, Kostenkontrolle und Katalogtools ergänzen, nicht ersetzen. Die idealen Einsatzbereiche sind BI-Änderungen mit hohem Rückstand, Ad-hoc-Erkundungen, die dennoch Richtlinien einhalten müssen, sowie repetitive Aufgaben bei Datenaufnahme oder Datenqualität. Offene Fragen sind unternehmensrelevant: Wie bindet es sich an Identitäten, Kataloge und VPC-Netzwerke? Wie setzt es das Prinzip der minimalen Rechte auf Tabellen- und Spaltenebene durch? Und wie verteilt es Rechenressourcen, um Ausgaben zu begrenzen, ohne den Durchsatz zu drosseln?
Entscheidungsrahmen: Pilotieren Sie mit einem begrenzten Bereich (z. B. Vertriebsbetrieb oder Marketing-Attribution), einer bekannten Faktentabelle und zwei vertrauenswürdigen Dimensionen. Definieren Sie Bestehen/Nichtbestehen-Kriterien: Zeit bis zur ersten Erkenntnis, Abfragegenauigkeit im Vergleich zum Gold-SQL, erkannte Verstöße gegen Datenqualität und Kosten pro erfolgreicher Aufgabe. Leiten Sie Ausgaben an bestehende Dashboards weiter, nicht an ein neues Silosystem. Halten Sie einen menschlichen Prüfer für Richtlinienausnahmen im Prozess. Wenn der Pilot die Schwellenwerte erreicht, skalieren Sie durch Hinzufügen von Datenprodukten, nicht durch zufällige Tabellen – behandeln Sie jedes Produkt als Vertrag mit SLAs, Herkunft, Tests und Alarmen, wobei DataBuddy-Agenten die Ausführungsschicht bilden.