

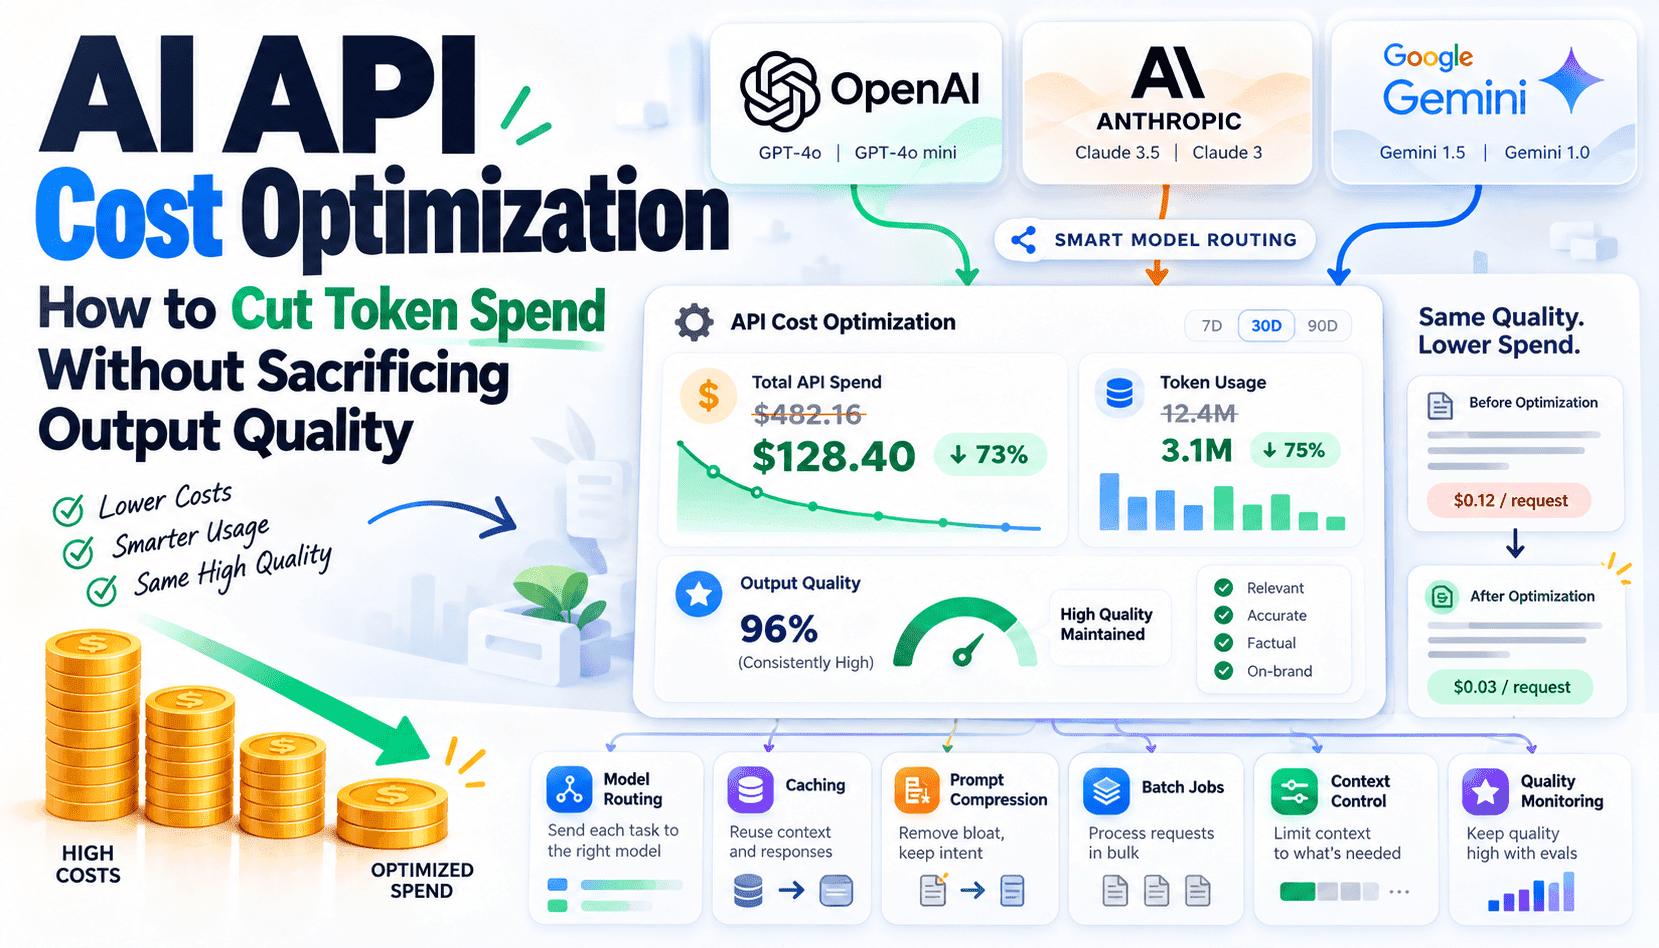
El auge de la IA generativa ha convertido el costo de los tokens en una partida importante. Si no se controla, el gasto en tokens crece con el volumen de usuarios, los contextos extensos y las respuestas sin límites. Optimizar costos no significa elegir siempre el modelo más barato, sino ajustar la capacidad del modelo a la complejidad de cada tarea, reducir los tokens innecesarios tanto en las entradas como en las salidas y modificar los flujos de trabajo para recurrir a inferencias costosas solo cuando mejoren de forma significativa los resultados del negocio. En este artículo se presentan las medidas operativas que pueden aplicar los equipos y las métricas necesarias para evaluar las ventajas y desventajas.
Empieza por crear un mapa de capacidades y enrutamiento: clasifica las solicitudes según su complejidad y la importancia de la calidad, y dirige las tareas sencillas a modelos más pequeños y económicos o a módulos deterministas. Por ejemplo, las correcciones breves, las traducciones con formato estricto o la extracción de intenciones simples suelen poder resolverse con modelos destilados o reglas heurísticas; la generación creativa de textos extensos y el razonamiento matizado en varios pasos deben reservarse para modelos más potentes. Instrumenta cada ruta para medir la tasa de éxito y los casos que requieren una alternativa, así podrás detectar cuándo fallan las opciones más económicas y escalar solo cuando sea necesario.
La ingeniería de prompts orientada al control de costos se basa en tres medidas prácticas: condensar las instrucciones sin perder significado, aprovechar al máximo el contexto del sistema compartido y reducir el contexto dinámico. Usa plantillas compactas, ejemplos few-shot numerados y esquemas estructurados de funciones para evitar instrucciones demasiado extensas. Mantén en el servidor el contexto estable del sistema y añade únicamente los elementos dinámicos nuevos. En conversaciones largas, resume en lugar de volver a enviar todos los mensajes; para tareas con muchos documentos, recupera y ordena los fragmentos más pertinentes en vez de incluir documentos completos en el prompt.
Además de optimizar los prompts, integra controles de caché, procesamiento por lotes y gestión de canalizaciones en tu stack. Una caché híbrida, semántica y de coincidencia exacta, evita repetir inferencias costosas. Agrupa las tareas de baja prioridad para procesarlas fuera de las horas punta o en entornos de cómputo más económicos. Define límites de salida y tokens de parada, y usa llamadas deterministas a funciones cuando sea posible para evitar que los modelos generen texto sin límite. Por último, adopta un marco unificado de control de costos que mida conjuntamente los tokens de entrada y salida, la tasa de aciertos de caché, la latencia y las métricas de calidad, para que las decisiones equilibren el precio con el éxito del producto.