

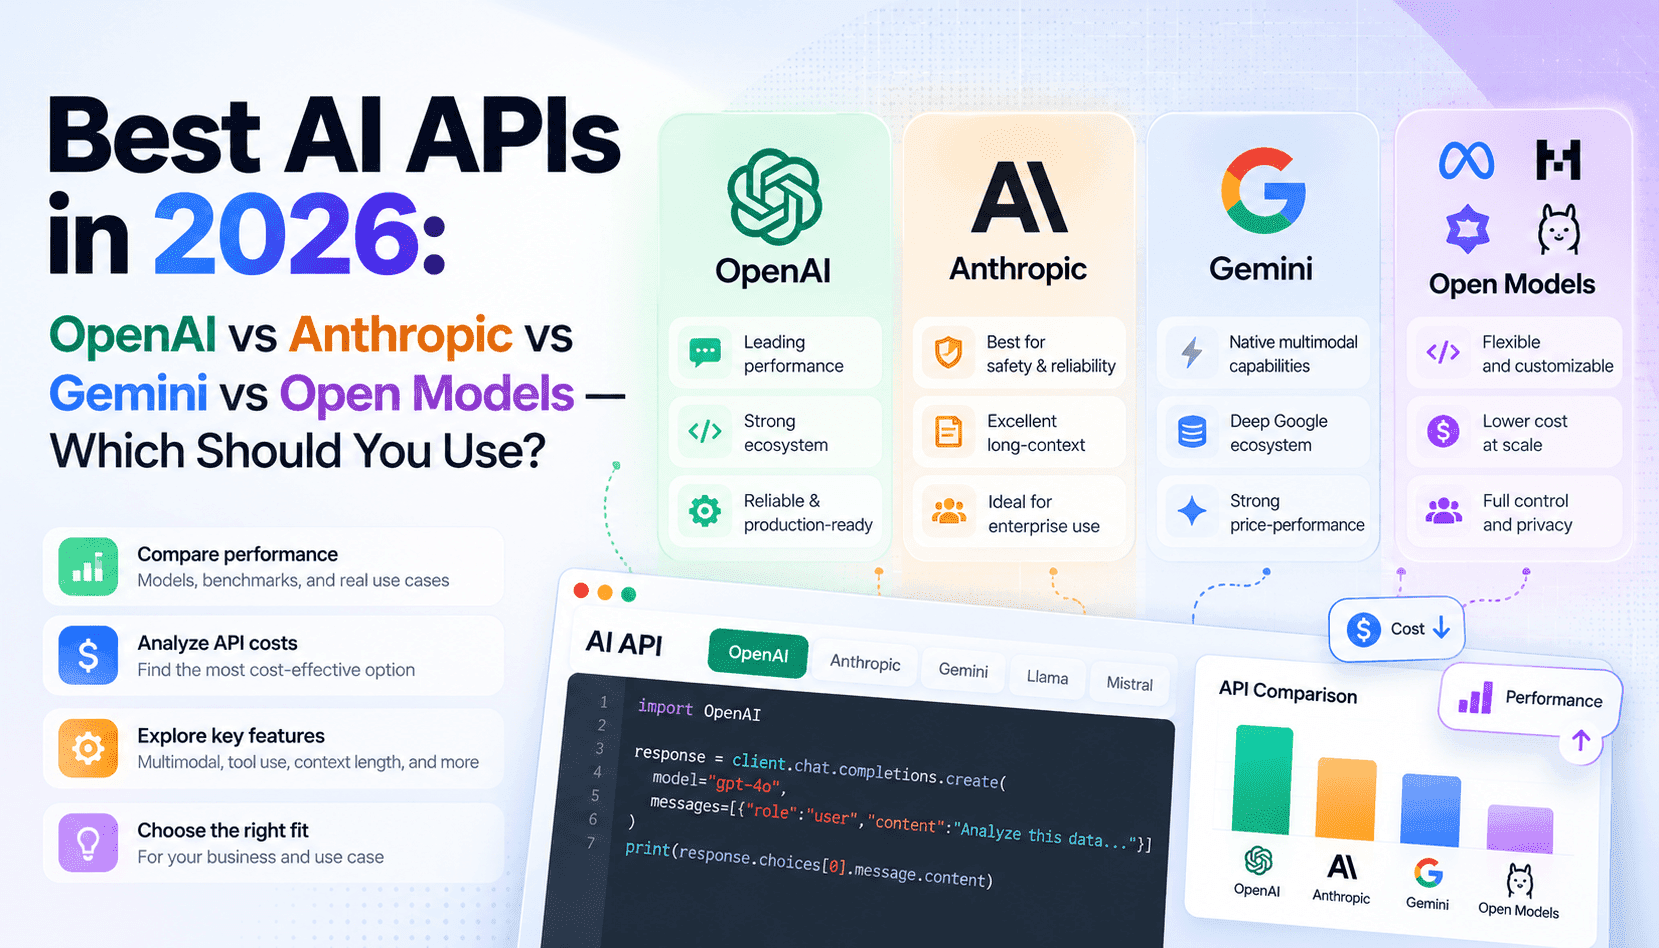
Elegir una API de IA en 2026 se parece menos a escoger un único ganador y más a adaptar cada carga de trabajo a los costes y las capacidades que importan para tu producto. El mercado se divide ahora en varias categorías prácticas: API cerradas con modelos de alto rendimiento que se actualizan continuamente (OpenAI, Anthropic, Gemini), grandes modelos de pesos abiertos que puedes alojar por tu cuenta para tener más control y privacidad, y pasarelas multimodelo que distribuyen las solicitudes entre proveedores para optimizar costes y capacidades. Cada opción implica distintos esfuerzos de ingeniería, cumplimiento normativo y operaciones; la elección adecuada depende de tus objetivos de latencia, tus requisitos de control de datos y de si priorizas la determinación de las respuestas o la máxima calidad de razonamiento.
Desde la perspectiva de un comprador técnico, la evaluación debe basarse en dimensiones concretas y centrarse en la experimentación. Ejecuta pruebas comparativas pequeñas y representativas: tareas de razonamiento con pocos ejemplos para la lógica del producto, muestras reales de reescritura de código para herramientas de desarrollo, instrucciones multimodales para flujos de documentos e imágenes y pruebas de salida estructurada para la ingesta en bases de datos. Mide no solo la calidad, sino también el coste por token útil, la latencia P95 en flujos síncronos, el rendimiento por lotes en tareas sin conexión y los modos de fallo cuando la red se degrada. Combina estos indicadores en un «umbral de aceptación» para cada carga de trabajo y úsalo para elegir el proveedor menos costoso que cumpla tu SLA.
Las cuestiones operativas son tan decisivas como la precisión del modelo. La dependencia de un proveedor suele aparecer de forma sutil: las integraciones de herramientas propietarias, las particularidades de las llamadas a funciones o las funciones de auditoría cerradas pueden agilizar el lanzamiento inicial, pero complicar las migraciones futuras. Los modelos de pesos abiertos ofrecen el máximo control sobre la residencia de los datos y los costes de inferencia, pero trasladan a tus equipos de infraestructura la responsabilidad de escalarlos, aplicar parches de seguridad y garantizar su fiabilidad. Las pasarelas multimodelo y los enrutadores de modelos añaden una capa de abstracción y complejidad, pero permiten combinar modelos base más económicos con una alternativa de mayor calidad, equilibrando los costes unitarios inmediatos con los costes de ingeniería a largo plazo.
Este artículo presenta una matriz de decisión pragmática, escenarios de despliegue y una guía operativa con enrutamiento de modelos, estrategias de respaldo, indicadores de observabilidad y sistemas de supervisión de costes, para que los equipos puedan adoptar una arquitectura modular. El objetivo no es recomendar un único proveedor, sino proponer un método repetible: definir los requisitos de cada carga de trabajo, realizar evaluaciones específicas, elegir la arquitectura más sencilla que los satisfaga y diseñar la pila tecnológica para que cambiar de proveedor sea una cuestión de configuración operativa, no una costosa reescritura.