

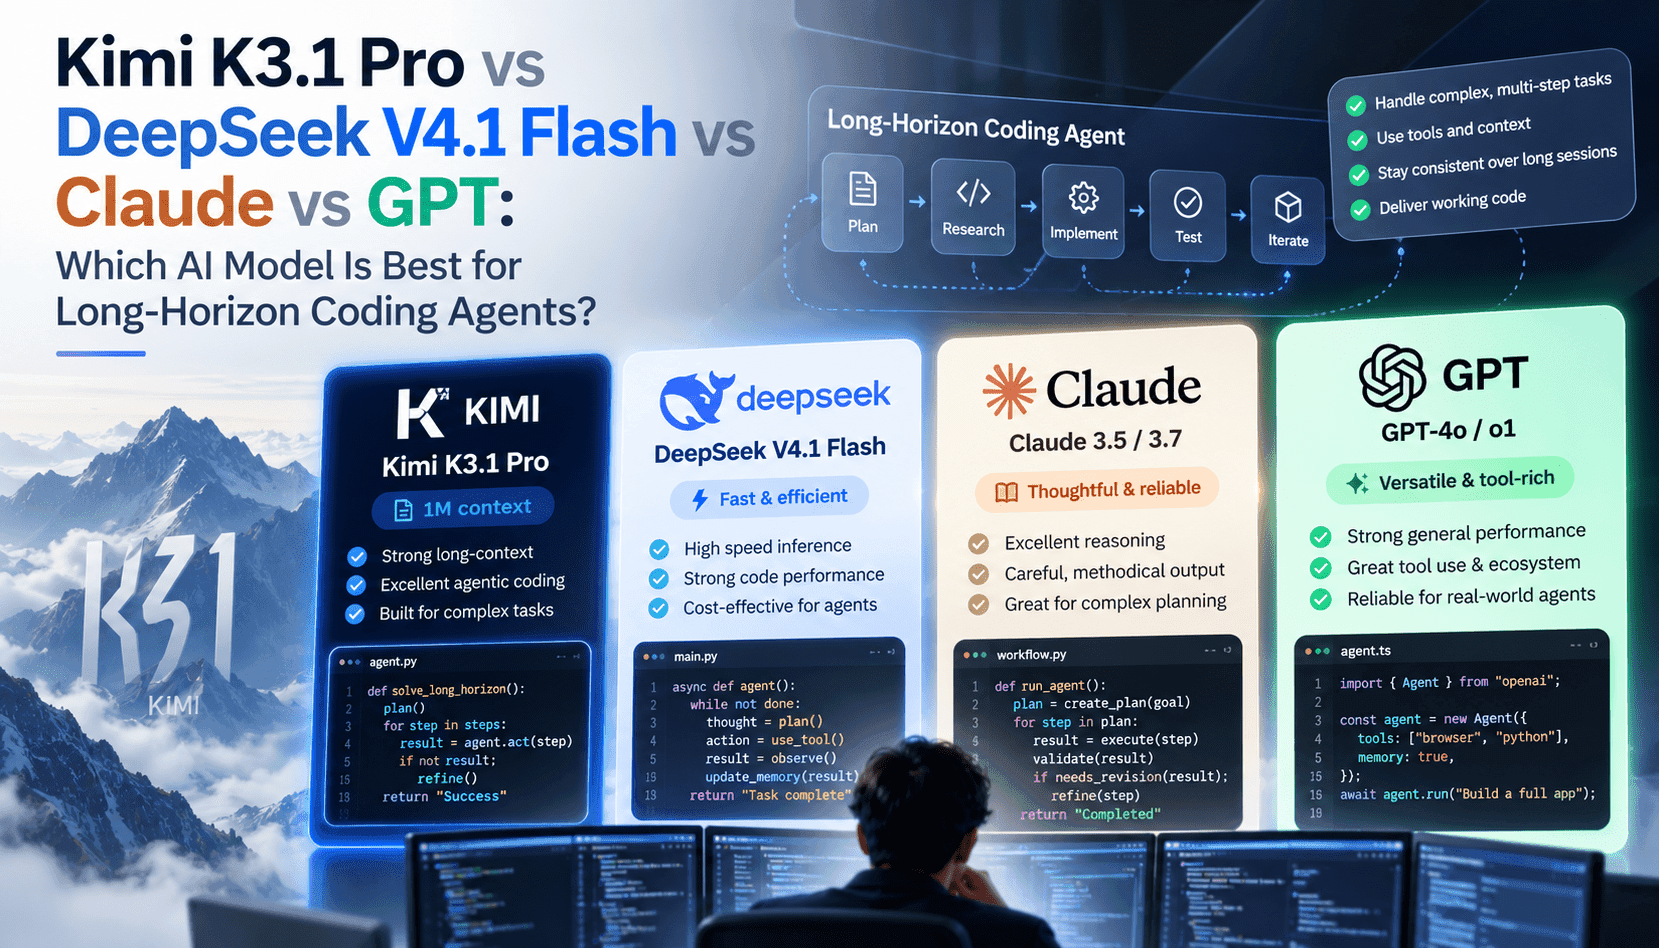
Los agentes de programación que trabajan durante largos periodos se evalúan con criterios distintos a los de la generación de código en un solo turno. Necesitan mantener un razonamiento coherente a lo largo de muchas llamadas a herramientas, almacenar el estado de forma fiable entre sesiones, procesar actualizaciones incrementales con eficiencia y ofrecer costes previsibles por tarea de desarrollo. La ventana de 1 millón de tokens y las funciones de modo de razonamiento de Kimi K3.1 Pro están diseñadas específicamente para este flujo; la variante Flash de DeepSeek prioriza la latencia y el rendimiento de transmisión, Claude pone el foco en la seguridad y el razonamiento controlable, y los modelos de la familia GPT ofrecen un ecosistema amplio y, a menudo, una cadena de herramientas conversacionales de primer nivel. Para los equipos de ingeniería, la pregunta no es qué modelo es objetivamente «el mejor», sino cuál se adapta al tamaño de sus repositorios, al ritmo de CI/CD, al presupuesto y a su tolerancia al riesgo.
Las ventajas y desventajas prácticas se hacen evidentes al relacionar las funciones de cada modelo con los flujos de trabajo de los agentes. Un contexto de 1 millón de tokens resulta útil cuando los agentes deben razonar sobre historiales que abarcan varios módulos, documentos de diseño extensos y resultados acumulados de herramientas; por ejemplo, en refactorizaciones con varias solicitudes de cambios o migraciones entre repositorios. Pero esta capacidad solo sirve si el agente aplica compactación selectiva, generación de prompts con recuperación de información y estrategias de caché de sesión para no enviar tokens irrelevantes. Una inferencia más rápida (K3.1 Pro Highspeed o DeepSeek Flash) reduce el tiempo total y la espera de los desarrolladores, pero el coste por token, el tamaño de los lotes y la sobrecarga de E/S determinan si los modelos más rápidos realmente reducen los gastos operativos en producción.
Los modelos de pesos abiertos cambian la ecuación de despliegue: los equipos pueden ejecutar agentes en infraestructura privada, controlar la telemetría y evitar la dependencia de un proveedor, pero asumen tareas operativas como gestionar la latencia del servicio, distribuir el contexto extenso entre particiones y mantener actualizados los filtros de seguridad. Los modelos propietarios de vanguardia siguen ahorrando tiempo: un mejor razonamiento desde el primer momento, ecosistemas de herramientas integrados y protecciones gestionadas reducen el esfuerzo de ingeniería. La decisión adecuada depende de si la organización prioriza la privacidad de los datos y la latencia en sus instalaciones, o si prefiere minimizar el esfuerzo de integración y confiar en los acuerdos de nivel de servicio del proveedor para las actualizaciones de seguridad y las mejoras del modelo.
Más allá de las capacidades brutas, evalúa cómo se comportan los modelos dentro de agentes que usan varias herramientas: ¿admiten especificaciones deterministas para las llamadas a herramientas, modos de razonamiento estructurado, transmisión de resultados de herramientas y aprobaciones basadas en permisos? El modo de razonamiento y los controles de sesión de Kimi buscan reducir las alucinaciones en flujos prolongados; el rendimiento de DeepSeek Flash reduce los tiempos de espera en ciclos de CI ajustados; las heurísticas de seguridad de Claude lo hacen atractivo para empresas con requisitos estrictos de cumplimiento; y los modelos de la familia GPT se benefician de conectores de ecosistema completos y marcos de orquestación de terceros. Sopesa la complejidad de integración, la auditabilidad y la capacidad de recuperación de cada modelo cuando falla una herramienta a mitad de un plan.