

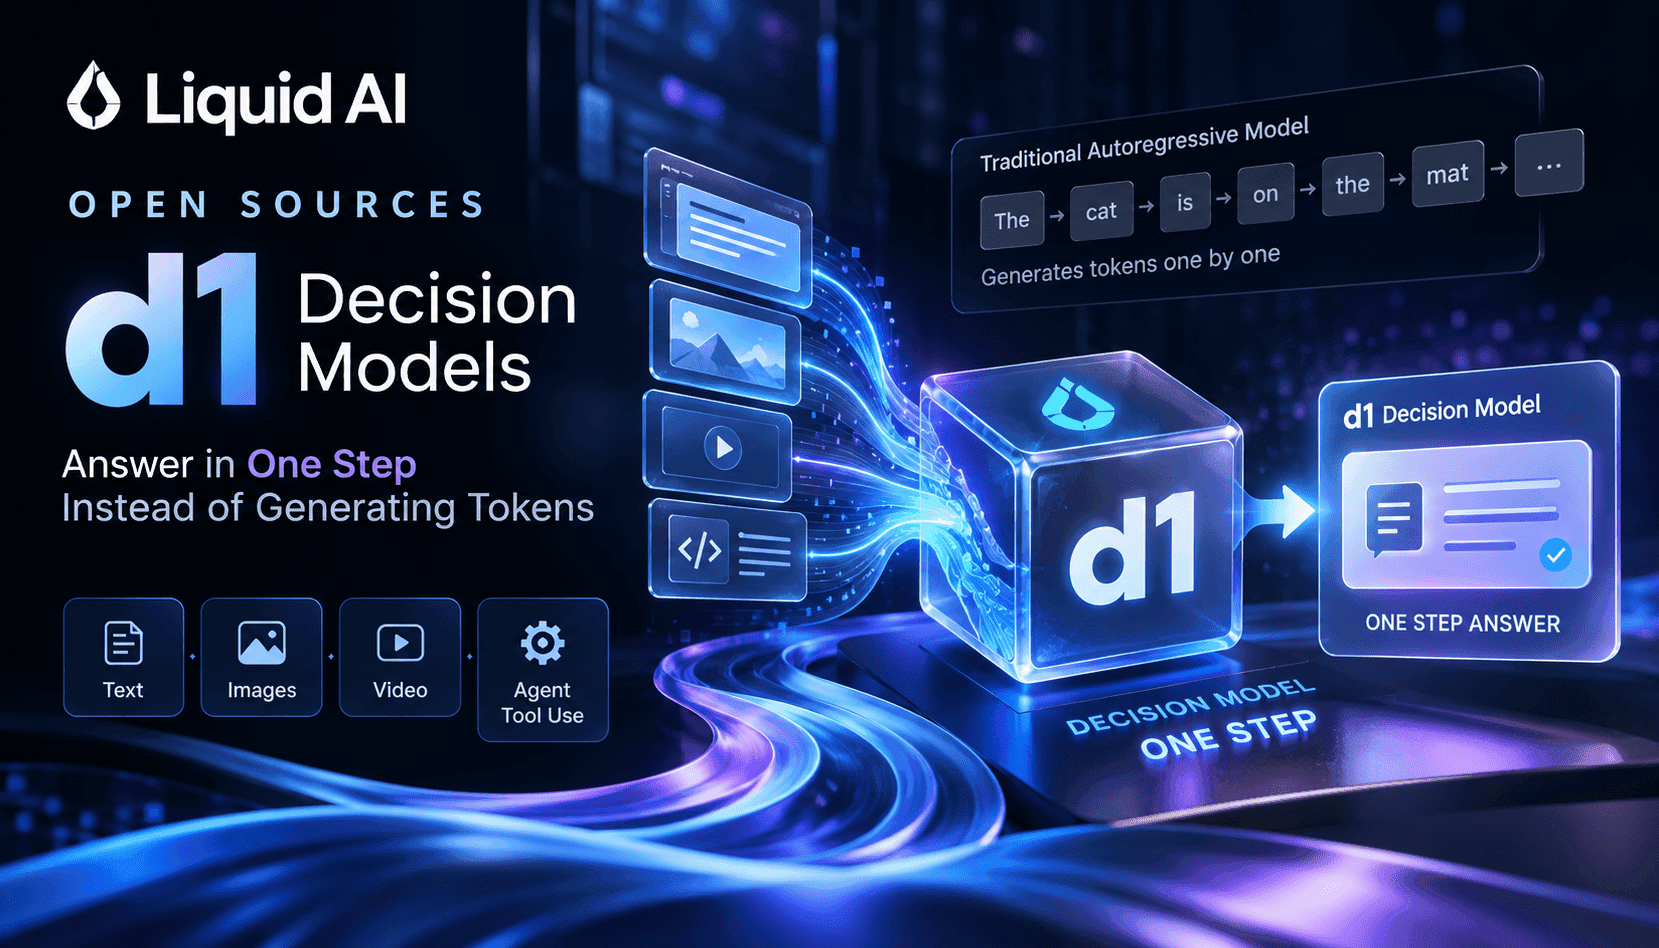
El lanzamiento de d1 de Liquid AI marca un giro deliberado: se aleja de la generación autorregresiva de tokens y apuesta por modelos diseñados para producir decisiones estructuradas, es decir, distribuciones de probabilidad calibradas sobre etiquetas discretas en una sola pasada hacia delante. A diferencia de los LLM, que elaboran respuestas token a token, estos modelos de decisión evalúan una entrada y devuelven un vector compacto de niveles de confianza. El cambio puede parecer sutil a nivel de API, pero tiene importantes implicaciones para los sistemas que necesitan resultados deterministas, rápidos y auditables, en lugar de texto conversacional.
En la práctica, d1-3B y d1-omni-600M están pensados para situaciones en las que el rendimiento y la interpretabilidad importan más que la fluidez generativa. La asignación de tickets, el filtrado de spam, la moderación de contenido, la clasificación inicial para el control de calidad en la fabricación y la clasificación industrial se benefician de una decisión en un solo paso: se acorta el recorrido de la solicitud, se elimina la variabilidad del decodificado y se obtienen probabilidades que pueden someterse a umbrales, calibrarse, registrarse e integrarse en motores de reglas o procesos de automatización posteriores, sin necesidad de analizarlas ni correr el riesgo de alucinaciones.
Para los equipos de ingeniería y producto, las ventajas operativas son concretas: los resultados deterministas simplifican la supervisión, reducen los reintentos causados por peculiaridades de la tokenización y disminuyen los costes de computación al evitar los ciclos de decodificación autorregresiva. Para el cumplimiento normativo y los registros de auditoría, es más fácil documentar y analizar un vector de probabilidades junto con la versión del modelo que un texto de formato libre. Eso sí, adoptar modelos de decisión exige nuevas prácticas de evaluación: hay que validar la calibración en distintos segmentos de producción y diseñar respuestas alternativas prácticas para los casos fuera de distribución.
Este artículo explica qué ha cambiado, cómo medir el valor de los resultados de decisión de un solo paso, qué patrones de despliegue usar en el edge y en la nube, cuáles son los problemas de integración más comunes y qué lista breve de comprobaciones operativas pueden seguir los equipos que quieran sustituir soluciones basadas en generación de tokens por modelos de decisión calibrados en sus flujos de trabajo de producción.