

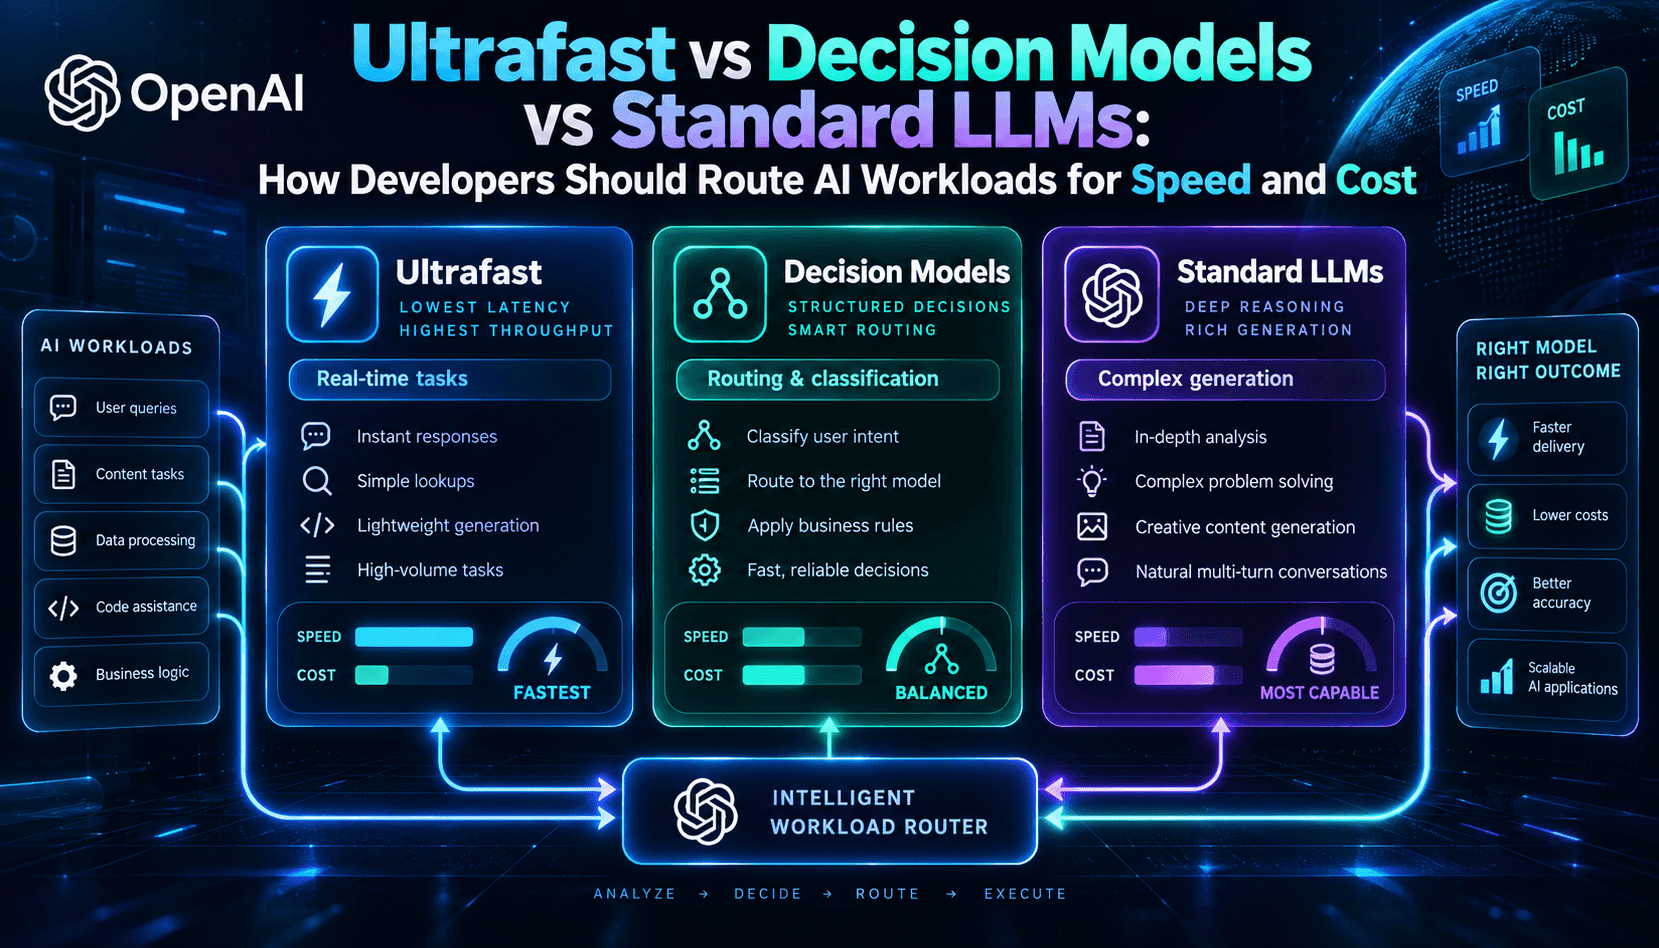
Los desarrolladores se enfrentan a menudo a una decisión de arquitectura: enviar todo al modelo más capaz o enrutar cada tarea a endpoints especializados, más rápidos y económicos. Las incorporaciones recientes de OpenAI —GPT-6.1 Sol Ultrafast y GPT-6 Luna Decisions— permiten tomar esa decisión con más criterio. Sol Ultrafast reduce la latencia de generación de tokens en flujos generativos; Luna Decisions ofrece respuestas y decisiones tipadas con un rendimiento aproximadamente un orden de magnitud superior al de los endpoints completos de Responses. En este artículo convertimos estos avances de la plataforma en estrategias de enrutamiento prácticas que puedes aplicar desde hoy.
Antes de enrutar las solicitudes, clasifica las cargas de trabajo según cuatro criterios: profundidad de razonamiento necesaria (clasificación sencilla frente a una cadena de razonamiento profunda), latencia aceptable (interfaz de usuario por debajo de 100 ms frente a procesamiento por lotes de varios segundos), estructura de la salida (decisión tipada frente a texto libre) y sensibilidad al coste. Por ejemplo, para las tareas breves y deterministas de clasificación y enrutamiento suele bastar la API de Decisions. La generación conversacional con mayor creatividad se beneficia de las variantes Sol o Astra con razonamiento completo; para transmitir tokens con gran rendimiento en interfaces de usuario, la mejor opción suele ser el nivel Ultrafast. Asignar las cargas de trabajo según estos criterios evita recurrir en exceso a modelos avanzados y costosos.
En la práctica, puedes implementar tres vías de enrutamiento complementarias: una vía de Decisions (Luna) para decisiones estructuradas de alto rendimiento y tareas de clasificación; una vía generativa Ultrafast (GPT-6.1 Sol con service_tier:"ultrafast") para transmitir tokens con baja latencia y ofrecer interfaces interactivas; y una vía de razonamiento (GPT-6 Sol/Astra) para razonamientos complejos, síntesis de código o uso de herramientas en varios pasos. Añade un enrutador ligero que seleccione la vía según los metadatos (tamaño del prompt, esfuerzo de razonamiento previsto, presupuesto de latencia y necesidad de una salida tipada y estructurada).
Algunos ejemplos concretos: usa Decisions para detectar spam, enrutar intenciones, tomar decisiones sobre indicadores de funcionalidad, realizar clasificaciones sencillas y generar salidas tipadas; usa Ultrafast para chats en streaming, autocompletado, sugerencias en tiempo real e interfaces donde los usuarios prefieren una respuesta inmediata, aunque implique un poco menos de deliberación; reserva los modelos con razonamiento completo para generar código, realizar análisis de varios pasos o resolver tareas en las que el uso de herramientas y el razonamiento extenso cambien sustancialmente el resultado. Estas estrategias reducen el coste total y mantienen la precisión allí donde más importa.