Deja de Adivinar: Un Marco de Seis Dimensiones para Comparar Herramientas de IA y Demostrar el ROI
Olvida las demostraciones llamativas. Usa una tarjeta de puntuación de seis dimensiones—ajuste de características, precisión y fiabilidad, costo total de propiedad, privacidad y seguridad, integraciones y compatibilidad con el flujo de trabajo, y ROI medible—para seleccionar herramientas de IA que aporten valor empresarial. Realiza pruebas controladas, escenarios de precios y verificaciones de cumplimiento para respaldar las decisiones con datos.
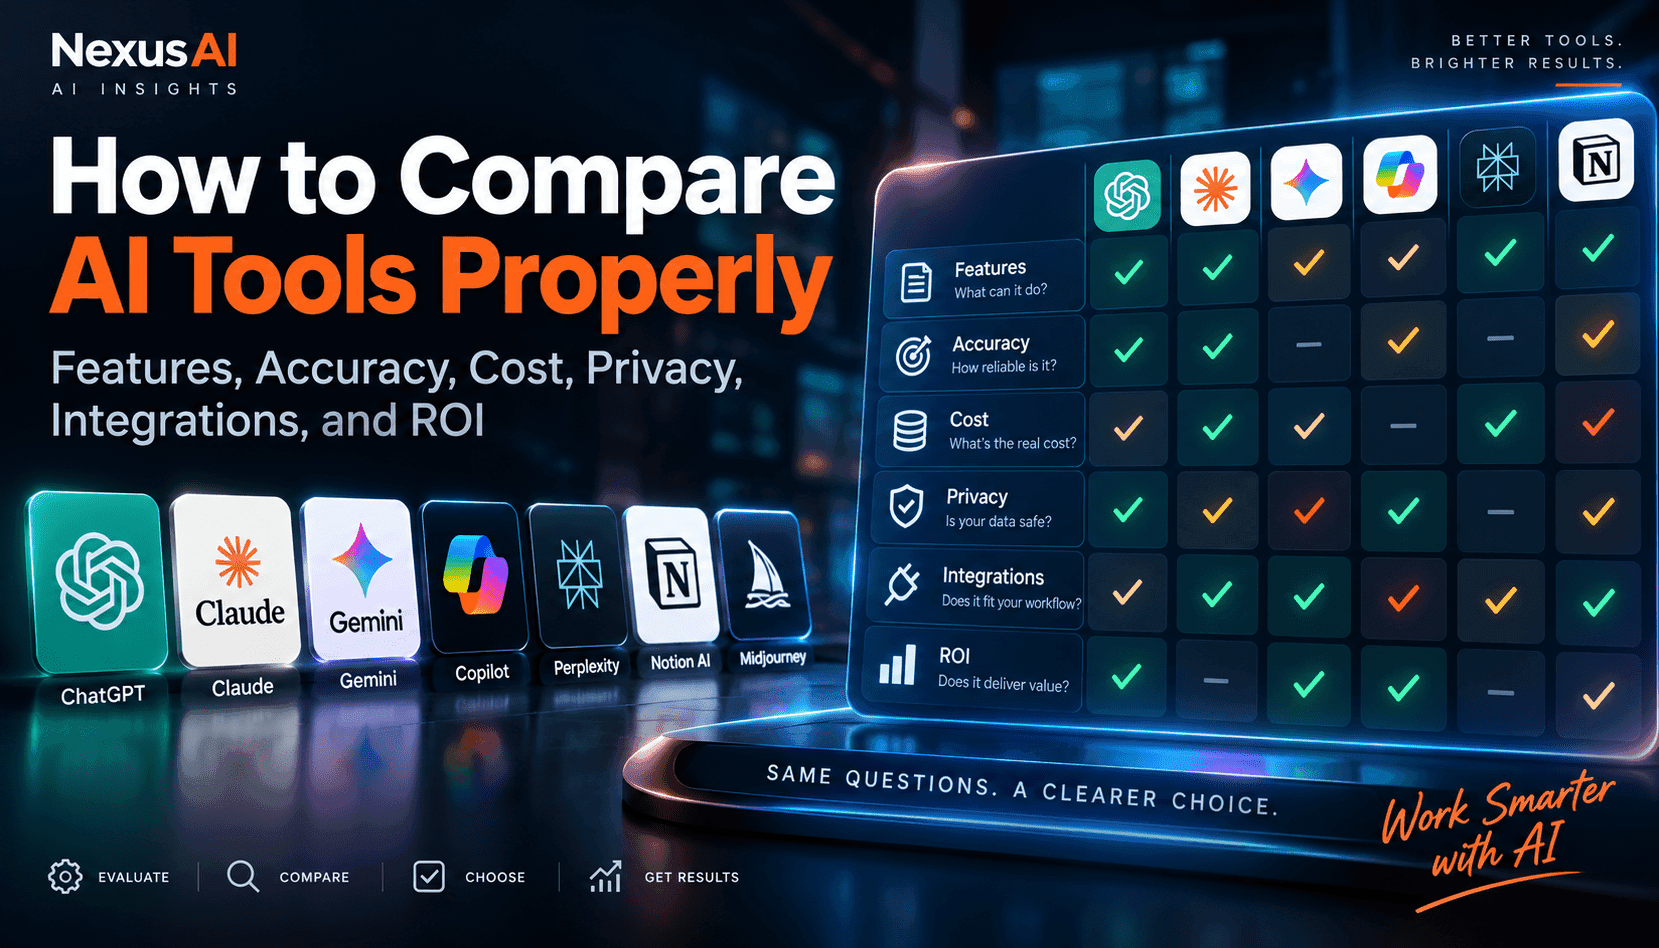
Resumen de IALa mayoría de las decisiones sobre herramientas de IA fallan porque optimizan para benchmarks llamativos o reconocimiento de marca en lugar de ajuste y economía. Esta guía ofrece un marco práctico y defendible para compradores y desarrolladores empresariales: una tarjeta de puntuación ponderada en seis dimensiones, un plan de evaluación controlada que mide tareas reales, modelado de TCO que revela costos ocultos, verificaciones de privacidad y cumplimiento que el área legal puede aprobar, y cálculos de ROI ligados a tiempo ahorrado, mejora de calidad, impacto en ingresos y reducción de gastos operativos. El resultado es una decisión documentada que puedes defender ante finanzas, seguridad y operaciones—y una mayor probabilidad de que la herramienta elegida realmente mejore el flujo de trabajo que debe servir.
Las afirmaciones de marketing rara vez resisten el contacto con cargas de trabajo reales. La herramienta de IA adecuada es aquella que se adapta a tu proceso, datos y postura de riesgo mientras mejora la economía, no necesariamente el modelo más grande o nuevo. Ancla tu evaluación en una tarjeta de puntuación de seis dimensiones: ajuste de características, precisión y fiabilidad de salida, costo total de propiedad (TCO), privacidad y seguridad, integraciones y compatibilidad con el flujo de trabajo, y ROI medible. Pondera cada dimensión para reflejar las prioridades del negocio—por ejemplo, privacidad para datos regulados o latencia para flujos orientados al cliente—y comprométete con un método de puntuación transparente para que compras, seguridad y finanzas puedan seguir la lógica desde el requisito hasta la decisión.
Diseña una prueba controlada que refleje la producción. Define tareas representativas, entradas, criterios de aceptación y umbrales de aprobación/rechazo antes de que los proveedores tengan acceso a los datos. Mide no solo el rendimiento medio, sino el comportamiento distributivo: errores extremos, deriva entre conjuntos de datos y estabilidad ante variaciones en el prompt o contexto. Usa revisiones a ciegas para reducir sesgos, registra prompts y parámetros para reproducibilidad, y evalúa la variabilidad de latencia porque el P95 importa en sistemas en vivo. Captura el esfuerzo de integración y la sobrecarga operativa—guardarraíles, monitoreo, red-teaming—como parte de la puntuación y no como un añadido posterior. Tu objetivo es evidencia comparable y lista para decisiones entre candidatos.
Trata el costo como un modelo de escenarios, no como un ítem aislado. Compara precios por suscripción y uso proyectando volumen de solicitudes, tamaño de ventana de contexto, reintentos, frecuencia de uso de la herramienta y tráfico de evaluación. Incluye costos ocultos: dispersión de tokens, almacenamiento vectorial, egreso, ejecuciones de ajuste fino, observabilidad y gestión del cambio. Traduce el rendimiento técnico en economía con costo por resultado exitoso, no costo por llamada. Luego cuantifica el ROI desde cuatro fuentes: tiempo ahorrado, mejora de calidad (menos defectos o escaladas), aumento de ingresos (conversión, retención, upsell) y reducción de costos operativos (automatización, consolidación). Si un modelo “más débil” gana en costo por resultado y cumplimiento, es la elección correcta.
Conclusiones clave
Evalúa Lo Que Necesitas, No Lo Que Se Publicita
Usa una tarjeta de puntuación ponderada en seis dimensiones y exige umbrales mínimos por dimensión. Los benchmarks públicos informan, pero tus datos y restricciones deciden.
Economía del Modelo = Costo Por Resultado
Compara planes de suscripción y uso bajo escenarios realistas. Incluye costos ocultos de plataforma y personal, y optimiza para costo por tarea exitosa, no costo por llamada.
El Cumplimiento Es Una Puerta, No Un Desempate
Valida manejo de datos, residencia y certificaciones con evidencia. Si privacidad o seguridad fallan, no continúes—ninguna característica compensa el riesgo.
Construye la Tarjeta de Puntuación Ponderada
Comienza con requisitos claros. Para cada dimensión—características, precisión/fiabilidad, TCO, privacidad/seguridad, integraciones/flujo de trabajo, ROI—enumera criterios y define cómo medirlos. Ejemplo: “resumen de documentos con citas” se convierte en tareas con verdad de terreno, objetivos de precisión/recuperación de citas y umbrales de latencia. Asigna pesos que reflejen prioridades empresariales (por ejemplo, 25 % privacidad para equipos regulados, 30 % ROI para programas con presupuesto limitado). Mantén la rúbrica de puntuación simple: 0 (no cumple), 1 (cumple), 2 (supera), multiplicado por el peso. Documenta la justificación para que los cambios en los pesos sean auditables.
Evita dos trampas: sobreajustar a benchmarks públicos y sobreponderar el rendimiento máximo. Las tablas de clasificación públicas no capturan tu contenido, prompts o guardarraíles; prioriza evaluaciones con tus datos. De igual forma, una herramienta que brilla ocasionalmente pero falla a menudo inflará los costos de soporte. Puntúa tanto la calidad promedio como la estabilidad, y exige un rendimiento mínimo viable por dimensión—ningún candidato debe “compensar” un fallo de cumplimiento con buenas características.
Realiza Pruebas Controladas en el Mundo Real
Construye conjuntos de evaluación que reflejen el tráfico real: casos límite, contenido multilingüe, documentos con pocos recursos y entradas desordenadas. Estandariza prompts y configuraciones de temperatura; captura semillas y longitud de contexto para repetibilidad. Mide precisión con métricas adecuadas a la tarea (coincidencia exacta, BLEU/ROUGE, fidelidad de citas), fiabilidad con variación entre ejecuciones y seguridad con prompts de red-team. Registra latencias P50/P95 y tiempo hasta el primer token. Donde el juicio humano sea esencial, usa adjudicación doble ciega con reglas de desempate y kappa de Cohen para medir acuerdo.
Operacionaliza lo que pruebas. Implementa una canalización mínima: saneamiento de entradas, recuperación (si aplica), filtros de seguridad, registro y hooks de evaluación. Esto revela fricción de integración temprano—madurez del SDK, límites de tasa, comportamiento de streaming, semántica de errores—y convierte promesas anecdóticas de proveedores en esfuerzo medible para desarrolladores. Registra tiempo de configuración, herramientas personalizadas requeridas y profundidad de observabilidad; estos insumos alimentan tanto el TCO como las puntuaciones de integración.
Escenarios de Precio y Costo Total de Propiedad
Modela tres curvas de demanda—baja, esperada, pico—y calcula costos mensuales bajo precios de suscripción y uso. Incluye tokens de entrada/salida, tamaño de contexto, cadenas de llamadas a herramientas, embeddings, almacenamiento vectorial, reintentos de inferencia, ejecuciones de evaluación y egreso. Añade costos de personal y plataforma: tiempo de ingeniería para guardarraíles, bibliotecas de prompts, monitoreo y respuesta a incidentes; revisiones legales y auditorías; gestión del cambio y capacitación. Expresa resultados como costo por tarea exitosa y costo por usuario activo para comparar alternativas de forma justa.
Prueba de estrés el riesgo: ¿Qué pasa si la longitud de entrada se duplica? ¿Si la calidad requiere modos de mayor capacidad? ¿Si los límites de tasa restringen el tráfico pico? Construye tablas de sensibilidad y una regla de cambio—por ejemplo, si costo por resultado > X o calidad < Y, redirige a un nivel superior. Esto prepara a compras para disparadores de renegociación y previene sobrecostos inesperados.
Lista de Verificación de Privacidad, Seguridad y Cumplimiento
Mapea clases de datos (PII, PHI, financieros, propiedad intelectual) a ubicaciones de procesamiento y retención. Exige anexos de procesamiento de datos, controles regionales, registros de auditoría y una declaración clara sobre el uso de datos de entrenamiento (opt-in/opt-out). Valida opciones de redacción, cifrado en tránsito/en reposo, gestión de claves, SSO/SCIM, acceso basado en roles y SLA de respuesta a incidentes. Para cargas reguladas, verifica certificaciones y evidencias—no aceptes insignias de marketing en lugar de documentos.
Prueba con datos realistas pero saneados, luego ensaya una evaluación de impacto de privacidad. Confirma rutas de residencia de datos de extremo a extremo—incluyendo sistemas de recuperación y telemetría. Si se usa enrutamiento de modelos, asegura que las restricciones más estrictas se propaguen a todos los backends. Trata el cumplimiento como una puerta de aprobación; las herramientas que no lo cumplan no deben avanzar a negociaciones de precio.
Integraciones, Ajuste al Ecosistema y Cálculos de ROI
Evalúa el ajuste al ecosistema observando estabilidad del SDK, amplitud de conectores, soporte RAG, herramientas de evaluación y profundidad de observabilidad. Prefiere proveedores que reduzcan el código pegamento: webhooks nativos, streaming, llamadas a funciones, reintentos, APIs por lotes y plugins de primera parte para tu pila de datos. Evalúa la fricción al cambio—cadencia de versiones, compatibilidad hacia atrás y herramientas de migración—porque la herramienta más barata se vuelve costosa si cada actualización rompe flujos de trabajo.
Cuantifica el ROI con un libro simple: tiempo ahorrado (horas × tarifa cargada), ganancias de calidad (reducción de defectos × costo de retrabajo), aumento de ingresos (conversión/retención × margen) y ahorros operativos (licencias consolidadas, incidentes evitados). Registra intervalos de confianza y periodo de recuperación. Presenta una tabla final de decisión: puntuación ponderada, costo por resultado, estado de cumplimiento, riesgo de integración y periodo de recuperación. Selecciona la herramienta que maximice el valor para tu flujo de trabajo específico—no el benchmark principal.
Preguntas frecuentes
¿Cómo debo establecer los pesos en la tarjeta de puntuación sin sesgar el resultado?
Alinea los pesos con el riesgo y valor del negocio: eleva la privacidad para datos regulados, la fiabilidad para flujos orientados al cliente o el ROI para equipos sensibles al costo. Obtén aprobación de seguridad, finanzas y operaciones antes de probar, y mantén los pesos fijos durante la evaluación para evitar ajustes basados en resultados.
¿Cuál es la forma más rápida de realizar una comparación justa sin construir aplicaciones completas?
Crea un arnés de evaluación ligero: prompts estandarizados, parámetros con semillas, una pequeña capa RAG si aplica, registro y un script de adjudicación. Usa conjuntos de datos representativos, revisión humana a ciegas donde sea necesario y captura latencias P50/P95 y variación. Esto revela calidad y fricción operativa en días, no semanas.
¿Cómo traduzco mejoras de calidad en un ROI que mi CFO confiará?
Vincula métricas al flujo de caja: tiempo ahorrado (horas × tarifa cargada), reducción de defectos (costo de retrabajo) e impacto en ingresos (conversión/retención × margen). Usa líneas base de datos operativos históricos, añade intervalos de confianza e informa periodo de recuperación y costo por resultado exitoso. Reestima trimestralmente conforme crece el uso.

