


Datology AI
NexusAi サマリー: Datologyは、企業データや公開データを精選し、中間学習または事前学習向けの高品質な学習データセットに仕上げます。データ処理パイプラインによってトークンあたりの情報密度を高め、評価指標の向上を実現しながら、より小型で高速なモデルの開発とプライベートクラウドへの導入を可能にします。
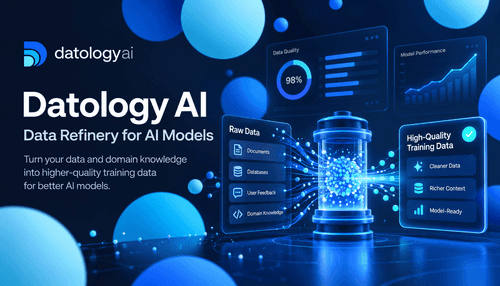
NexusAi 概要
Datologyのワークフローは、企業内データやウェブ上のデータを取り込み、書式の乱れや評価データの混入を取り除いたうえで、品質フィルターとタスク分類を適用します。データが不足している領域は合成データで補完し、下流の評価に合わせて調整した学習用データセットを段階的に作成します。
主な機能
主な対象ユーザーは、独自の基盤モデルを開発する、またはオープンモデルを特定分野のタスクに適応させるML研究者、データエンジニア、技術部門の意思決定者です。独自コーパスやラベル付きの専門知識によって、汎用的な事前学習とはモデルの挙動が大きく変わる場合、法務、検索、音声、各種専門業務のチームに特に役立ちます。
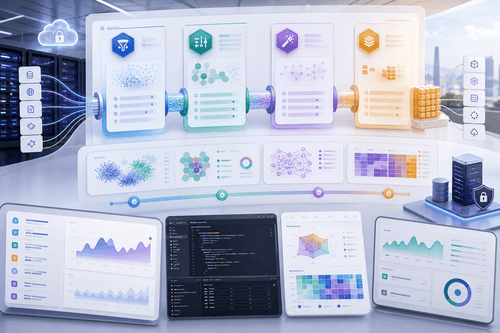
- クリーニングでは、書式が不適切な文書や評価データが混入した文書を大規模に除去します。
- キャリブレーションでは、目的に応じて品質、タスク、分類体系の観点からデータを調整します。
- 生成では、タスクとの関連性や多様性を高める、目的に合わせたサンプルを合成します。
- 構成では、複数のデータソースを最適に組み合わせ、学習実行向けの段階的なデータセットを作成します。
- プライベートクラウドで運用することで、独自データのプライバシーと監査可能性を確保できます。
実績とパフォーマンス
お客様の声
まずはデモを予約し、データセットの用途を共有してください。Datologyの導入プロセスには、一般的なストレージ向けのコネクター、監査を重視したデータキュレーションスタジオ、学習フレームワーク向けのエクスポート形式が含まれます。プライベートクラウドやネットワークから隔離された環境で運用でき、初期プロジェクトでは、対象を絞った中間学習や、キュレーション済みの事前学習コーパスを扱うケースが一般的です。製品にはドキュメントや研究ノートも付属し、データキュレーションの判断を再現し、学習後の性能向上を測定できます。
NexusAi: 「私たちが持つ知見を理解してくれています。多くの人が計算資源を増やして得ようとしている性能向上は、手つかずのままデータの中に眠っています。」— Thomson Reuters リサーチ責任者
導入方法
Datologyは、研究と本番運用のノウハウを精選済みのデータパイプラインに集約し、学習データの情報量を高めることでモデル性能の向上を支援します。評価データの混入除去、目的に合わせた合成データ生成、段階的なデータ構成を組み合わせることで、企業のプライバシーと監査可能性を維持しながら、専門分野のタスクに適した、より小型で高速なモデルを実現します。
ツールを開き、基本的な製品体験を確認します。
アカウントを作成するか、既存のワークスペースにアクセスします。
自分のタスクで速度、品質、適合性を判断します。
最終判断の前に類似AIツールを確認します。
Datology AI
DatologyAIは、企業やウェブのデータを情報密度の高い学習用コーパスへと変換することに特化したデータエンジニアリング企業です。研究面の信頼性と本番環境向けのツールを組み合わせ、モデル開発者が精選済みのデータセットを再現性のある形で活用・導入できるよう支援しています。
Datologyは、独自データ、ライセンス取得済みデータ、公開ウェブデータを、モデル開発者向けの高品質な学習データへと変換するデータ精製プラットフォームです。顧客のデータ上で処理を行い、トークンの販売や調達は行いません。ノイズや評価データの混入を取り除く「クリーニング」、品質や分類体系を調整する「キャリブレーション」、タスクとの関連性を高める「合成データ生成」、段階的な学習用コーパスを組み立てる「構成」の4段階のパイプラインを適用します。中間学習と事前学習のワークフローを対象とし、既存のデータストレージや取り込みプロセスと連携。最先端規模でも競争力が実証された、研究水準のツールを提供します。その結果、トークンあたりの情報密度が高まり、同等の性能をより少ない計算資源で実現できます。また、プライベートクラウドへの導入やコンプライアンス対応も可能です。
Datology AIにアクセス
コメント (0)
コメントはまだありません