

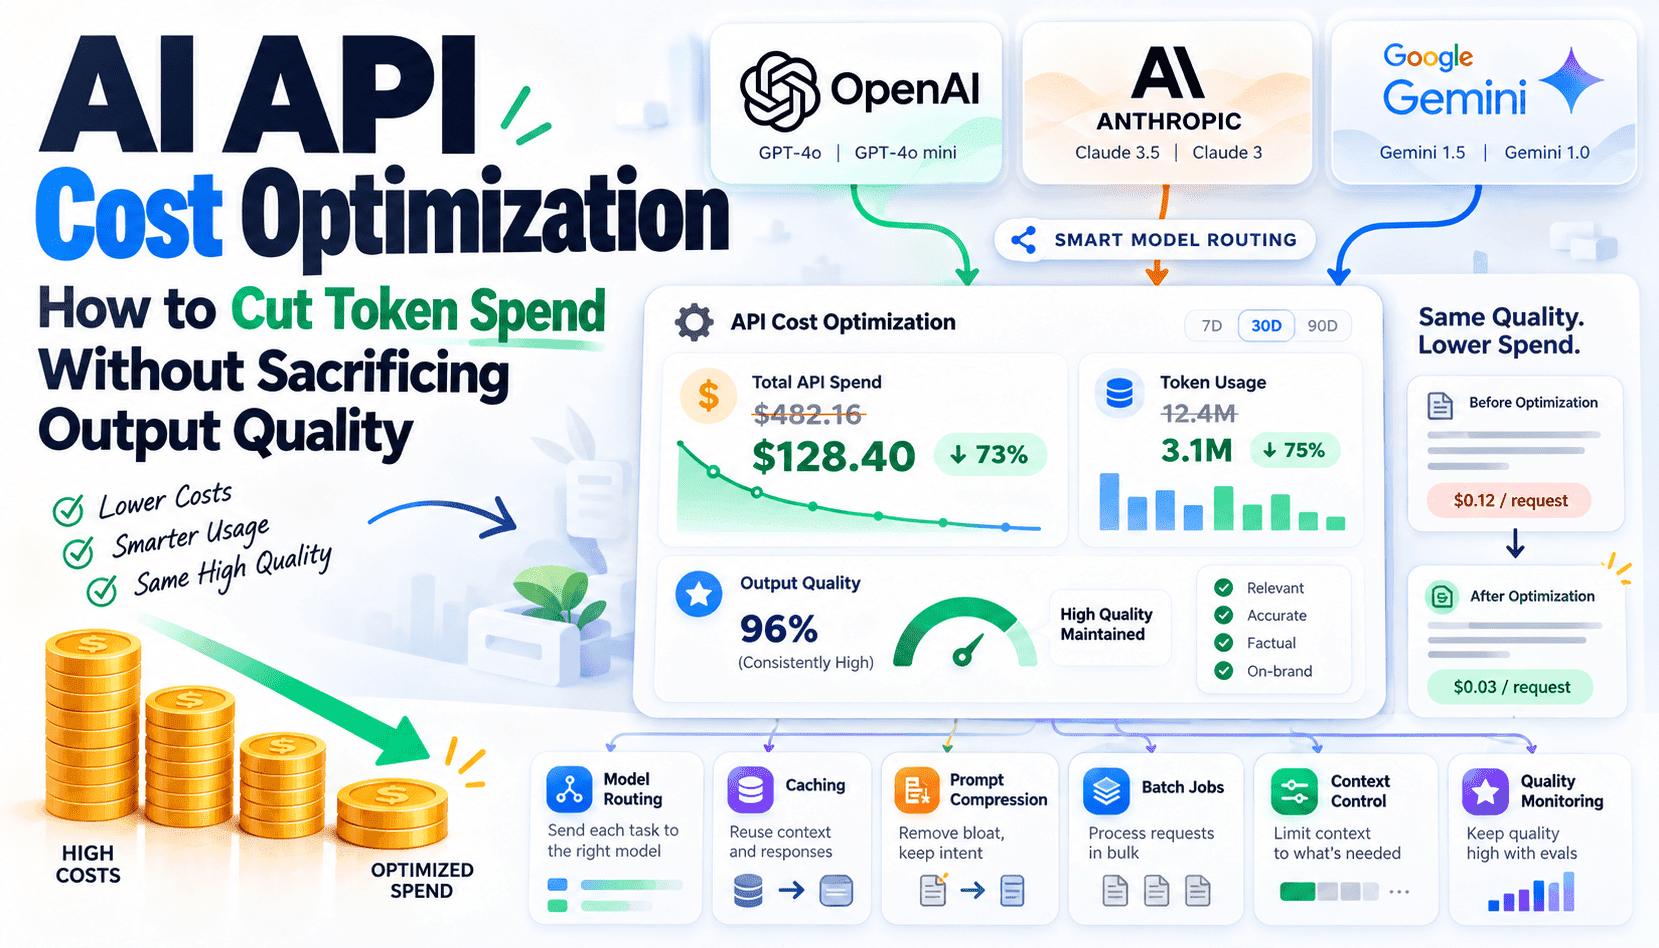
生成AIの普及に伴い、トークン費用は無視できないコスト項目になりました。適切に管理しなければ、ユーザー数の増加やコンテキストの長大化、出力の制御不足に比例して支出も膨らみます。コスト最適化とは、常に最安のモデルを選ぶことではありません。タスクの複雑さに応じてモデルの性能を使い分け、入力と出力の無駄なトークンを減らし、ビジネス成果に明確な効果がある場面だけで高コストの推論を使うよう、ワークフローを整えることです。この記事では、チームが実践できる運用上の施策と、トレードオフを測定するための指標を紹介します。
まず、リクエストの振り分けとモデルの対応範囲を整理しましょう。リクエストを複雑さと品質への要求度で分類し、難易度の低いタスクは小型で安価なモデルや決定論的なモジュールに割り当てます。たとえば、短い文章の編集、形式を厳密に指定した翻訳、単純な意図抽出などは、蒸留モデルやヒューリスティックで処理できることが多くあります。一方、創造性が求められる長文の生成や、細やかな判断を要する複数段階の推論には、高性能モデルを使います。各ルートの成功率と、上位モデルへの切り替えが発生した割合を計測すれば、低コストの処理が失敗したケースを把握し、必要な場合に限って引き上げられます。
コストを抑えるプロンプト設計には、実践しやすいポイントが3つあります。意味を損なわず指示を簡潔にすること、共通のシステムコンテキストを最大限活用すること、変化するコンテキストを必要最小限にすることです。簡潔なテンプレート、番号付きの少数例、構造化された関数スキーマを使うと、冗長さを減らせます。安定したシステムコンテキストはサーバー側に保持し、変動する要素だけを追加しましょう。長い会話履歴は生のメッセージを再送するのではなく要約し、文書を扱うタスクでは、文書全体をプロンプトに含めず、関連性の高い箇所を検索して順位付けします。
プロンプトの工夫に加え、キャッシュ、バッチ処理、パイプラインの制御もシステムに組み込みましょう。意味検索と完全一致を組み合わせたハイブリッドキャッシュなら、同じ高コストの推論を繰り返すのを防げます。優先度の低い処理は、オフピーク時間帯やより安価な計算環境でまとめて実行します。また、出力上限や停止トークンを設定し、可能な場合は決定論的な関数呼び出しを使うことで、モデルが際限なく文章を生成するのを防げます。最後に、入力トークン、出力トークン、キャッシュヒット率、レイテンシ、品質指標を一元的に追跡するコスト管理の枠組みを導入しましょう。価格だけでなく、プロダクトの成果も踏まえた判断が可能になります。