

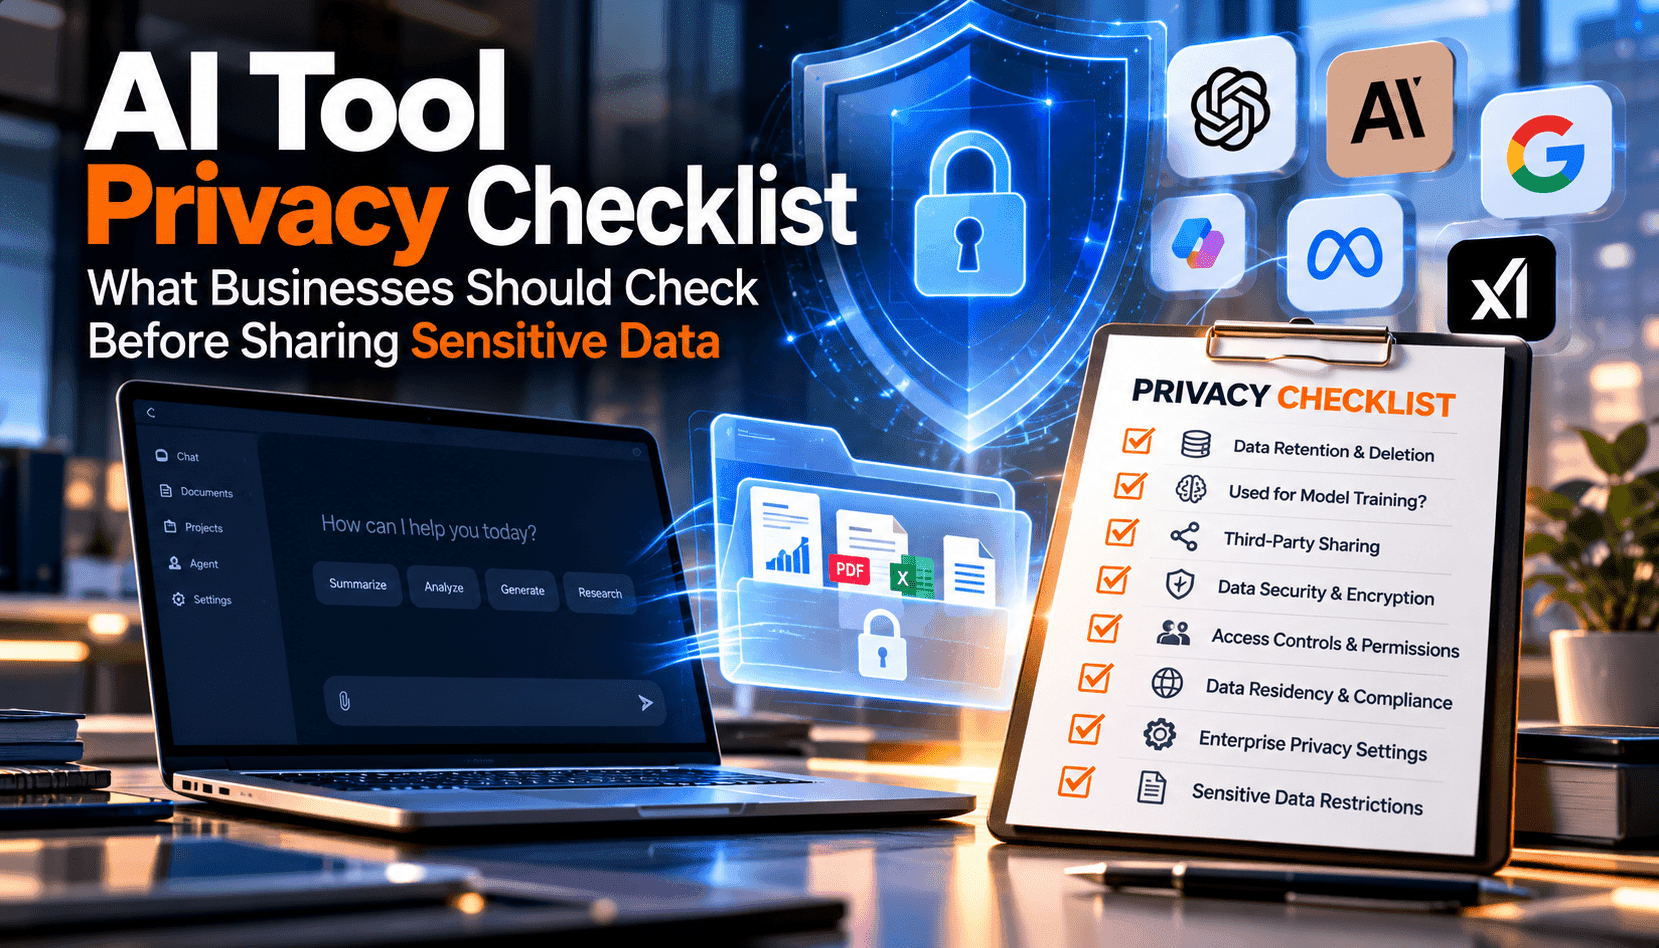
AIツールは今や営業メモから法務ドラフトまで日常のワークフローに組み込まれており、プライバシーのデューデリジェンスは裏方の作業ではなく、最初に行うべき必須事項となっています。チームがプロンプトやドキュメントをアップロードする前に、誰がデータにアクセスできるのか、どのように処理されるのか、モデルのトレーニングや分析に再利用される可能性があるのかを明確にする必要があります。チェックリストは正確で文書化され、繰り返し実行可能でなければならず、現場のチームが推測に頼らずに済むようにします。本ガイドは、商用および公開されているAI製品を評価するための実践的な質問と判断基準をまとめており、特に機密情報の取り扱い、ベンダーの管理、そして本番利用を許可する前に収集すべき証拠に重点を置いています。
まずはデータ最小化の原則から始めましょう。個人情報や特に機密性の高いデータを公開アクセス可能な生成AIツールに入力しないことです。もし個人情報の取り扱いが本当に必要な場合は、契約上の保護措置と文書化された技術的管理があるエンタープライズプランに切り替えてください。プロバイダーやその下請け業者がプロンプト、添付ファイル、出力を閲覧できるか、またそれらの素材がベースモデルやファインチューニングモデルのトレーニングに使用されるかどうかを確認しましょう。オプトアウトが提供されている場合は、それがトレーニングと広範な分析テレメトリの両方に適用されているか、そしてユーザーインターフェースだけでなくテナントやAPIレベルでデフォルトで有効になっているかを検証してください。
保持、削除、データフローは、プロンプト送信後も長期間にわたりプライバシーリスクが残る部分です。ログの保持期間、キャッシュの保存期間、モデルアーティファクトの保管に関する書面によるデフォルト設定を求め、バックアップや処理者のコピーを含む検証可能な削除経路を確保してください。クライアント、ゲートウェイ、モデルホスト、ベクトルストア、ファイル変換器、コンテンツフィルター、監視パイプラインなど、すべての経路をマッピングしましょう。転送中および保存時の暗号化、強力な多要素認証付きSSO、役割ベースのアクセス制御、プライベートネットワークオプション、機密識別子を含むアップロードをブロックするDLPポリシーを要求してください。最後に、人間の監督を組み込み、精度チェック、エスカレーションルート、AIシステムとやり取りする外部ユーザーへの明確な通知を設けましょう。
ベンダーのオンボーディングは単なる承認イベントではなく、ライフサイクルの始まりと捉えてください。プライバシー影響評価、法的根拠または同意モデル、使用が承認された具体的な目的を記録しましょう。新機能、処理者の追加、地域変更、トレーニングポリシーの更新などの変更管理トリガーを設定し、リスクが変化する前にツールを再評価します。出力の精度や意図しない個人情報の生成を監視し、安全なプロンプトに関する従業員向けガイダンスを公開し、定期的な監査を実施してください。リスクが管理できない場合、特に機密情報に関しては、そのデータをツールに入れず、ワークフローを再設計しましょう。