

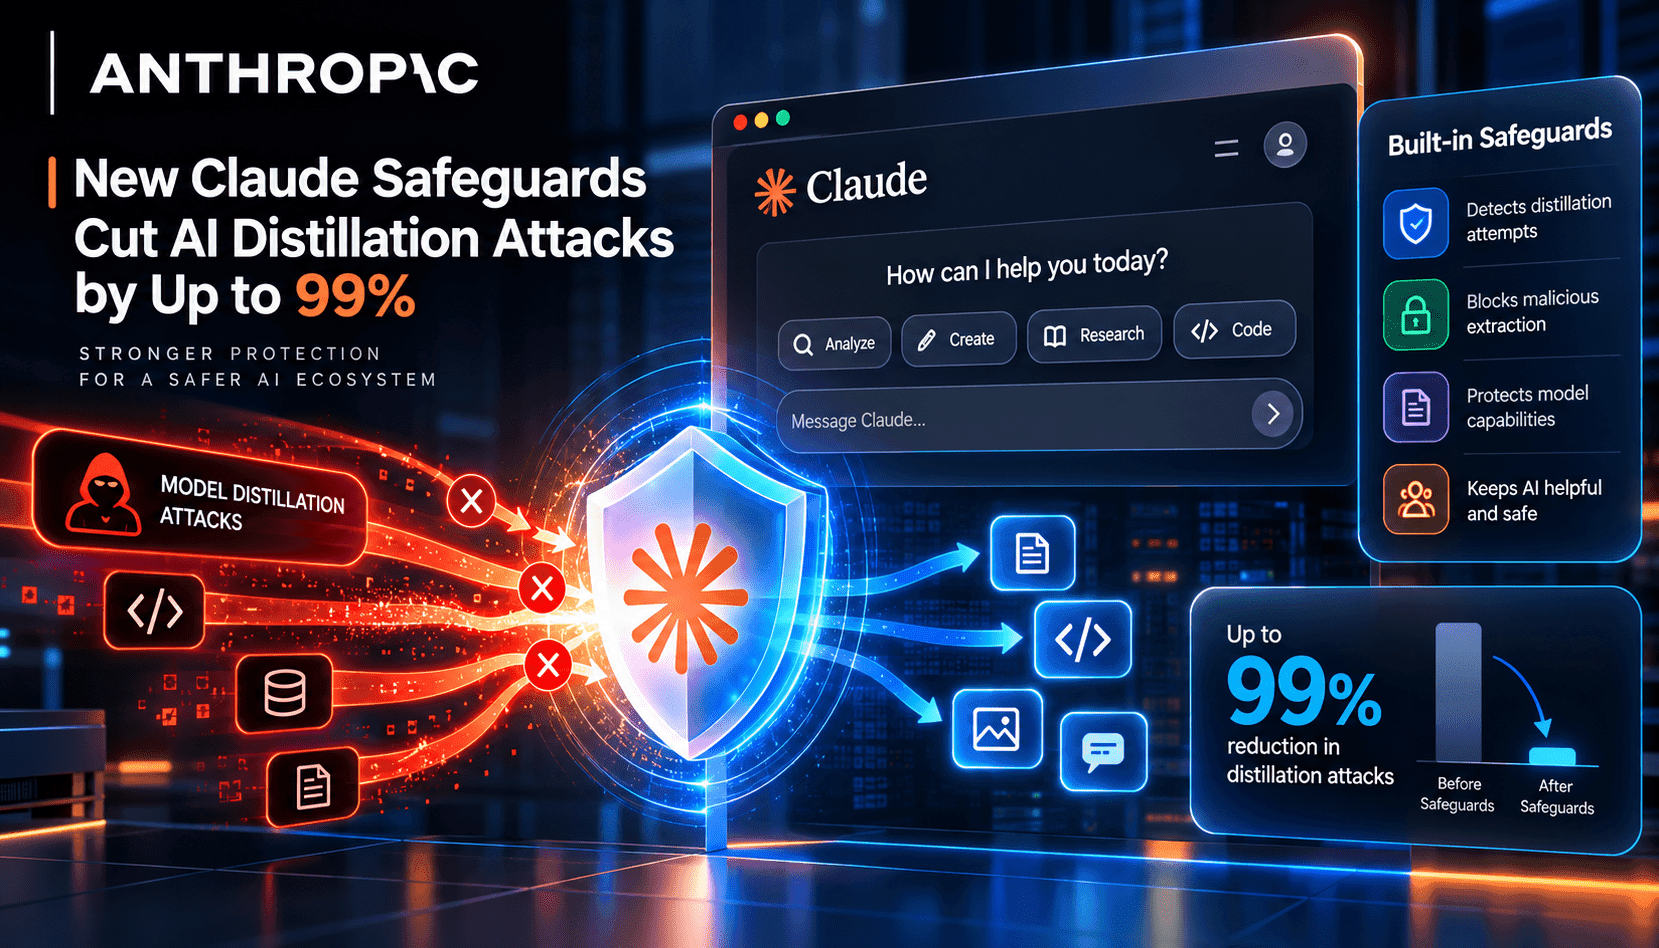
Anthropicの発表は、最先端モデルを提供する企業が直面する、深刻化する最前線の課題を浮き彫りにしている。大規模な蒸留キャンペーンによって、モデルの非公開の推論過程を引き出し、競合システムに取り込もうとする動きだ。ここでいう蒸留は、モデルを小型化するというより、思考を連鎖させる際にモデルが出力する段階的な推論トークンを収集することを指す。Anthropicによると、監視下でのテストでは、新たな保護策によって収集される推論トークンを約90〜99%削減できたという。運営者や利用者にとって重要なのは、高い価値を持つ創発的な能力やプロンプトエンジニアリングの成果が推論過程に表れ、知的財産や潜在的なデュアルユースのリスクもそこに集中するためだ。
競争戦略としての蒸留では、モデルに中間的な推論、思考の連鎖、あるいは重要な要点を明かさせるため、体系的にクエリを送る。その出力は、後続の学習パイプラインに取り込まれる。攻撃者は何百万ものプロンプトを自動送信し、プロキシネットワークや大量のアカウントを経由させ、出力をつなぎ合わせてデータセットを作成する。目的は、学習データやモデルの重みにアクセスせずに能力を再現することだ。大規模な推論情報の抽出が、知的財産の窃取手段であると同時に国家安全保障にも関わる攻撃対象として扱われるようになった理由は、Anthropicの説明から明らかだ。こうした出力を利用すれば、競合モデルは相応の研究開発投資をせずとも、より高度な振る舞いを再現できる可能性がある。
Anthropicは、保護対象の推論へのアクセス制限、プロキシや組織的なリクエストのパターンを検知するアルゴリズム、自動的な利用制限と抽出行為のブロック、蒸留キャンペーンに関与したアカウントの個別停止など、複数の対策を導入したと説明している。また、システム全体の誤検知率は0.1%未満だとしている。これらの対策は、行動分析、ポリシー上の制約、プラットフォームによる執行を組み合わせたものだ。エンタープライズ向けAPIの利用者やプラットフォーム設計者にとって重要なのは、そのトレードオフである。不正な抽出を抑えながら、正当な研究、開発者によるテスト、ファインチューニングのワークフローをどう守るかが問われる。
Anthropicは、Z.aiがGLM-5.3の開発にあたりClaudeの能力を蒸留しようとしたと主張しており、この主張は競争上・法的な重要問題を提起している。公の場で相手を名指しすることで、軍拡競争の様相はいっそう強まる。各社は防御策の強化を公表しつつ、より高度な検知を非公開で導入する一方、攻撃者はプロキシや、目立たない低頻度の抽出、合成的なプロンプト難読化を改良していくだろう。この論争は、責任ある研究をめぐる業界規範にも影響を及ぼす。どの実験が正当で、どこからが不正なのか、中立的な第三者による監査や共通規範をどの範囲で適用すべきかが問われている。
モデルを開発・導入する実務者にとって、実践上の要点は二つある。第一に、プラットフォームの設計には、抽出を防ぐためのテレメトリーと、許容される研究行為や自動化された不正利用の検知基準を定めた明確なAPI利用規約を組み込む必要がある。第二に、プロダクトチームとセキュリティチームは、誤検知や正当な研究との衝突に備えなければならない。知的財産とその後の安全性を守りながらイノベーションを損なわないため、是正の手段、異議申し立ての手続き、研究者向けアクセス階層が必要になる。