

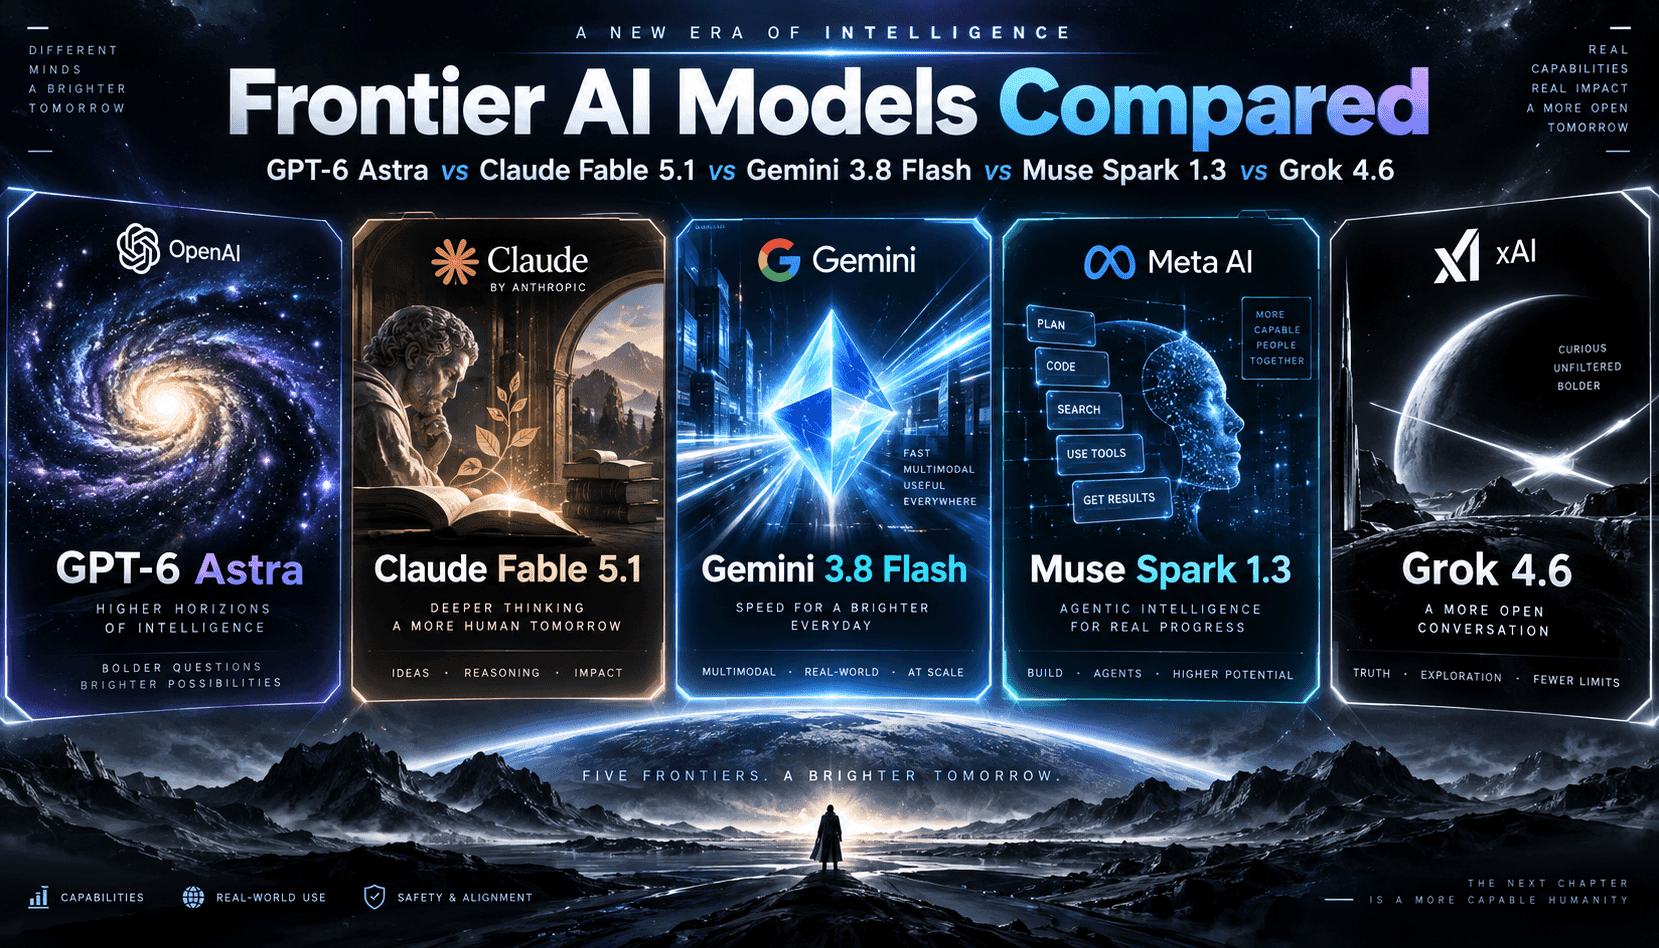
フロンティアモデルの競争は、タスクごとに分かれています。単一の「最高」LLMを追い求めるのではなく、先進チームはモデルをワークロードの種類にマッピングしています:深い推論とコーディング、エージェント的なエンドツーエンドのコンピュータ作業、コスト優位の大量処理パイプライン、そしてバランスの取れたエンジニアリング作業です。この視点で見ると、Claude Fable 5.1は総合的な知能とコードの信頼性で通常リードし、GPT-6 Astraは実際のソフトウェア環境内で最も一貫したエンドツーエンドのオペレーターであり、Gemini 3.8 Flashは大規模ワークロードでコストとレイテンシを圧縮し、Muse Spark 1.3は手頃な価格でエージェント的なオーケストレーションに優れ、Grok 4.6は中価格帯で堅実なコードとエージェント性能を提供しています。
あいまいさの中でのコーディング精度をフロンティアの基準とする開発者にとって、Fableは特に複数ファイルの編集、エッジケースの推論、長期的なリファクタリングを含むテストで最も頻繁にトップの選択肢となります。Astraの純粋なpass@kでのコーディングは接近していますが、モデルにコンピュータ操作を任せる必要がある場合、信頼性の高いツール呼び出し、UIのナビゲーション、介入の少ないループ完結でAstraが優位に立ちます。Grok 4.6は実用的な中間路線に成熟しており、コーディングで競争力を保ちつつ、エージェントの振る舞いと経済性も尊重し、すべてのタスクで最高級の価格を正当化できないチームに適しています。
大量生産ラインの運用—要約、タグ付け、検索強化型Q&A、データクリーンアップ、合成バリアント—においては、Gemini 3.8 Flashがタスクあたりのコストとエンドツーエンドの応答時間で勝る傾向があります。スループットと最初のトークンまでの時間が短いため、より厳しいSLAと安価なオートスケーリングが可能です。ここでは、設計されたプロンプト、構造化出力、蒸留を活用したガードレールが、生のコスト優位性を信頼できるパイプラインに変換します。複数ステップのオフィスや運用の自動化では、Muse Spark 1.3が価値の最適点を捉えています:安定したツール使用と同時実行性を、バックオフィスの幅広いキューでの展開を支える価格で提供します。
見落とされがちですが重要なのは、真のフロンティアの利点は単一ターンのベンチマークスコアだけでなく、運用の信頼性にあります。Astraの魅力は繰り返し可能なエンドツーエンドの成功と低いオペレーター負荷です。Fableの魅力は長期的な推論での論理ミスの少なさです。Gemini Flashの魅力は大規模での予測可能なレイテンシとコスト曲線です。Museの魅力は日常的なワークフローでのエージェント的価値の密度です。Grokの魅力は、コーディングスプリントと軽量エージェントを予算の衝撃なくカバーするバランスの取れた能力です。正解はほとんどの場合単一モデルではなく、多くのチームは2~3モデルを標準化し、ワークロード、信頼度の閾値、予算枠でルーティングしています。