

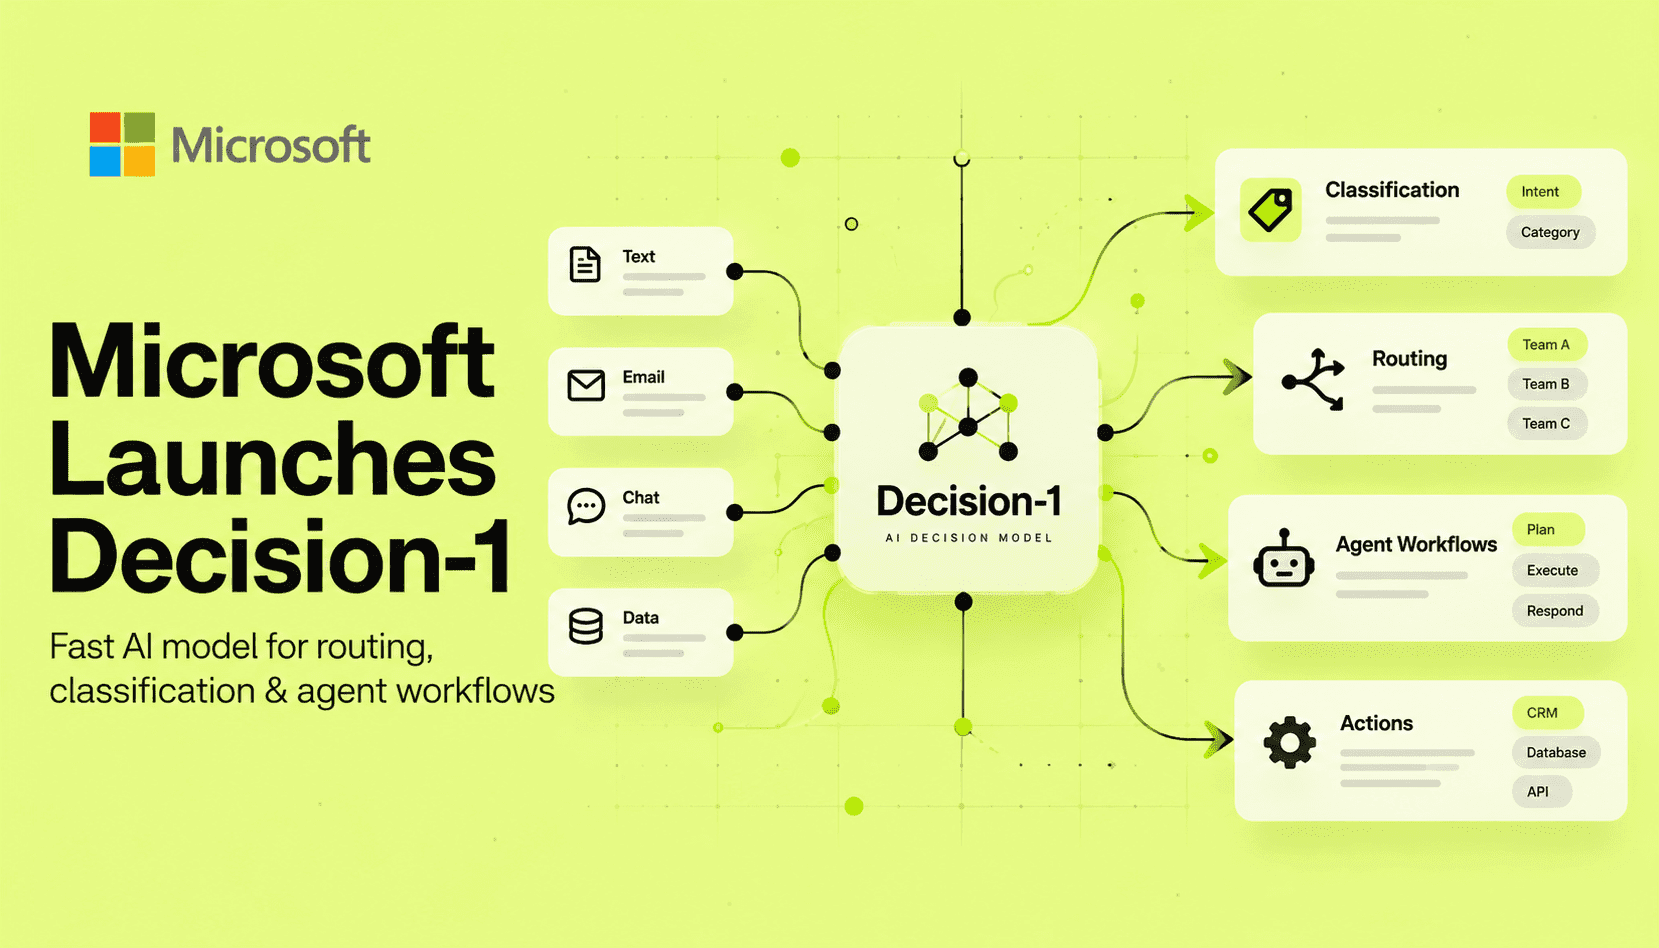
Microsoft-Decision-1は、文章の生成ではなく、選択、順位付け、分類、検証、スコアリングといった判断を必要とするソフトウェア向けに設計された、専用のスコアリングモデルです。流暢な文章の生成に最適化された汎用LLMとは異なり、このモデルは1回の推論で構造化出力と確度調整済みの確率を返します。プロダクトチームにとって、この違いは重要です。判断が中心となる処理を、高コストでレイテンシの大きいLLM呼び出しから、リアルタイムエージェント、Webhook、大量処理のモデレーションパイプラインに適した、軽量で決定論的なスコアリング処理へと置き換えられます。
技術面では、MicrosoftはこのモデルをQwen3.5‑9Bベースと説明しており、確率の較正と低レイテンシの推論に最適化されています。ラベル付きの選択肢ごとに確率を出力するため、ソフトウェアはその確率ベクトルをルーティングや閾値に基づく判断に直接利用できます。これにより、文章生成型LLMとの往復が不要になり、追加の解析やヒューリスティックによる情報抽出も省けます。1回の推論で得られる確度調整済みスコアは、後続のテレメトリーもシンプルにします。高価なプロンプトエンジニアリングや多段階の検証チェーンを使わずに、信頼度を測定し、閾値を調整し、ガードレールを導入できます。
Microsoftが公表したベンチマーク結果は注目に値します。Decision‑1は36種類のベンチマーク比較で精度トップとなり、生成モデルのベースラインより大幅に高速でした。同社のテストでは、GPT-6 Solとの比較で35倍の速度向上が報告されています。レイテンシ、推論あたりのコスト、スループットがプロダクトの制約となる場合、これほどの差は重要です。ただし、ベンチマークの条件、ハードウェア、バッチ処理、データセットの適合性も考慮が必要です。アーキテクチャの変更を決める前に、本番環境と同じスタックで主要なマイクロベンチマークを再現することをおすすめします。
Decision‑1は、軽量な分類器と大規模なLLMの中間に位置づけられます。多様な判断タスク向けに学習・較正されているため、小規模な分類器より用途特化型でありながら、生成LLMで解析と判断を行うより大幅に低コストで高速です。エンジニアリングチームにとって、運用方針は明確です。目的が選択、ルーティング、スコアリング、検証なら、全文生成を伴うLLM呼び出しを置き換え、創作、要約、長文の統合には生成LLMを使いましょう。
意思決定モデルを本番環境に導入する際は、確率の較正、分布シフト、既存のエージェント用ツールチェーンとの統合に注意が必要です。信頼度の閾値を計測できるようにし、較正の劣化やデータドリフトが見られた場合に生成LLMへ切り替えるフォールバックを用意しましょう。また、ビジネス固有のクラスやコスト目標に合わせて、学習と評価を繰り返す必要があります。適切に実装すれば、Decision‑1は判断中心のフローにおけるレイテンシと推論コストを削減し、システムの決定性を高められます。