

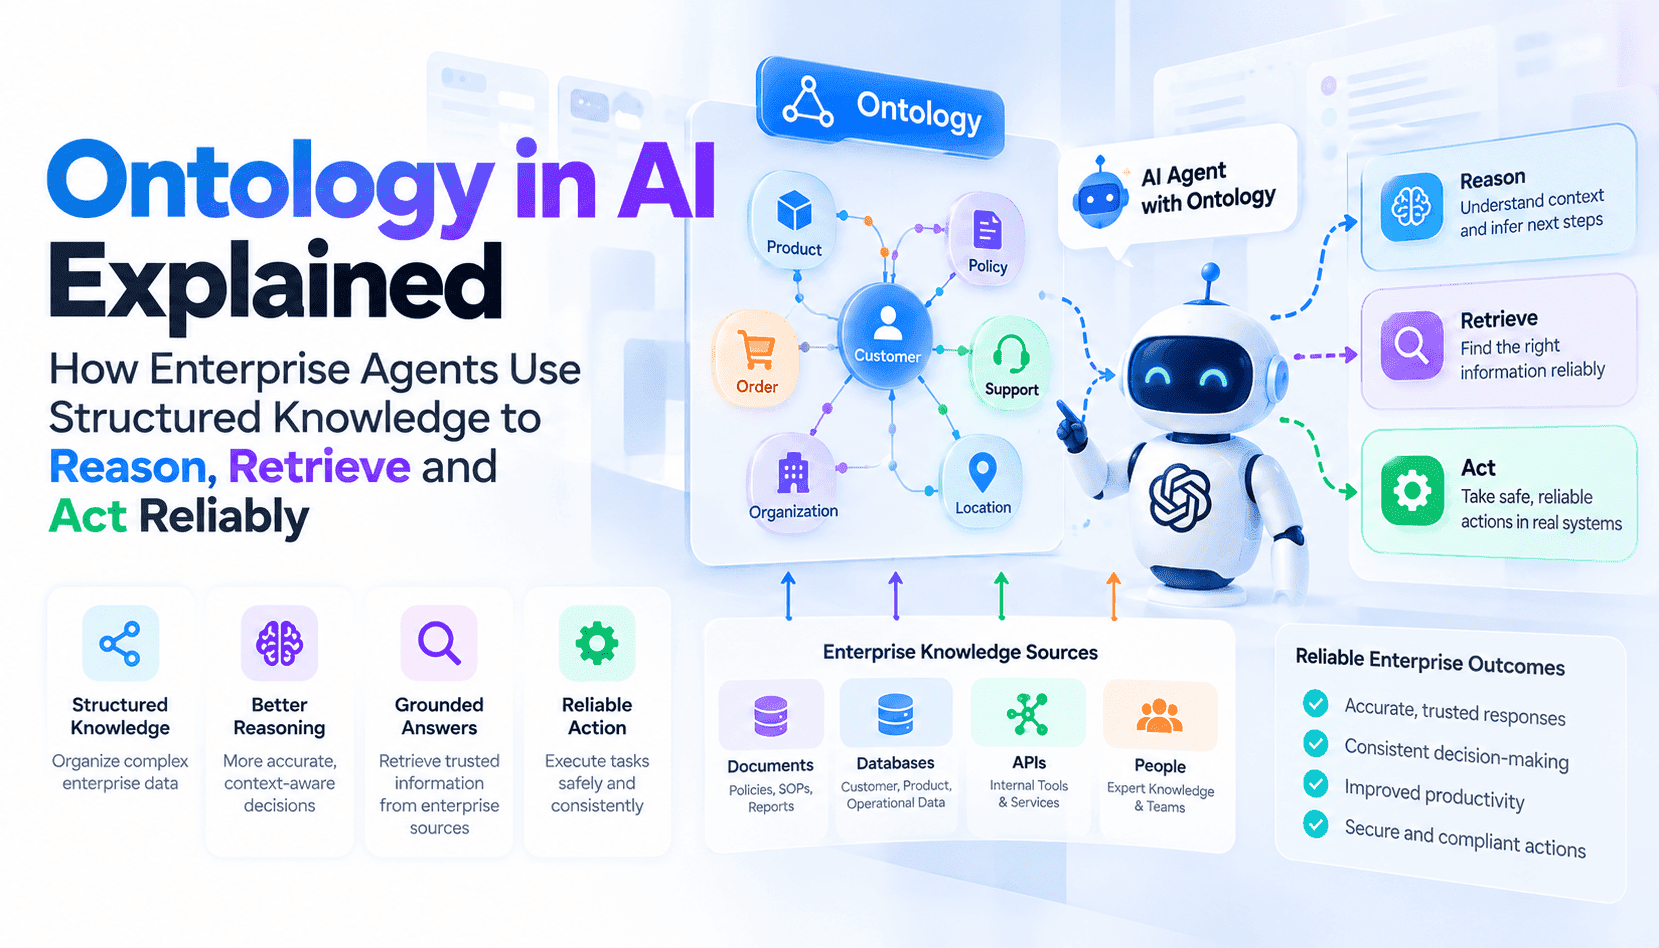
エンタープライズAIでは、コネクター、データウェアハウス、検索手法など、データをつなぐ仕組みの整備はほぼ完了しています。いま難しいのは、大規模な環境でも意味を一貫して捉えることです。エージェントはあらゆるテーブルを検索できても、「customer_status」や「revenue」のようなフィールドを誤解することがあります。オントロジーは、ビジネス上の概念とその属性、関係、公理を記述することでこの問題を解決し、AIシステムがデータを単なるラベルのないトークンやスキーマ要素として扱うのではなく、その意味を推論できるようにします。この変化は、自動引受から経営レポートまで、後続の意思決定にとって重要です。プログラムによる誤りが繰り返されると、影響が積み重なるためです。
この記事では、ユースケースを起点に実践的な方法で解説します。エージェントに役立つオントロジーの構成要素を説明し、タクソノミー、ナレッジグラフ、セマンティックレイヤーとの違いを示します。また、顧客リスクプロファイル、売上指標、保険金請求などの具体例を通じて、実行時にエージェントが必要とするガバナンス、データリネージ、アクセス制御の手がかりを紹介します。目指すのは、運用に活かせる設計です。追跡可能性と信頼できる定義を備え、制御を適用する仕組みを持つAI対応のオントロジーを構築することで、エージェントが適切なデータとアクションを選び、人間が判断を確信を持って監査できるようにします。
オントロジーによって推論が可能になります。カタログやタクソノミーがデータ資産を分類するのに対し、公理を使えば、明示的には保存されていない事実もエージェントが導き出せます。たとえば、個人情報(PII)を含むデータセットには制限付きアクセスが適用される、納税者番号が一致する2つのレコードは同一の法人を指す、あるいはサブスクリプションが失効しても顧客に対する義務は終了しない、といった推論です。こうした推論は、壊れやすいルールの羅列を減らし、実行時の判断をより堅牢にします。ただし、そのためにはクラス、インスタンス、属性、有向関係、形式的な制約を意図的にモデル化し、物理データや所有者、ポリシーに対応づける必要があります。
最後に、最初の4〜8週間で実践できる軽量な実装フレームワークを紹介します。まず、単一の意思決定またはエージェントのワークフローを選び、影響の大きい概念を20〜50個モデル化します。次に、推論に必要な関係と公理を定義し、各概念をデータリネージ、品質スコア、アクセスルールにすぐに紐づけます。導入数だけでなく、推論の正確性、追跡可能性、アクセス制御への対応を測定して成果を評価しましょう。そうすれば、オントロジーは文書化のためだけの仕組みとして劣化することなく、AIの活用拡大に合わせて成長する、生きたガバナンス資産になります。