

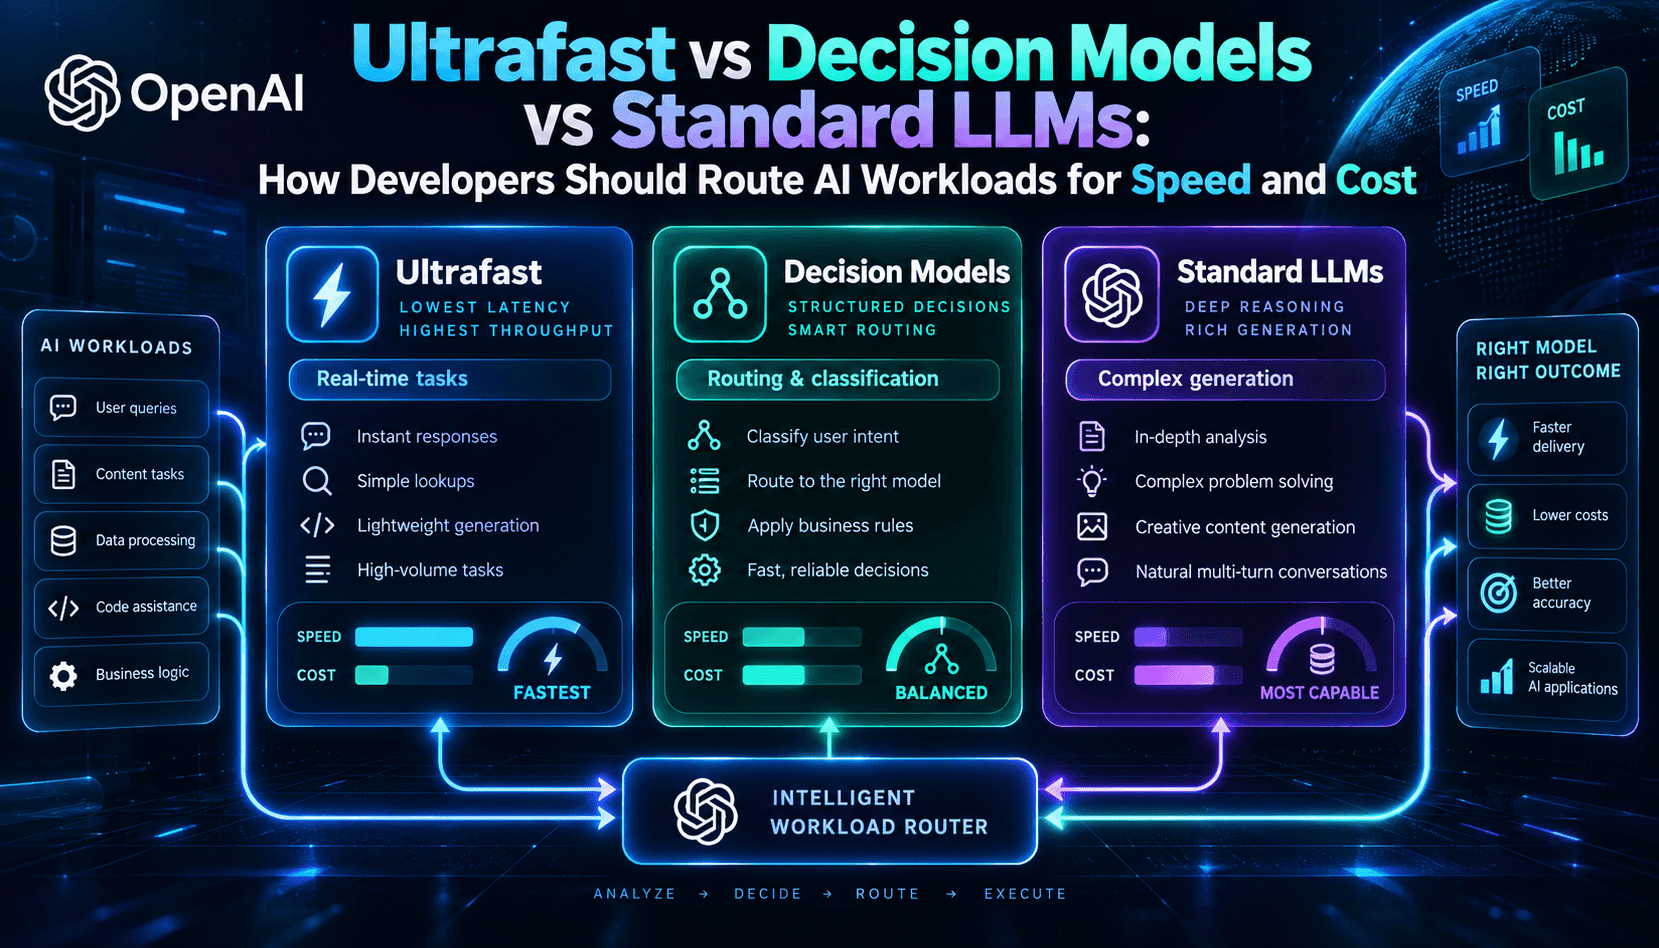
開発者は、あらゆる処理を最も高性能なモデルに送るか、それとも安価で高速な専用エンドポイントに振り分けるかという、よくあるアーキテクチャ上の選択に直面します。OpenAIが最近追加したGPT-6.1 Sol UltrafastとGPT-6 Luna Decisionsにより、この選択をより具体的に判断できるようになりました。Ultrafast Solは生成処理におけるトークン出力のレイテンシを抑え、Luna Decisionsは型付きの回答や判断を、フル機能のResponsesエンドポイントよりおよそ一桁高いスループットで提供します。この記事では、こうしたプラットフォームの進化を、今日から導入できる実践的なルーティングパターンに落とし込みます。
振り分けを始める前に、ワークロードを4つの観点で分類しましょう。必要な推論の深さ(簡単な分類か、深い思考の連鎖か)、許容できるレイテンシ(100ms未満のUIか、数秒かかるバッチ処理か)、出力形式(型付きの判断か、自由形式のテキストか)、そしてコストへの敏感さです。たとえば、短く決定的な分類やルーティングのタスクなら、多くの場合Decisions APIだけで十分です。豊かな創造性を要する対話型生成には、完全な推論能力を備えたSolやAstraの各モデルが適しています。UIで大量のトークンをストリーミングする場合は、Ultrafastティアが最も効果を発揮します。ワークロードをこれらの観点で整理すれば、高価な最先端モデルの使いすぎを防げます。
実運用では、相互に補完する3つのルーティング経路を用意します。構造化された大量の判断や分類にはDecisions経路(Luna)、低レイテンシのトークンストリーミングや対話型UIにはUltrafast生成経路(service_tier:"ultrafast"を指定したGPT-6.1 Sol)、複雑な推論、コード生成、複数ステップのツール利用には推論経路(GPT-6 Sol/Astra)を使います。プロンプトのサイズ、想定される推論の負荷、レイテンシの上限、構造化された型付き出力が必要かどうかといったメタデータに基づいて経路を選ぶ、軽量なルーターを追加しましょう。
具体例として、スパム検出、意図の振り分け、機能フラグの判定、簡単な分類、型付き出力にはDecisionsを使います。ストリーミングチャット、オートコンプリート、リアルタイムの提案など、多少熟考が減っても即時の応答を優先するUI体験にはUltrafastが適しています。コード生成、複数ステップの分析、またはツール呼び出しや長文の推論が結果を大きく左右する場面では、完全な推論モデルを使いましょう。こうしたパターンにより、重要な場面で精度を維持しながら、全体のコストを削減できます。