

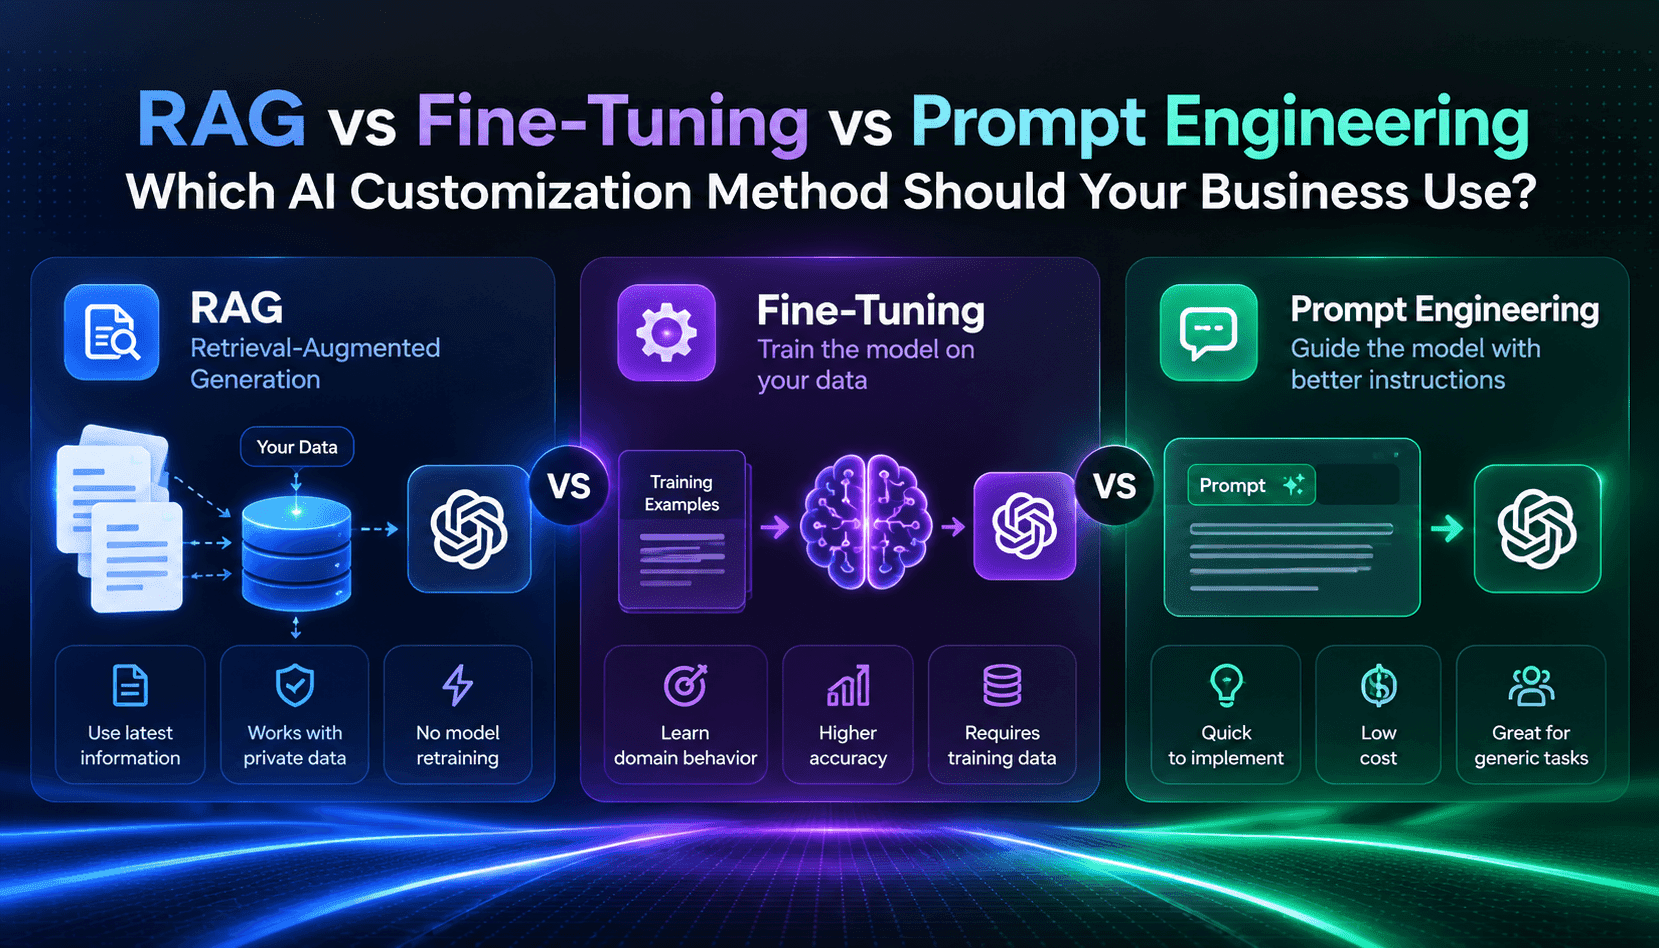
プロンプトエンジニアリング、検索拡張生成(RAG)、ファインチューニングのどれを選ぶかは、手法の優劣を比べることではなく、直面している課題に合った手段を見極めることが重要です。プロンプトエンジニアリングは、モデル自体を変えずに指示を調整し、回答の質を高めます。RAGは、最新情報や独自情報、専門分野の知識を実行時にモデルへ提供し、新しい事実に基づく推論を可能にします。ファインチューニングは、厳選した例を使って学習させ、モデルの振る舞いを変えることで、一貫性を高め、再現性の高い出力を実現します。それぞれ、精度、レイテンシ、運用コスト、データの取り扱い、保守負担への影響は異なります。最適な選択は、具体的なビジネス上の制約と、そのタスクで失敗した場合のコストによって決まります。
最適化に着手する際は、まず現状を診断しましょう。意思決定に影響するエラーを定義し、失敗時のコストを測定したうえで、プロンプトを使ったベースラインを作成します。翻訳、要約、小規模な分類、定型文の生成など、多くのタスクは、丁寧なプロンプト設計と少数例の提示によって、短期間で本番レベルの品質に達します。最新情報や社内文書が不足しているために回答が誤る場合は、比較的少ない開発負担で精度を高められるRAGが有効です。一方、書式やトーン、再現性の高い分類といった振る舞いに起因するエラーがある場合や、大規模運用で一貫性があり監査可能な出力が必要な場合は、データや運用のコストが高くてもファインチューニングを検討する価値があります。
導入にかかるコストも重要です。プロンプトエンジニアリングは低コストかつ迅速に始められます。プロンプトを反復的に改善し、例を追加して、出力を計測すればよいからです。RAGでは、検索パイプラインの構築、文書のインデックス化、関連性の調整が必要です。レイテンシが増し、データガバナンスの対象も広がる一方、モデルを変更せずに知識を最新の状態に保てます。ファインチューニングには、厳選したラベル付きデータ(多くの場合50~500件以上)、モデルの学習と提供、バージョン管理、仕様変更に応じた再学習、安全性のための管理策が必要です。本番環境で信頼性の高いシステムを構築するには、振る舞いを整えたファインチューニング済みモデルにRAGを組み合わせ、さらに決定論的な後処理やバリデーターを使って、ハルシネーションを抑える方法もよく採用されます。
このガイドでは、カスタマーサポート、社内ナレッジアシスタント、文書分析、構造化データの生成、専門分野向けの文章作成、特化型分類などのシナリオを取り上げ、シンプルな判断マトリクスと実践手順を紹介します。プロダクトやエンジニアリングのリーダーが、必要最小限の手段を選び、次の段階へ進むタイミングを判断し、本番環境でのプライバシー、レイテンシ、保守性を考慮した設計を行えるようにすることが目的です。