

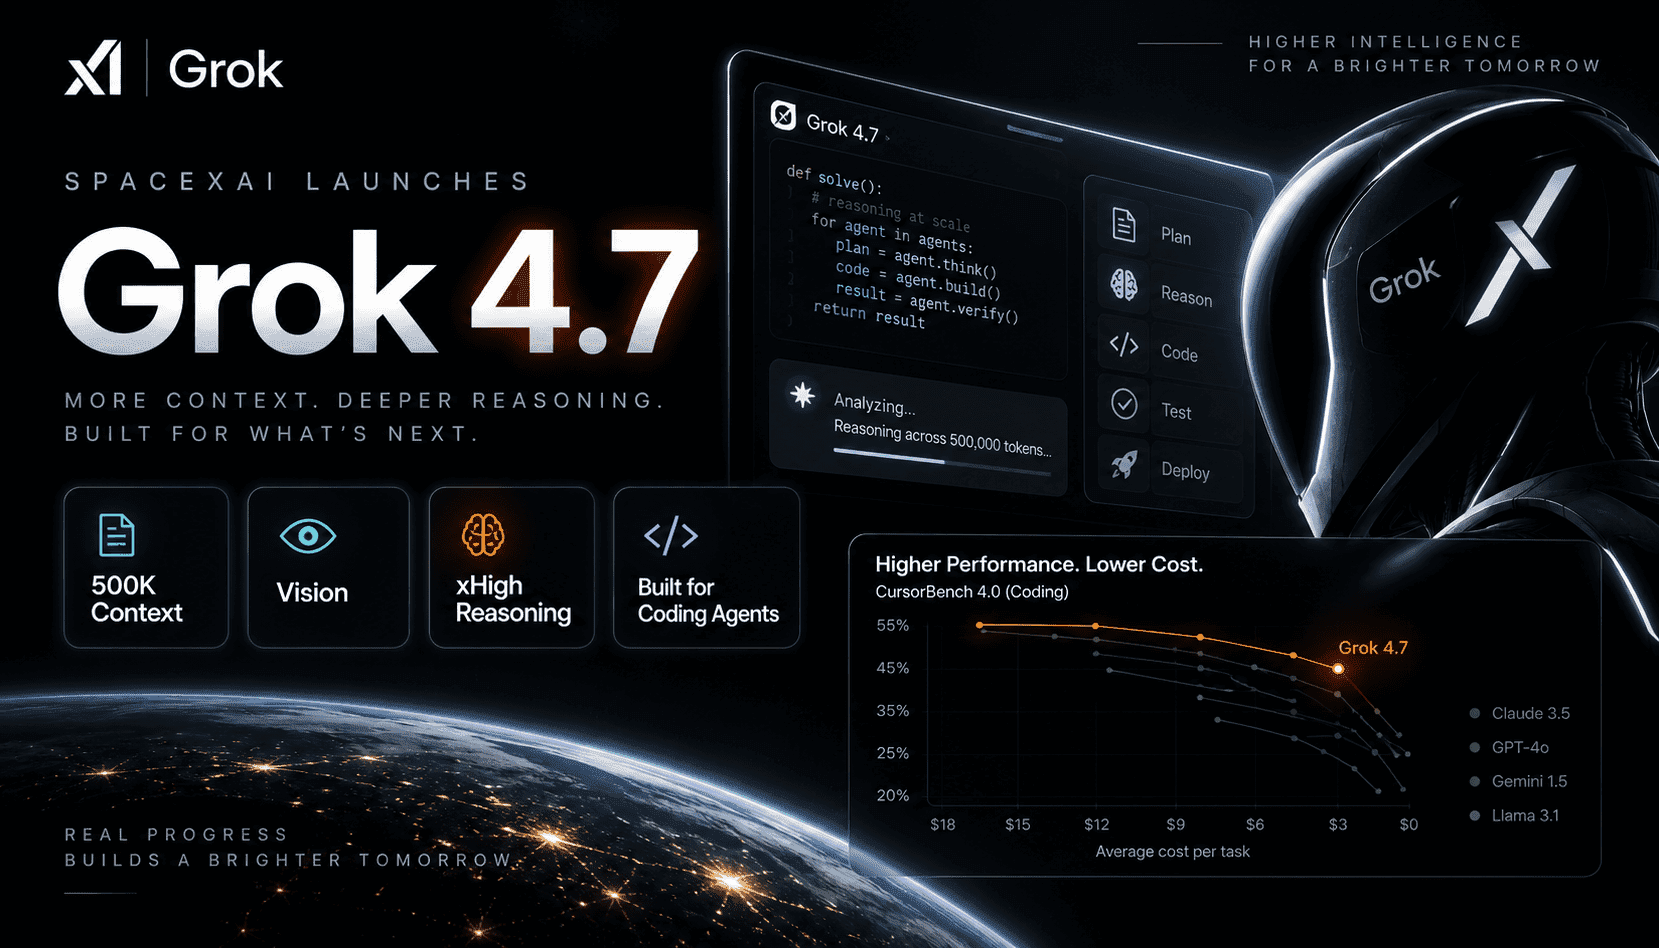
SpaceXAIのGrok 4.7は、持続的なコーディングと知識作業のために設計されています。50万トークンのコンテキストウィンドウにより、リポジトリ全体や複数ファイルの差分、大規模な仕様書をメモリに保持できるため、検索の手間が大幅に減少します。モデルのネイティブビジョンは、デバッグ用スクリーンショットの解析、チャートのレビュー、UI状態の説明などに役立ちます。最も重要なのは、4.7がxHigh推論と自己検証を重視し、ツール間の受け渡しを減らしてより長く信頼性の高い多段階処理を可能にしている点です。4.6と同価格帯で高速バリアントも用意されており、開発者環境、コーディングエージェント、そして以前のコンテキストや検証の制約が摩擦となっていた数時間にわたる専門的なタスクを直接ターゲットにしています。
初期の指標では、長時間のコードタスクにおける価格性能比が高く、CursorBench 4.0での改善や数時間に及ぶオフィス作業やターミナル作業での耐久性向上が示されています。DeepSWEやEEBenchでの成果は、技術領域における推論の忠実度とエラー回復力の強化を示唆しており、モデルのハーネス認識トレーニングはエージェントワークフローにおける会話の逸脱を減らすことを目指しています。長いコンテキストと安全なデフォルト設定の組み合わせにより、アーキテクチャの簡素化が期待されます:チャンク分割の工夫が減り、リトリーバーが軽量化され、プロンプトの構造も小さくなります。大規模な仕様書やコンプライアンス文書を扱うチームにとっては、4.7の拡張された作業メモリにより、複数回の処理フローを単一パスの計画に変換し、コンテキスト内のスクラッチパッドや構造化された自己検証を活用できるでしょう。
安全性も著しく強化されています。新しいセーフガードスタックは、ジャイルブレイク耐性の向上とデュアルユースの取り扱い改善を報告しており、正当なセキュリティ作業を過剰にブロックすることなく対応します。これは、エージェントシステムがターミナル、コード実行、機密データと交差する企業導入において重要です。運用面では、4.7はAPI、コーディングハーネス、ルーター経由で利用可能で、入力トークン100万あたり2ドル、出力トークン100万あたり6ドルの価格設定で、速度と価格が2倍のオプションの高速ティアもあります。チームは実際のワークロードで直接比較テストを行い、タスク完了の品質、ツール呼び出しの信頼性、完了タスクあたりの総コストを測定すべきであり、単なるレイテンシやベンチマークスコアだけで判断すべきではありません。