

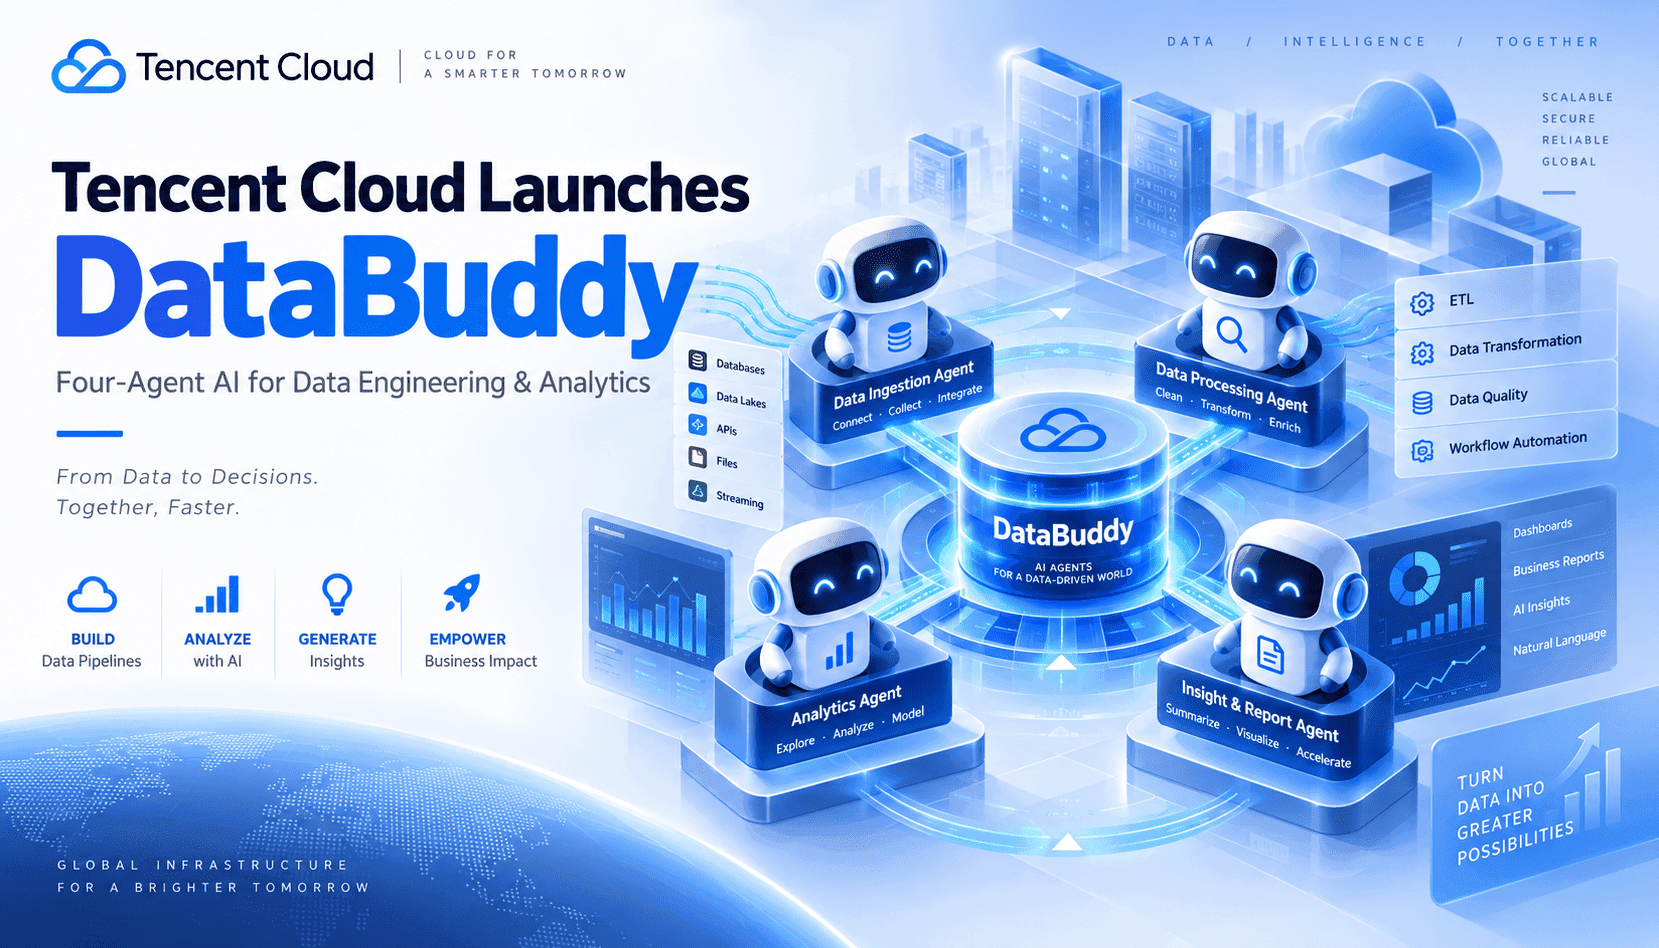
Tencent CloudのDataBuddyは、企業の最も深刻なデータ課題である遅延しがちなチケット駆動型のETLやBI変更に対応するため、4つのエージェントパターンをサービスとして提供します。過剰に負荷のかかったエンジニアに依頼を回す代わりに、DataBuddyはエージェントを調整してパイプラインを組み立て、SQLを作成し、ガバナンスルールの下で出力を説明します。このアプローチは意見を持ちつつも実用的で、ルーチンのデータ作業をエージェントの役割にコード化し、サービスとして測定し、人間はアクセス、プライバシー、コストのレビューに関与します。この変革はDevOpsの成熟過程に似ており、ツール、オートメーション、ポリシーがヒーロー的対応やスプレッドシートに取って代わっています。
内部では、1つのエージェントがタスクを計画し、1つがデータエンジニアのようにコネクタ、変換、SQLを生成し、3つ目がアナリストとしてインサイトやナラティブを作成し、4つ目が品質とポリシーの整合性をチェックします。最後の役割は重要で、スキーマの前提、結合、リークリスク、PIIの露出をダッシュボードやノートブックに送る前に検証します。適切に計測されれば、ログはプロンプト、意思決定、生成コード、系譜を記録し、チームは結果を再現し、変更をロールバックし、データセットごとにエージェントのパフォーマンスを比較できます。これは信頼と監査に不可欠です。
DataBuddyは、レイクハウスと利用者の間に位置するコントロールプレーンと考えてください。既存のSpark/SQLジョブ、コストガバナンス、カタログツールを置き換えるのではなく補完することを意図しています。適用に適したのは、バックログが多いBI変更、ポリシーを守りつつ行うアドホックな探索、繰り返しの取り込みやデータ品質タスクです。企業レベルの課題としては、ID管理、カタログ、VPCネットワークへの結合方法、テーブル・カラムレベルでの最小権限の適用、スループットを阻害せずに支出上限を設定する計算リソースの割り当てが挙げられます。
意思決定の枠組みとしては、限定されたドメイン(例:営業オペレーションやマーケティングアトリビューション)、既知のファクトテーブル、信頼できる2つのディメンションでパイロットを行います。合否基準を定め、初回インサイトまでの時間、ゴールドSQLとのクエリ精度、検出されたデータ品質違反、成功タスクあたりのコストを測定します。出力は新たなサイロではなく既存のダッシュボードに送ります。ポリシー例外には人間のレビュアーを必ず含めます。パイロットが基準を満たせば、ランダムなテーブルではなくデータプロダクトを追加してスケールし、各プロダクトをSLA、系譜、テスト、アラートを備えた契約として扱い、DataBuddyのエージェントが実行層となります。