


Datology AI
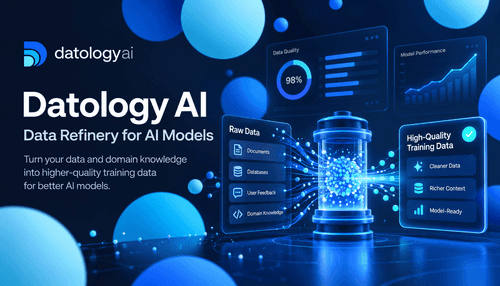
NexusAi 요약: Datology는 기업 및 공개 데이터를 정제해 중간 학습이나 사전 학습에 사용할 엄선된 학습 데이터셋을 만듭니다. 데이터 처리 파이프라인을 통해 토큰당 유효 정보를 높여 더 작고 빠른 모델을 구현하고, 측정 가능한 평가 성능 향상과 프라이빗 클라우드 배포를 지원합니다.
NexusAi 개요
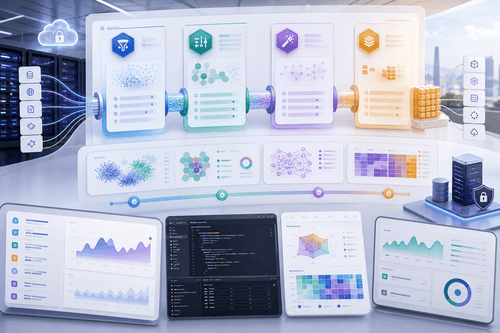
Datology는 기업 및 웹 데이터를 수집하고 형식 오류와 평가 데이터 오염을 제거한 뒤, 품질 필터와 작업 분류 체계를 적용합니다. 데이터가 부족한 영역은 합성 데이터를 생성해 범위를 넓히고, 이후 하위 단계 평가에 맞춘 엄선된 데이터 조합을 단계별 학습 데이터셋으로 제공합니다.
주요 기능
맞춤형 파운데이션 모델을 만들거나 오픈 모델을 특정 분야의 작업에 맞게 조정하는 ML 연구자, 데이터 엔지니어, 기술 도입 담당자에게 적합합니다. 법률, 검색, 음성 및 특정 산업에 특화된 워크플로를 운영하는 팀은 독점 말뭉치와 도메인 지식이 일반적인 사전 학습 데이터와 비교해 모델 동작에 실질적인 변화를 가져올 때 특히 큰 효과를 얻을 수 있습니다.
- 정제 단계에서는 형식이 잘못되었거나 평가 데이터가 섞인 문서를 대규모로 제거합니다.
- 보정 단계에서는 구체적인 목표에 맞춰 품질, 작업, 분류 체계별로 데이터를 조정합니다.
- 생성 단계에서는 작업 적합성과 다양성을 높이는 맞춤형 예시를 합성합니다.
- 구성 단계에서는 여러 출처의 데이터를 최적으로 조합해 학습 실행에 적합한 단계별 데이터셋을 만듭니다.
- 프라이빗 클라우드에 배포해 독점 데이터를 안전하게 보호하고 감사 가능성을 유지합니다.
검증된 성과
고객의 관점
먼저 데모를 예약하고 데이터셋의 용도를 공유하세요. Datology는 온보딩 과정에서 일반적인 저장소용 커넥터, 감사를 우선하는 큐레이션 스튜디오, 학습 프레임워크용 내보내기 형식을 제공합니다. 팀은 프라이빗 클라우드 또는 외부 네트워크와 분리된 인프라에서 데이터 정제 파이프라인을 실행할 수 있습니다. 초기 프로젝트는 일반적으로 범위를 좁힌 중간 학습 과정이나 엄선된 사전 학습 말뭉치에 초점을 맞춥니다. 제품과 함께 제공되는 문서와 연구 자료를 활용하면 큐레이션 결정을 재현하고 학습 후 성능 증폭 효과를 측정할 수 있습니다.
NexusAi: “그들은 우리가 아는 것을 알고 있습니다. 더 많은 컴퓨팅 자원으로 얻으려는 성능 향상의 대부분은 아직 데이터 안에 그대로 묻혀 있습니다.” — Thomson Reuters 리서치 총괄
시작하기
Datology는 연구 및 프로덕션 실무를 큐레이션 파이프라인에 결합해 학습 신호를 개선하고 모델 성능을 끌어올립니다. 데이터 오염 제거, 목적형 합성 데이터 생성, 단계별 데이터 구성으로 도메인 작업에 필요한 더 작고 빠른 모델을 구현하는 동시에 기업 수준의 개인정보 보호와 감사 가능성을 유지합니다.
도구를 열고 핵심 제품 경험을 검토하세요.
계정을 만들거나 기존 워크스페이스에 접속하세요.
자신의 작업으로 속도, 품질, 적합성을 판단하세요.
최종 결정 전에 유사한 AI 도구를 확인하세요.
Datology AI
DatologyAI는 기업 및 웹 데이터를 유효 정보가 풍부한 학습 말뭉치로 전환하는 데 주력하는 전문 데이터 엔지니어링 기업입니다. 연구 역량과 프로덕션 도구를 결합해 모델 개발자가 엄선된 데이터셋을 재현 가능하고 실제 배포 가능한 형태로 활용할 수 있도록 지원합니다.
Datology는 독점 데이터, 라이선스 데이터, 공개 웹 데이터를 모델 개발자를 위한 고품질 학습 데이터로 전환하는 데이터 정제 플랫폼입니다. 고객 데이터만 사용하며 토큰을 판매하거나 외부에서 조달하지 않습니다. 4단계 파이프라인을 적용해 노이즈와 평가 데이터 오염을 제거하고, 품질과 분류 체계를 조정하며, 합성 데이터를 생성해 작업 적합성을 높이고, 단계별 학습용 말뭉치를 구성합니다. Datology는 중간 학습 및 사전 학습 워크플로를 지원하고 기존 데이터 저장소 및 수집 시스템과 연동됩니다. 최첨단 규모에서도 경쟁력을 입증한 연구 수준의 도구를 제공합니다. 그 결과 토큰당 유효 정보가 늘고, 동일한 성능을 내는 데 필요한 컴퓨팅 비용이 줄며, 프라이빗 클라우드 배포와 규정 준수 옵션을 활용할 수 있습니다.
Datology AI 방문
댓글 (0)
댓글이 없습니다