

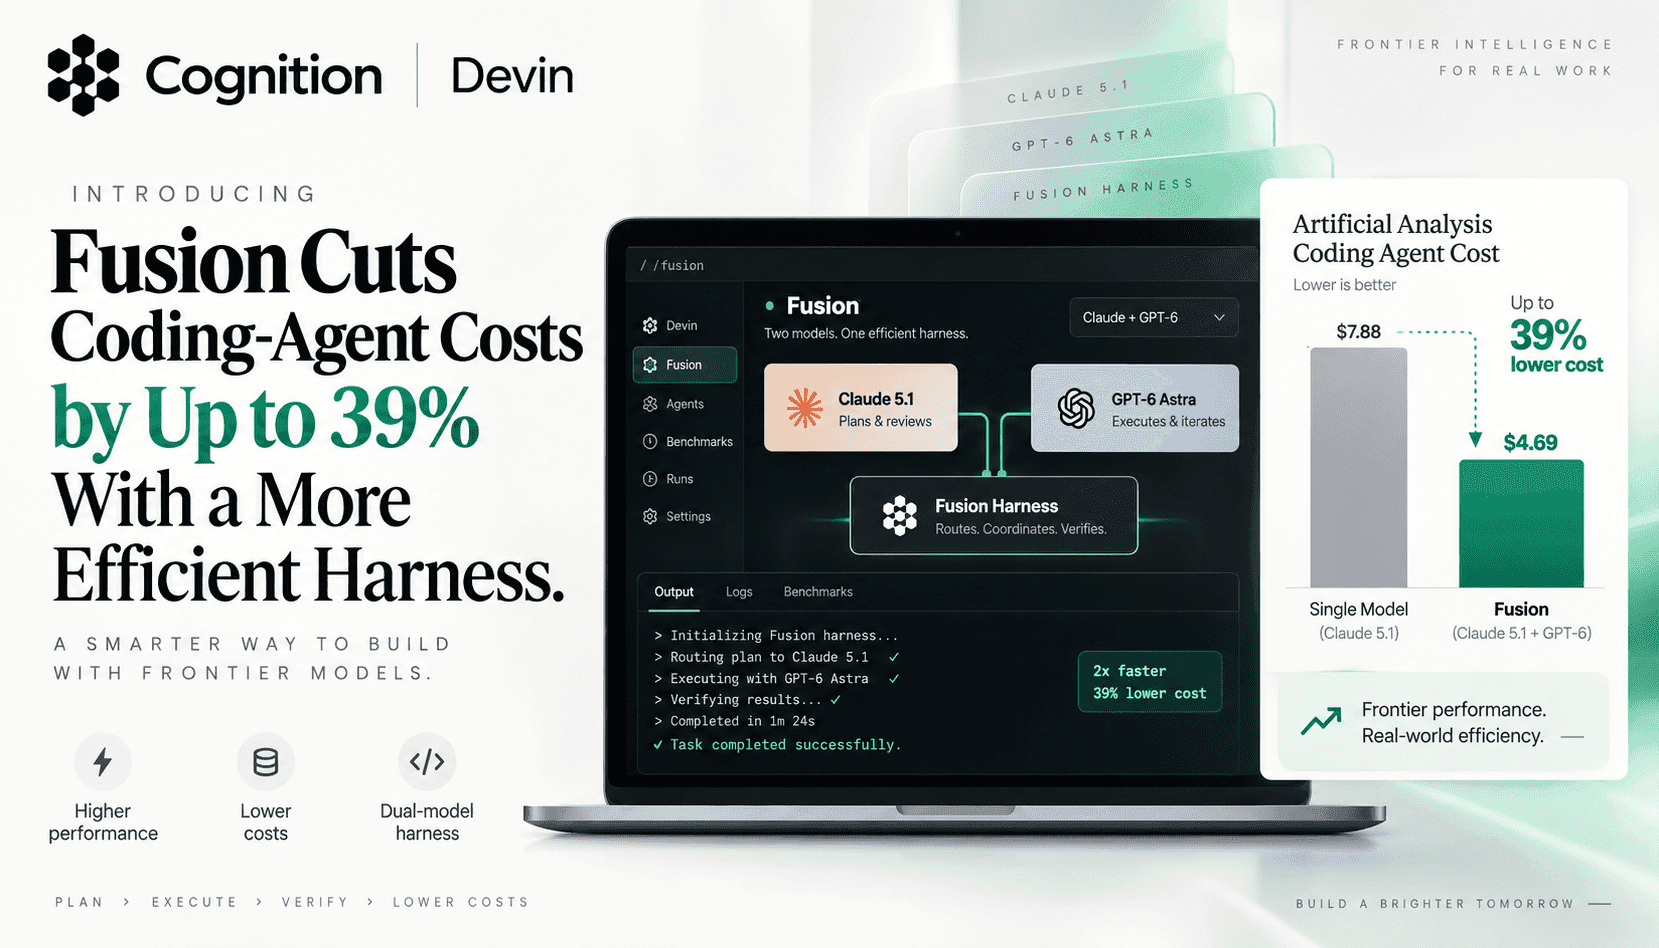
Fusion은 코딩 작업을 위해 설계된 두 에이전트 하네스입니다: 최첨단 리드 모델이 계획과 검토를 담당하고, 더 저렴한 사이드킥이 실행을 맡습니다. 전체 대화를 모델 간에 전달하는 대신, 두 에이전트는 구조화된 브리프와 결과를 교환하며 각자 지속적인 컨텍스트를 구축합니다. 이 분리는 중요합니다. 스레드 중간에 모델을 교체하면 캐시가 손상되고 재작업이 발생하기 쉽습니다. Fusion에서는 브리프 기반 위임이 컨텍스트를 안정적으로 유지하고, 사이드킥이 빠르게 구현하며, 비용이 많이 드는 추론은 리드의 체크포인트에 집중됩니다. 보고된 벤치마크에 따르면, 그 결과는 특히 안정적인 실행이 토큰 예산을 지배하는 작업에서 의미 있게 낮은 비용으로 최첨단 수준의 품질을 제공합니다.
전략적 전환은 모델 선택에서 오케스트레이션 품질로 이동합니다. 토큰당 가격은 더 나은 계획자가 더 간결한 브리프를 작성하고, 재시도가 적으며, 리드-사이드킥 간 불필요한 소통을 최소화한다는 현실을 과소평가합니다. 실제로 더 강력한(때로는 더 비싼) 리드는 더 일찍 위임하고 검토를 줄여 시스템 비용을 낮출 수 있습니다. 마찬가지로, 더 유능한 사이드킥은 토큰당 비용이 더 높을 수 있지만, 처음부터 구현을 정확히 하여 전체 턴 수를 줄입니다. 이것이 Fusion의 주장이 공감을 얻는 이유입니다: 그들은 작업당 가격 개념을 실현하여 계획, 실행, 검토를 조화롭게 연결하고 캐시를 보호하며 불필요한 작업을 줄이는 워크플로우를 만듭니다.
구매자에게는 평가 체크리스트를 재설정하는 계기가 됩니다. 벤치마크는 여전히 중요하지만, 이제 의미 있는 질문은 하네스 정책에 관한 것입니다: 계획은 어떻게 수립되는가, 무엇이 위임되는가, 리드는 얼마나 자주 검토하는가, 오류는 어떻게 확대되는가. Astra나 Claude와 같은 리드를 시험하는 팀은 작업 단위로 비용, 시간, 품질을 측정하고, 토큰과 턴이 실제로 각 단계(계획, 설정, 구현, 디버그, 검증, 마무리)에서 어떻게 분포하는지 기록해야 합니다. 대부분의 비용이 구현과 디버깅에 집중된다면, 지속적인 컨텍스트와 프롬프트 캐싱을 갖춘 이중 에이전트 하네스가 단순 라우팅이나 단일 모델 루프보다 뛰어날 가능성이 큽니다.
도입은 완전한 무노력은 아닙니다. 위임 브리프는 선택한 에이전트 쌍에 맞게 조정되어야 하며, 사이드킥의 자율성은 능력에 따라 확장되어야 합니다. 계획을 형성하는 탐색은 일반적으로 리드가 담당해야 하며, 사이드킥이 오독을 피할 만큼 충분히 강하지 않으면 탐색을 넘겨서는 안 됩니다. 조직은 또한 거버넌스가 필요합니다: 추적 가능한 검토 체크포인트, 캐시 간 재현 가능한 실행, 사이드킥이 도구나 권한을 과도하게 사용하는 것을 방지하는 가드레일. 하지만 장점은 매력적입니다: 최첨단 지능을 집중하는 안정적인 계획 채널과 비용이 많이 드는 두뇌를 반복적으로 깨우지 않고 빠르게 코드 변경을 처리하는 실행 채널입니다.