

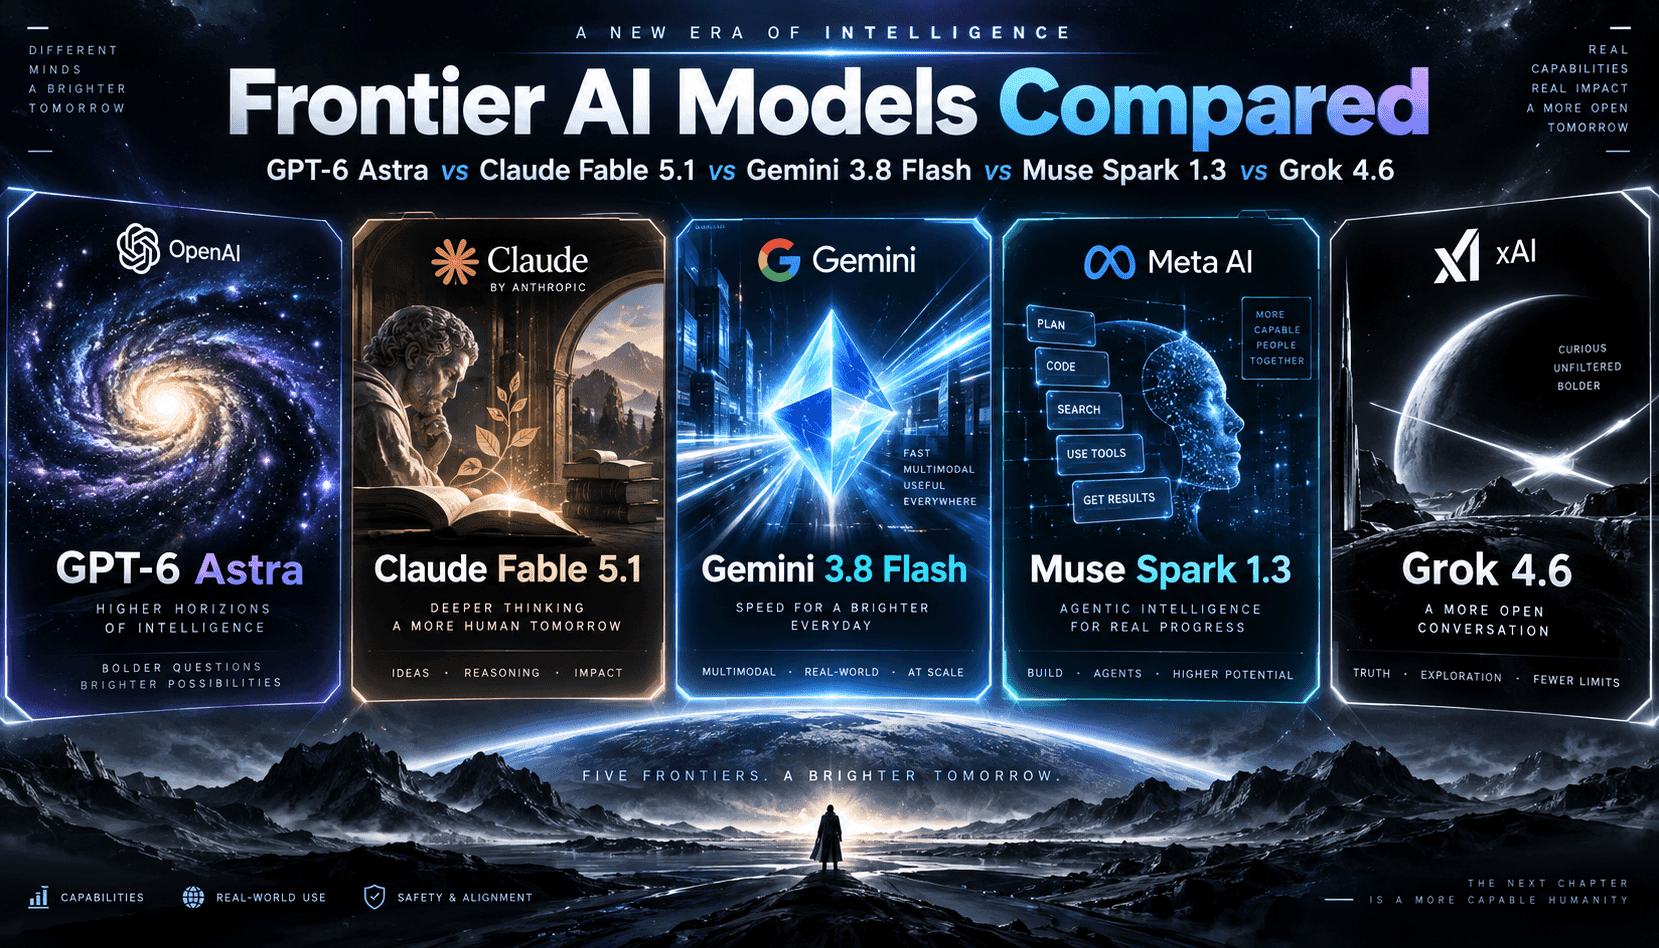
프론티어 모델 경쟁은 수행 작업별로 분화되었습니다. 단일 “최고” LLM을 쫓는 대신, 선도 팀들은 모델을 작업 부하 유형에 맞춰 분류하고 있습니다: 심층 추론과 코딩, 에이전트 기반 엔드투엔드 컴퓨터 작업, 비용 중심의 대량 처리 파이프라인, 그리고 균형 잡힌 엔지니어링 작업. 이 관점에서 Claude Fable 5.1은 종합 지능과 코드 신뢰성에서 보통 선두를 차지하며, GPT-6 Astra는 실제 소프트웨어 환경 내에서 가장 일관된 엔드투엔드 운영자이고, Gemini 3.8 Flash는 대규모 작업에서 비용과 지연 시간을 압축하며, Muse Spark 1.3은 합리적인 가격의 에이전트 오케스트레이션에 강점을 보이고, Grok 4.6은 중간 가격대에서 코딩과 에이전트 성능을 균형 있게 제공합니다.
모호한 상황에서 코딩 정밀도를 프론티어의 기준으로 삼는 개발자들에게는, Fable이 특히 다중 파일 편집, 극한 사례 추론, 장기 리팩터링이 혼합된 테스트에서 가장 자주 최상위 선택으로 꼽힙니다. Astra의 순수 pass@k 코딩 성능도 근접하지만, 모델이 컴퓨터를 신뢰성 있게 조작해야 할 때—도구 호출, UI 탐색, 최소한의 감독 개입으로 작업을 마무리할 때—Astra가 앞서갑니다. Grok 4.6은 실용적인 중간 경로로 성숙해, 코딩 경쟁력과 함께 합리적인 가격대에서 에이전트 행동과 경제성을 유지하는 팀에 적합합니다.
고용량 생산 라인—요약, 태깅, 검색 보강 Q&A, 데이터 정리, 합성 변형—을 운영한다면, Gemini 3.8 Flash가 작업당 비용과 엔드투엔드 응답 시간에서 품질 저하 없이 우위를 점하는 경향이 있습니다. 처리량과 첫 토큰 응답 시간 덕분에 더 엄격한 SLA와 저렴한 자동 확장이 가능합니다. 이 영역에서는 설계된 프롬프트, 구조화된 출력, 증류 기반 가드레일이 원가 우위를 신뢰할 수 있는 파이프라인으로 전환시킵니다. 다단계 사무 및 운영 자동화에는 Muse Spark 1.3이 안정적인 도구 사용과 동시성을 적절한 가격에 제공해 백오피스 큐 전반에 걸친 광범위한 배포를 지원합니다.
간과되기 쉽지만 중요한 점: 진정한 프론티어의 강점은 단일 턴 벤치마크 점수가 아니라 운영 신뢰성입니다. Astra의 매력은 반복 가능한 엔드투엔드 성공과 낮은 운영자 마찰입니다. Fable은 장기 추론에서 논리적 실수가 적다는 점이 강점입니다. Gemini Flash는 대규모에서 예측 가능한 지연 시간과 비용 곡선을 제공합니다. Muse는 일상 워크플로우에서 에이전트 가치 밀도가 높습니다. Grok은 예산 충격 없이 코딩 스프린트와 경량 에이전트를 균형 있게 지원하는 능력이 매력입니다. 올바른 답은 보통 한 모델이 아니며, 대부분 팀은 2~3개 모델을 표준화해 작업 부하, 신뢰도 임계값, 예산 범위에 따라 라우팅합니다.