

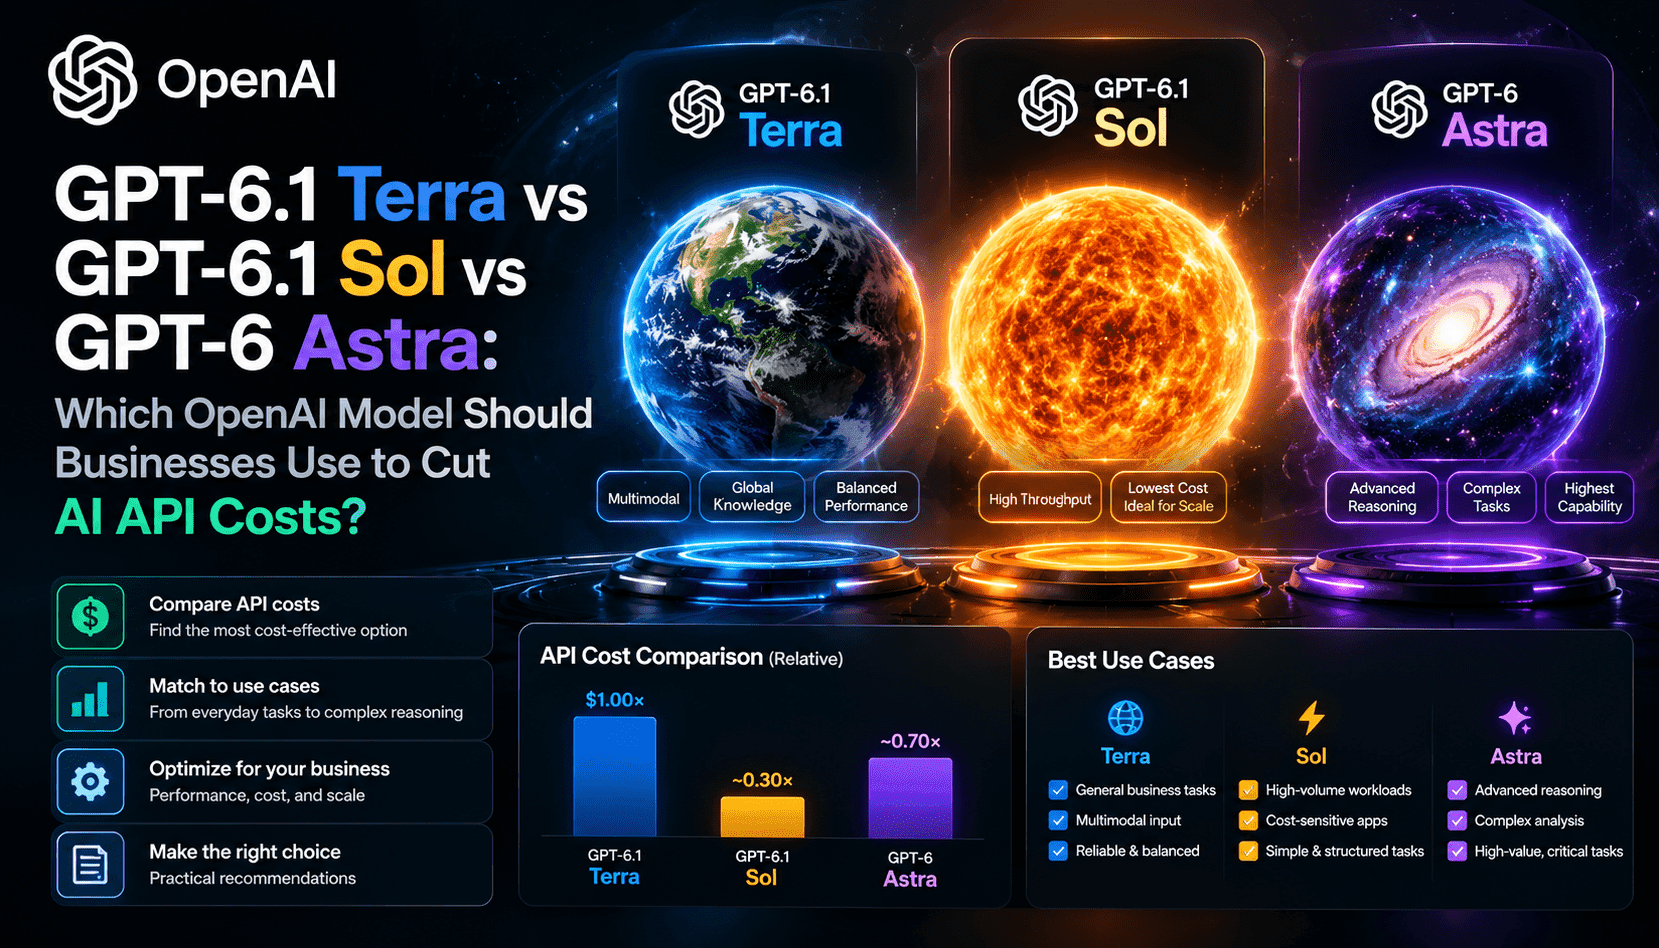
이제 기업의 AI 팀은 비용과 성능 특성이 서로 다른 고성능 OpenAI 모델을 다양하게 사용할 수 있습니다. GPT-6.1 Terra는 예측 가능하고 저렴한 추론이 중요한 대량·저지연 워크로드에 최적화되어 있습니다. GPT-6.1 Sol은 더 높은 연산 비용으로 한층 강력한 범용 추론과 코딩 성능을 제공하며, GPT-6 Astra는 시각적 추론과 멀티모달 에이전트에 초점을 둡니다. 이 글에서는 반복적인 작업은 Terra로 보내고, 뚜렷한 강점이 필요한 예외적인 작업에만 Sol이나 Astra를 사용하도록 돕는 구체적인 기준과 아키텍처를 소개합니다.
효과적인 모델 라우팅 전략은 큰 범주의 분류와 세밀한 실행을 결합해 API 지출을 줄입니다. 먼저 요청을 복잡도, 허용 지연 시간, 입력 유형에 따라 분류하세요. 대량의 정형 텍스트 생성, 간단한 번역, 메타데이터 추출, 규칙에 따른 서식 지정은 Terra에 적합합니다. 복잡한 추론, 여러 문서의 종합, 난도 높은 코드 생성, 창의적인 문장 재작성에는 Sol을 사용하세요. 이미지 이해, 레이아웃 분석, 브라우저를 조작하는 시각 에이전트가 필요한 작업은 Astra에 맡기세요. 이어지는 내용에서는 이러한 장단점을 수치로 살펴보고 예시 파이프라인을 제안합니다.
비용을 고려한 라우팅은 단순한 엔지니어링 요령이 아닙니다. 측정과 안전장치, 단계적인 도입이 필요합니다. 팀은 적응형 라우팅 미들웨어를 구축하고 모델별 지표(지연 시간, 성공한 추론당 비용, 오류율, 사람에게 이관되는 비율)를 수집해야 합니다. 또한 대체 및 샘플링 규칙을 마련해 모델을 바꾸더라도 사용자 경험이 저하되지 않도록 해야 합니다. 이 글에서는 구체적인 모니터링 KPI와 함께, 복잡한 요청이 다시 고비용 모델로 쏠리는 피드백 루프, Terra의 효과를 떨어뜨리는 데이터 드리프트, 규제 감사를 위한 텔레메트리 부족 같은 흔한 문제를 피하는 점검 목록도 제공합니다.
아래 세부 섹션에서는 가격 및 처리량 예시, 주요 기업 사용 사례별 라우팅 아키텍처, 구현 점검 목록, 운영 모니터링 모범 사례와 혼합 모델 배포를 시범 운영하려는 팀을 위한 간단한 FAQ를 다룹니다. 각 섹션은 실제 적용에 초점을 둡니다. 아키텍처 패턴과 텔레메트리 스키마, 의사결정 규칙을 조달 및 엔지니어링 계획에 바로 활용할 수 있습니다.