

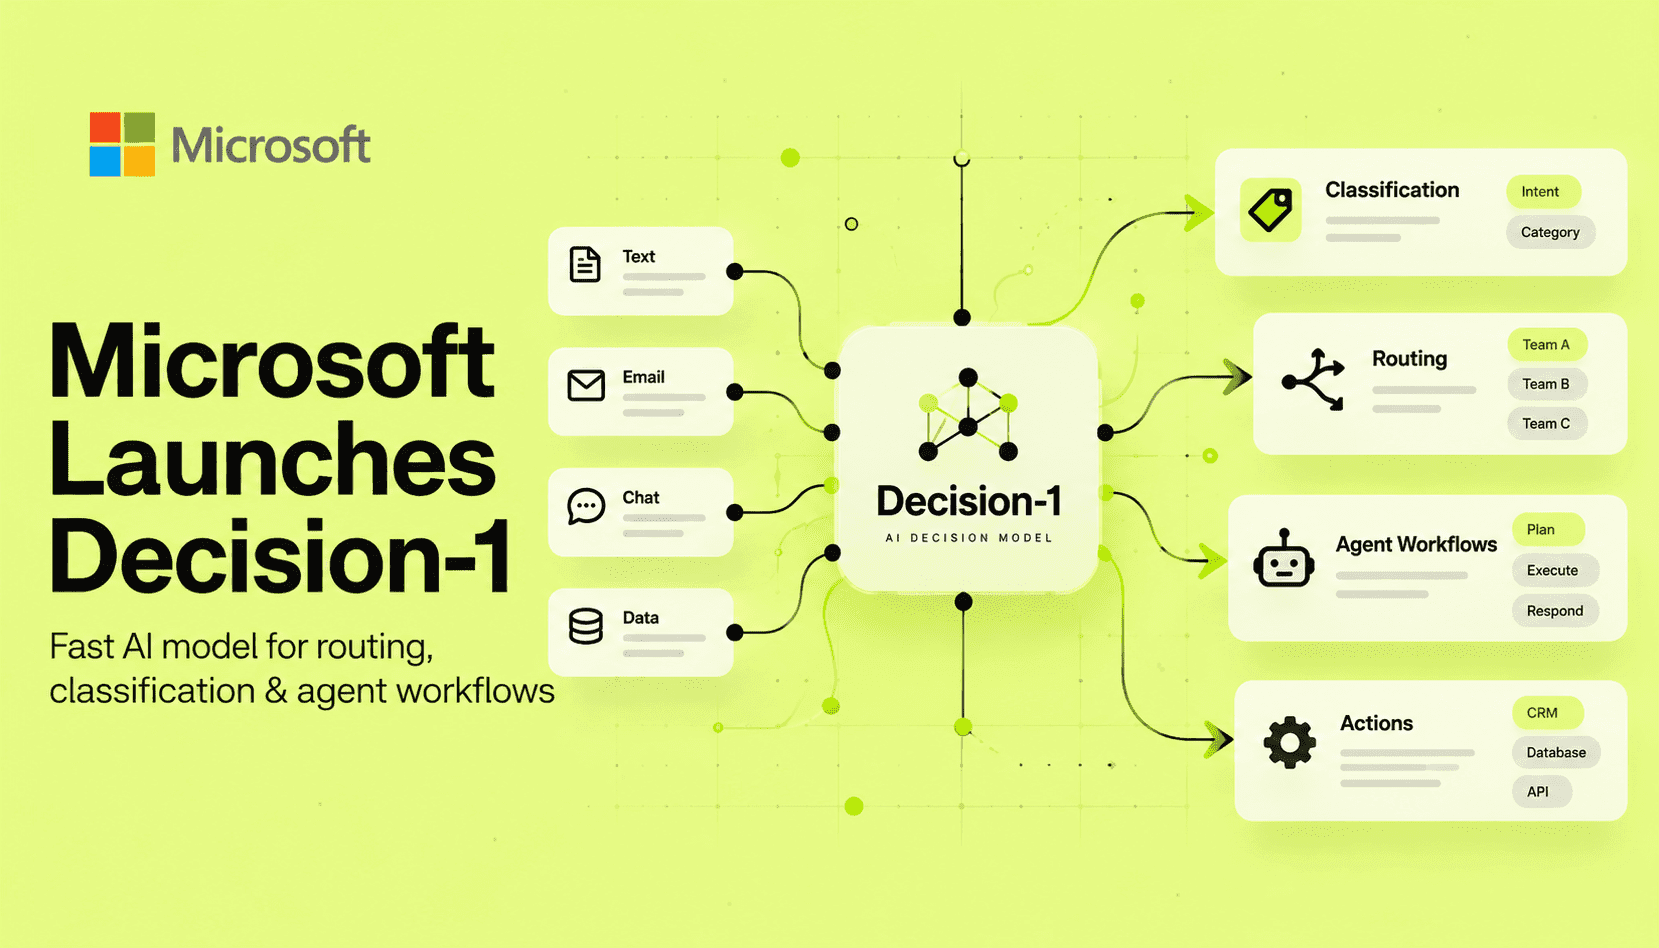
Microsoft-Decision-1은 생성보다 선택, 순위 지정, 분류, 검증, 점수 산정 등 의사결정이 필요한 소프트웨어를 위해 설계된 특화 점수 산정 모델입니다. 유창한 텍스트를 생성하도록 조정된 범용 LLM과 달리, 이 모델은 한 번의 순전파로 구조화된 출력과 보정된 확률을 제공합니다. 제품팀에는 이 차이가 중요합니다. 의사결정이 많은 작업을 비용과 지연 시간이 큰 LLM 호출 대신, 실시간 에이전트, 웹훅, 대규모 처리량의 콘텐츠 검토 파이프라인에 적합한 간결하고 결정론적인 점수 산정 단계로 바꿔 주기 때문입니다.
Microsoft는 이 모델이 Qwen3.5‑9B를 기반으로 하며 보정과 저지연 추론에 최적화됐다고 설명합니다. 모델은 라벨이 지정된 선택지별 확률을 출력하므로 소프트웨어가 확률 벡터를 라우팅이나 임계값 기반 의사결정에 바로 활용할 수 있습니다. 이를 통해 텍스트 생성형 LLM을 호출하고 응답을 기다릴 필요가 없어지며, 추가 파싱이나 휴리스틱 추출도 필요하지 않습니다. 한 번의 추론으로 보정된 점수를 얻으면 후속 텔레메트리도 단순해집니다. 비용이 큰 프롬프트 엔지니어링이나 다단계 검증 절차 없이 신뢰도를 측정하고, 임계값을 조정하고, 보호 장치를 적용할 수 있습니다.
Microsoft가 제시한 벤치마크 결과는 주목할 만합니다. Decision‑1은 정확도 기준 36개 벤치마크 비교에서 1위를 차지했으며, 특히 생성형 기준 모델보다 훨씬 빨랐습니다. 테스트에서 GPT-6 Sol 비교 모델보다 35배 빠른 것으로 보고됐습니다. 지연 시간, 추론당 비용, 처리량이 제품의 제약 조건인 환경에서는 이 정도의 개선이 중요합니다. 다만 벤치마크의 맥락, 하드웨어, 배치 처리, 데이터셋의 정합성도 중요하므로 아키텍처 변경을 결정하기 전에 프로덕션 환경에서 주요 마이크로벤치마크를 재현해야 합니다.
실무적으로 Decision‑1은 경량 분류기와 대형 LLM 사이에 자리합니다. 여러 의사결정 작업에 맞춰 학습되고 보정됐다는 점에서 소형 분류기보다 목적에 더 잘 맞고, 입력을 해석하고 결정을 내리기 위해 생성형 LLM 전체를 사용하는 것보다 훨씬 저렴하고 빠릅니다. 따라서 엔지니어링팀은 명확한 운영 원칙을 세울 수 있습니다. 목적이 선택, 라우팅, 점수 산정 또는 검증이라면 전체 텍스트 LLM 호출을 대체하고, 창작, 요약 또는 장문 종합이 필요할 때는 생성형 LLM을 사용하세요.
의사결정 모델을 프로덕션에 도입할 때는 보정, 분포 변화, 기존 에이전트 도구 체인과의 통합을 고려해야 합니다. 팀은 신뢰도 임계값을 모니터링하고, 보정 성능 저하나 데이터 드리프트가 나타날 때 생성형 LLM으로 전환하는 대체 경로를 마련해야 합니다. 또한 비즈니스별 클래스와 비용 목표에 맞도록 학습 및 평가 주기를 운영해야 합니다. 제대로 구현하면 Decision‑1은 의사결정이 많은 흐름의 지연 시간과 추론 비용을 줄이고 시스템의 결정론적 동작을 높일 수 있습니다.