

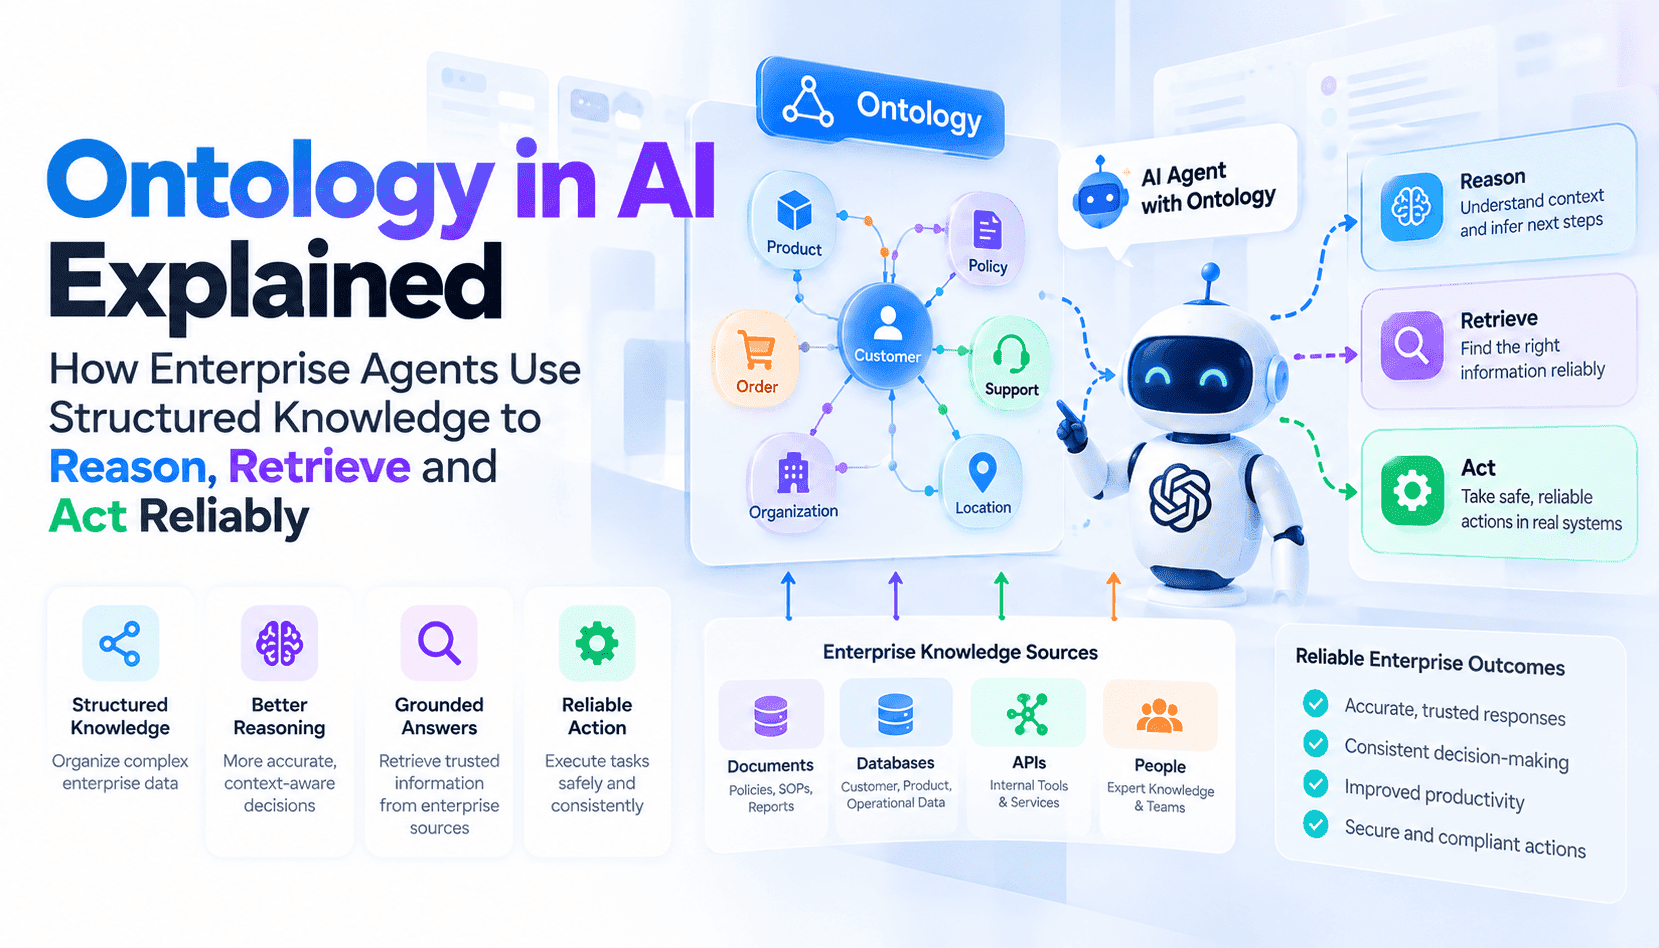
엔터프라이즈 AI는 커넥터, 데이터 웨어하우스, 검색 방식 등 데이터 연결과 처리의 상당 부분을 이미 해결했습니다. 이제 더 어려운 과제는 대규모 환경에서도 일관된 의미를 유지하는 것입니다. 에이전트가 모든 테이블을 조회할 수 있더라도 customer_status나 revenue 같은 필드의 의미를 잘못 해석할 수 있습니다. 온톨로지는 비즈니스 개념과 그 속성, 관계, 공리를 명시해 이 문제를 해결합니다. AI 시스템이 데이터를 이름 없는 토큰이나 스키마 요소로 취급하는 대신, 데이터가 무엇을 의미하는지 추론할 수 있게 합니다. 자동화된 대출 심사부터 경영진 보고서에 이르기까지 이후의 의사결정에서 이 변화는 중요합니다. 프로그램에 따라 같은 실수가 반복되면 그 영향이 누적되기 때문입니다.
이 글은 실제 활용 사례를 중심으로 접근합니다. 에이전트에 유용한 온톨로지의 구성 요소를 설명하고, 온톨로지가 분류 체계, 지식 그래프, 시맨틱 계층과 어떻게 다른지 살펴봅니다. 또한 고객 위험 프로필, 매출 지표, 보험금 청구 등 구체적인 사례를 통해 에이전트가 실행 시점에 필요로 하는 거버넌스, 데이터 계보, 접근 제어 신호를 알아봅니다. 목표는 실무에 적용할 수 있는 설계입니다. 추적 가능성과 권위 있는 정의, 정책 집행에 필요한 연결 지점을 갖춘 AI용 온톨로지를 설계해 에이전트가 올바른 데이터와 행동을 선택하고, 사람이 의사결정을 안심하고 감사할 수 있도록 합니다.
온톨로지는 추론을 가능하게 합니다. 카탈로그나 분류 체계가 자산을 분류하는 데 그치는 반면, 공리는 에이전트가 데이터에 명시적으로 저장되지 않은 사실을 추론하도록 돕습니다. 예를 들어 PII가 포함된 데이터 세트에는 제한된 접근 권한이 적용된다고 추론하거나, 세금 ID가 같은 두 항목을 동일한 법인으로 판단하거나, 구독이 만료되어도 고객의 의무는 사라지지 않는다고 볼 수 있습니다. 이러한 추론은 취약한 규칙 목록의 필요성을 줄이고 실행 시점의 의사결정을 더욱 견고하게 만듭니다. 단, 이를 위해서는 클래스, 인스턴스, 속성, 방향성이 있는 관계, 그리고 실제 데이터와 소유자 및 정책을 연결하는 형식적 제약 조건을 신중하게 모델링해야 합니다.
마지막으로, 처음 4~8주 동안 적용할 수 있는 경량 구현 프레임워크를 소개합니다. 하나의 의사결정이나 에이전트 워크플로부터 시작해 영향력이 큰 개념 20~50개를 모델링하고, 추론에 필요한 관계와 공리를 정의하세요. 그런 다음 개념을 데이터 계보, 품질 점수, 접근 규칙에 바로 연결합니다. 단순한 도입률이 아니라 추론 정확도, 추적 가능성, 접근 권한 인식 수준으로 성과를 측정하세요. 이렇게 하면 온톨로지가 문서 저장소에서 방치되는 대신 AI 활용의 확장에 맞춰 발전하는 살아 있는 거버넌스 자산이 됩니다.