

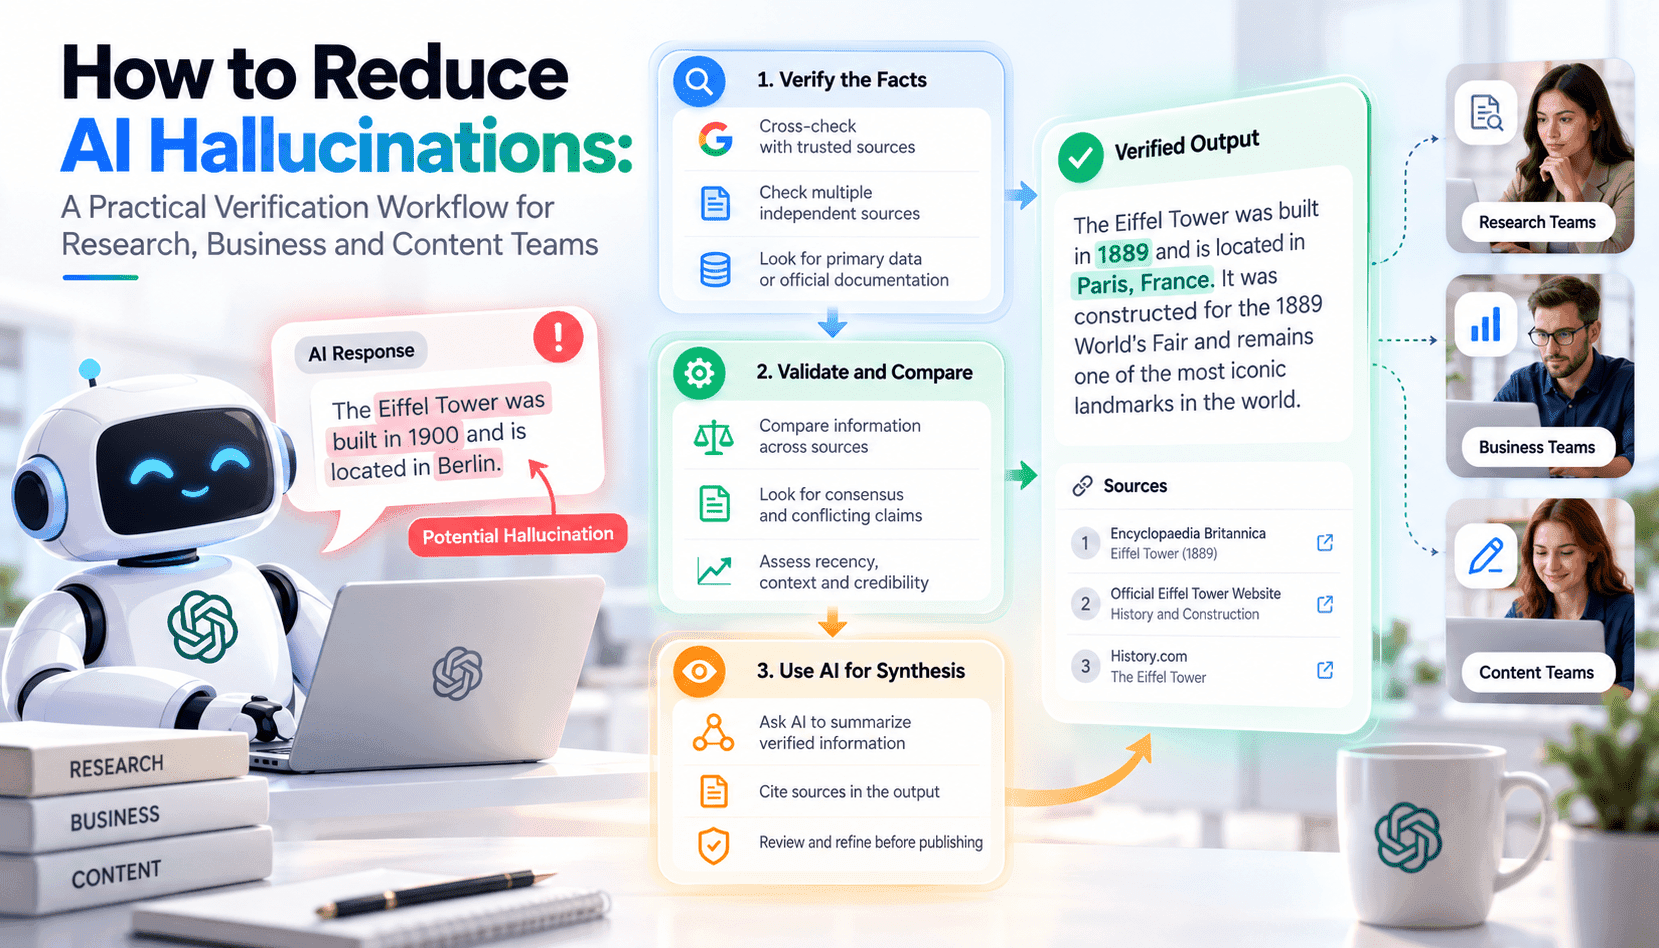
AI 시스템은 리서치 요약과 경영진 브리핑을 작성하고 고객 문의에 답변하는 등 생산성을 크게 높여 줍니다. 하지만 이러한 결과물을 의사결정, 예산 편성 또는 대외 콘텐츠에 활용하는 팀에는 검증되지 않은 모델의 응답이 평판·재정·규제 측면의 피해로 이어질 수 있습니다. 이 글은 환각이 존재하는지를 논하는 데서 벗어나, 기존 검토 절차에 적용할 수 있고 간단한 확인부터 필요시 전문가 검증까지 확장 가능한 실용적이고 반복 가능한 검증 워크플로를 통해 환각을 줄이는 방법을 소개합니다.
환각이 발생하는 데에는 구체적인 원인이 있습니다. 프롬프트에 맥락이 부족하거나, 검색 결과의 품질이 낮거나 오래되었거나, 사용자의 의도가 모호하거나, 학습 데이터가 최신이 아니거나, 모델이 자신감은 높지만 근거가 없는 주장을 만들어 내는 경우입니다. 이런 실패 원인을 이해하면 위험에 맞는 통제 방안을 선택할 수 있습니다. 검색 성능 강화, 출처에 근거한 프롬프트 작성, 구조화된 사실 추출, 신뢰도 임계값 설정, 여러 모델의 결과 비교 등이 그 예입니다. 이 워크플로의 목표는 AI 사용을 없애는 것이 아니라, 모델의 출력을 검증이 필요한 주장으로 보고 의사결정이나 게시 자료에 반영하기 전에 확인하는 것입니다.
이 가이드는 단계별 검증 절차를 안내합니다. 주장을 정의하고, 명시적인 근거를 요구하고, 1차 출처를 확인하고, 서로 독립적인 참고 자료와 비교하고, 사실과 추론을 구분하고, 불확실성을 표시하고, 최종 승인을 기록합니다. 각 단계에는 시장 조사, 경영진 보고서, SEO 콘텐츠, 고객 지원 응답, 사내 어시스턴트 등 팀에서 흔히 사용하는 업무 흐름에 적용할 수 있는 실용적인 확인 방법과 사례가 담겨 있습니다. 간단한 확인으로 충분한 경우와 전문가 검증이 필수인 경우를 판단할 수 있는 위험 매트릭스도 제공합니다.