

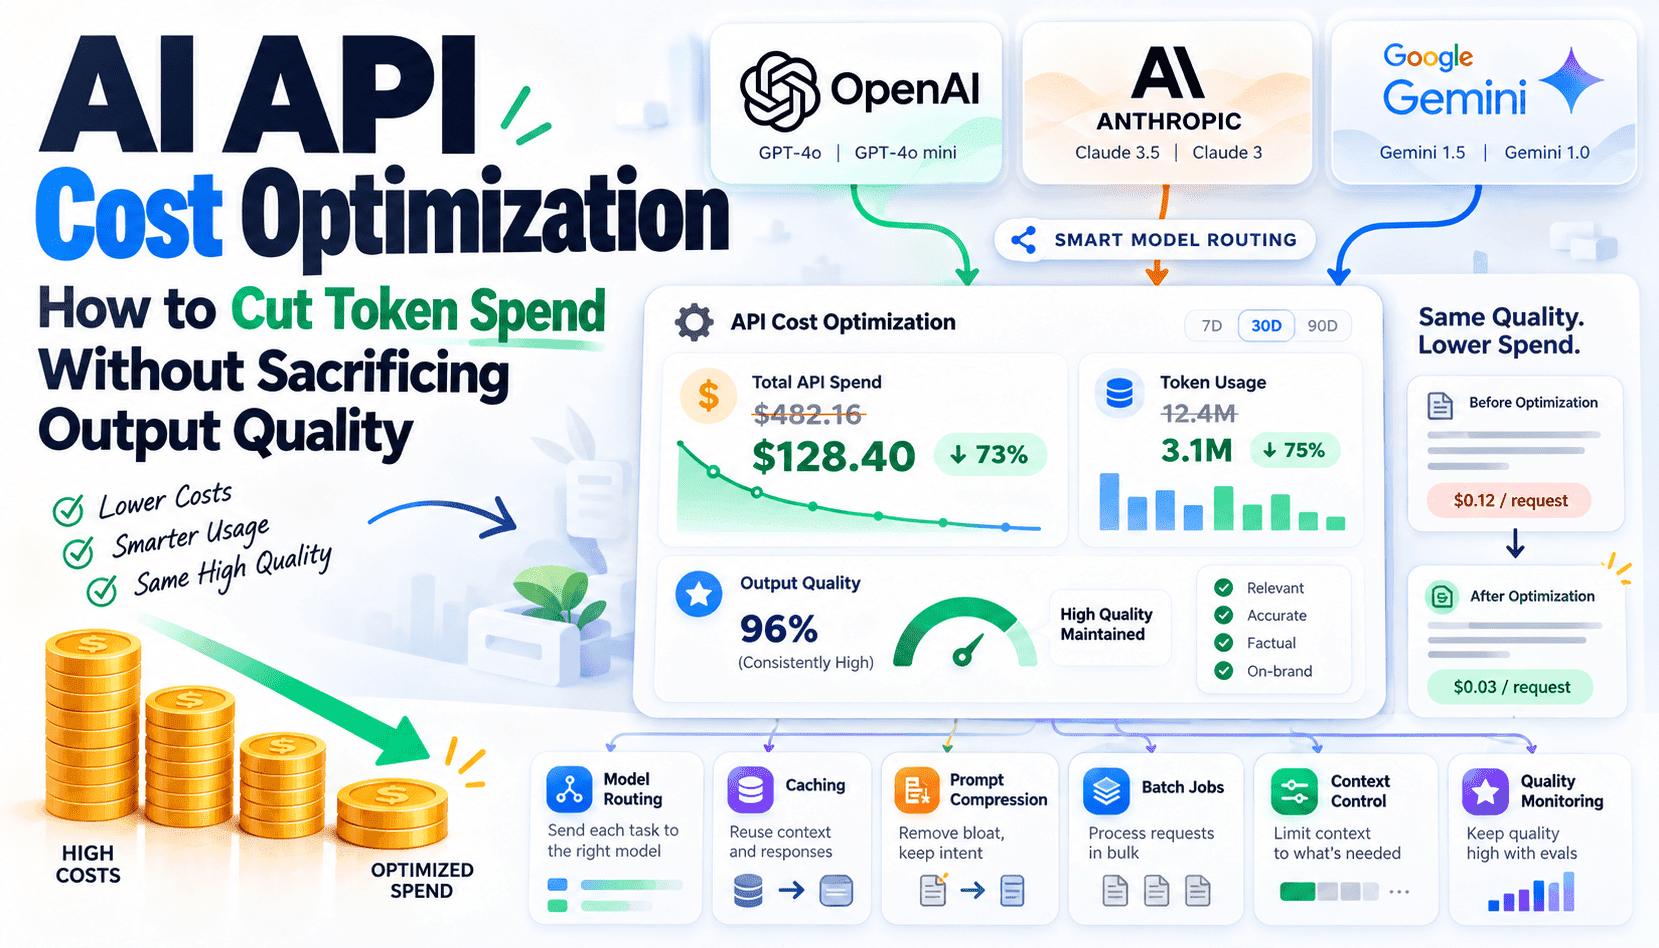
O crescimento da IA generativa transformou os custos com tokens em uma despesa significativa. Sem controle, esses gastos aumentam conforme crescem o volume de usuários, o tamanho dos contextos e as respostas sem limites. Otimizar custos não significa escolher sempre o modelo mais barato: significa adequar a capacidade do modelo à complexidade da tarefa, eliminar tokens desnecessários tanto das entradas quanto das saídas e ajustar os fluxos de trabalho para que a inferência mais cara só seja usada quando trouxer ganhos relevantes para o negócio. Neste artigo, apresentamos as medidas operacionais que as equipes podem adotar e as métricas necessárias para avaliar as compensações.
Comece criando um mapa de roteamento e capacidades: classifique as solicitações por complexidade e pelo quanto a qualidade é importante e, em seguida, direcione tarefas simples a modelos menores e mais baratos ou a módulos determinísticos. Por exemplo, revisões curtas de texto, traduções com formato rígido e extração simples de intenção muitas vezes podem ser feitas por modelos destilados ou heurísticas; já a geração criativa de textos longos e o raciocínio complexo em várias etapas devem ser encaminhados a modelos mais robustos. Monitore a taxa de sucesso e os casos encaminhados para cada rota para identificar quando as opções mais baratas falham e fazer o escalonamento apenas quando necessário.
Para controlar custos com engenharia de prompts, há três medidas práticas: compactar as instruções sem alterar o significado, aproveitar ao máximo o contexto de sistema compartilhado e reduzir o contexto dinâmico. Use modelos concisos, exemplos few-shot numerados e esquemas de funções estruturados para evitar excesso de texto. Mantenha o contexto de sistema estável no servidor e acrescente apenas os elementos dinâmicos necessários. Em conversas longas, faça um resumo em vez de reenviar todas as mensagens; em tarefas com muitos documentos, recupere e classifique os trechos mais relevantes em vez de inserir documentos inteiros no prompt.
Além dos prompts, incorpore ao seu stack controles de cache, processamento em lote e pipelines. Um cache híbrido, que combina correspondência semântica e exata, evita repetir inferências caras. Processe tarefas de baixa prioridade em lote, fora dos horários de pico ou em ambientes computacionais mais baratos. Sempre que possível, defina limites de saída, tokens de parada e chamadas determinísticas de funções para impedir que os modelos gerem texto sem limite. Por fim, adote uma estrutura unificada de controle de custos que acompanhe, em conjunto, tokens de entrada e saída, taxa de acerto do cache, latência e métricas de qualidade — assim, as decisões equilibram preço e sucesso do produto.