

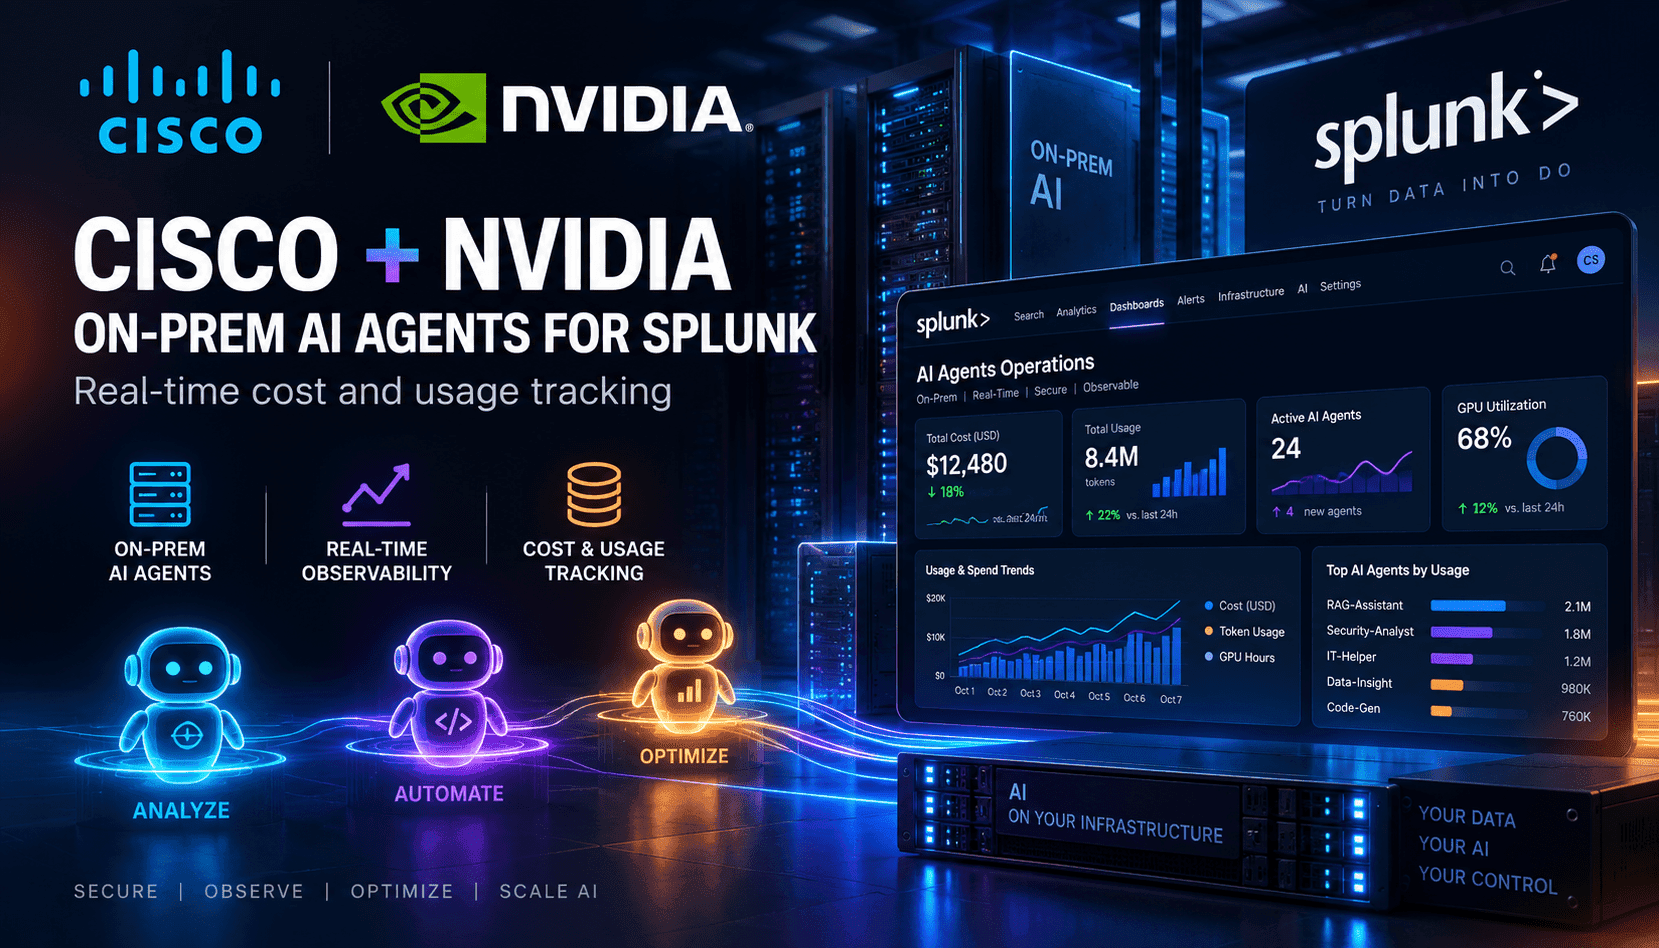
Empresas que centralizam telemetria no Splunk há muito enfrentam um dilema: manter os dados on‑premises para soberania e segurança, ou movê-los para a nuvem para acessar agentes modernos de IA. O novo AI POD da Cisco para Splunk, construído com computação acelerada pela NVIDIA e runtime Kubernetes, elimina essa lacuna. Ele permite que as equipes executem o AI Assistant do Splunk e um emergente Agent Launchpad ao lado de seus logs e métricas, enquanto hospedam internamente uma combinação de modelos abertos e proprietários. A pilha pré-validada reduz riscos de integração e tempo para valor, oferecendo às equipes de operações e segurança uma base de agentes que podem reforçar com os mesmos controles usados para seu ambiente de observabilidade.
A mudança operacional mais notável é a visibilidade de custos e comportamento. A capacidade Tokenomics do Splunk Agent Observability monitora o gasto de tokens por agente, usuário e fluxo de trabalho — incluindo agentes de codificação como Claude Code, Codex ou Cursor — para que líderes possam relacionar adoção ao valor, não a anedotas. Ela prevê consumo com modelagem de séries temporais, alerta sobre loops descontrolados e atribui custos às unidades de negócio. Como a mesma plataforma inspeciona prompts, respostas e chamadas de ferramentas, as equipes podem aplicar guardrails em tempo de execução para bloquear ações inseguras e conter alucinações. Na prática, isso significa que você pode definir orçamentos, evitar uso excessivo em tempo real e comprovar ROI com economia unitária, evitando surpresas no fim do mês.
Estratégicamente, essa arquitetura acelera a transição de pilotos para uma malha de agentes governada. Ao levar a execução do modelo até os dados, as empresas evitam caminhos frágeis de ETL e reduzem exposição de egressos. A escolha do modelo permanece flexível: equipes podem executar opções de peso aberto como a família Nemotron da NVIDIA ao lado de modelos específicos de domínio, como o Deep Time Series Model da Cisco para previsões. O trade-off é a maturidade operacional — Kubernetes, agendamento de GPU, avaliação de modelos e gerenciamento de riscos de prompt devem ser tratados como disciplinas de primeira classe. Para compradores, a questão muda de “Podemos usar IA aqui?” para “Quais agentes justificam o investimento, em qual hardware e sob quais guardrails?” Organizações que responderem isso com precisão escalarão mais rápido com menos retrabalho.