

NexusAi logo

NexusAi

  • Produtos
  • Categoria
  • Prompts
  • Pesquisar
  • Insights
  • Preços
  • Promover
  • Contato
Entrar
NexusAi LogoNexusAi

A NexusAI ajuda você a descobrir, comparar e aprender sobre ferramentas de IA com facilidade. De insights de especialistas a recursos de treinamento, capacitamos indivíduos e empresas a aproveitar a tecnologia de IA para decisões mais inteligentes, inovação e crescimento.

Links Úteis

  • Sobre Nós
  • Produtos de IA
  • Categorias de IA
  • Prompts de IA
  • Busca de IA
  • Insights de IA

Serviços e Termos Legais

  • Exibição e Promoção
  • Planos de Assinatura
  • Termos e Condições
  • Política de Reembolso
  • Política de Privacidade
  • Aviso Legal

Fale Conosco

88 Tribune Street
South Brisbane, QLD, Austrália, 4101
Site: www.nexusai-tech.com
E-mail: info@nexusai-tech.com

© Copyright 2026 NexusAi Todos os direitos reservados

Desenvolvido por DStudio Technology
Início/Insights de IA/Notícias de Produtos de IA/O Sistema Fusion da Cognition Transforma a Curva de Custos: Agentes de Codificação Até 39% Mais Baratos com Orquestração Líder-Ajudante
Notícias de Produtos de IAInfraestrutura de Agentes

O Sistema Fusion da Cognition Transforma a Curva de Custos: Agentes de Codificação Até 39% Mais Baratos com Orquestração Líder-Ajudante

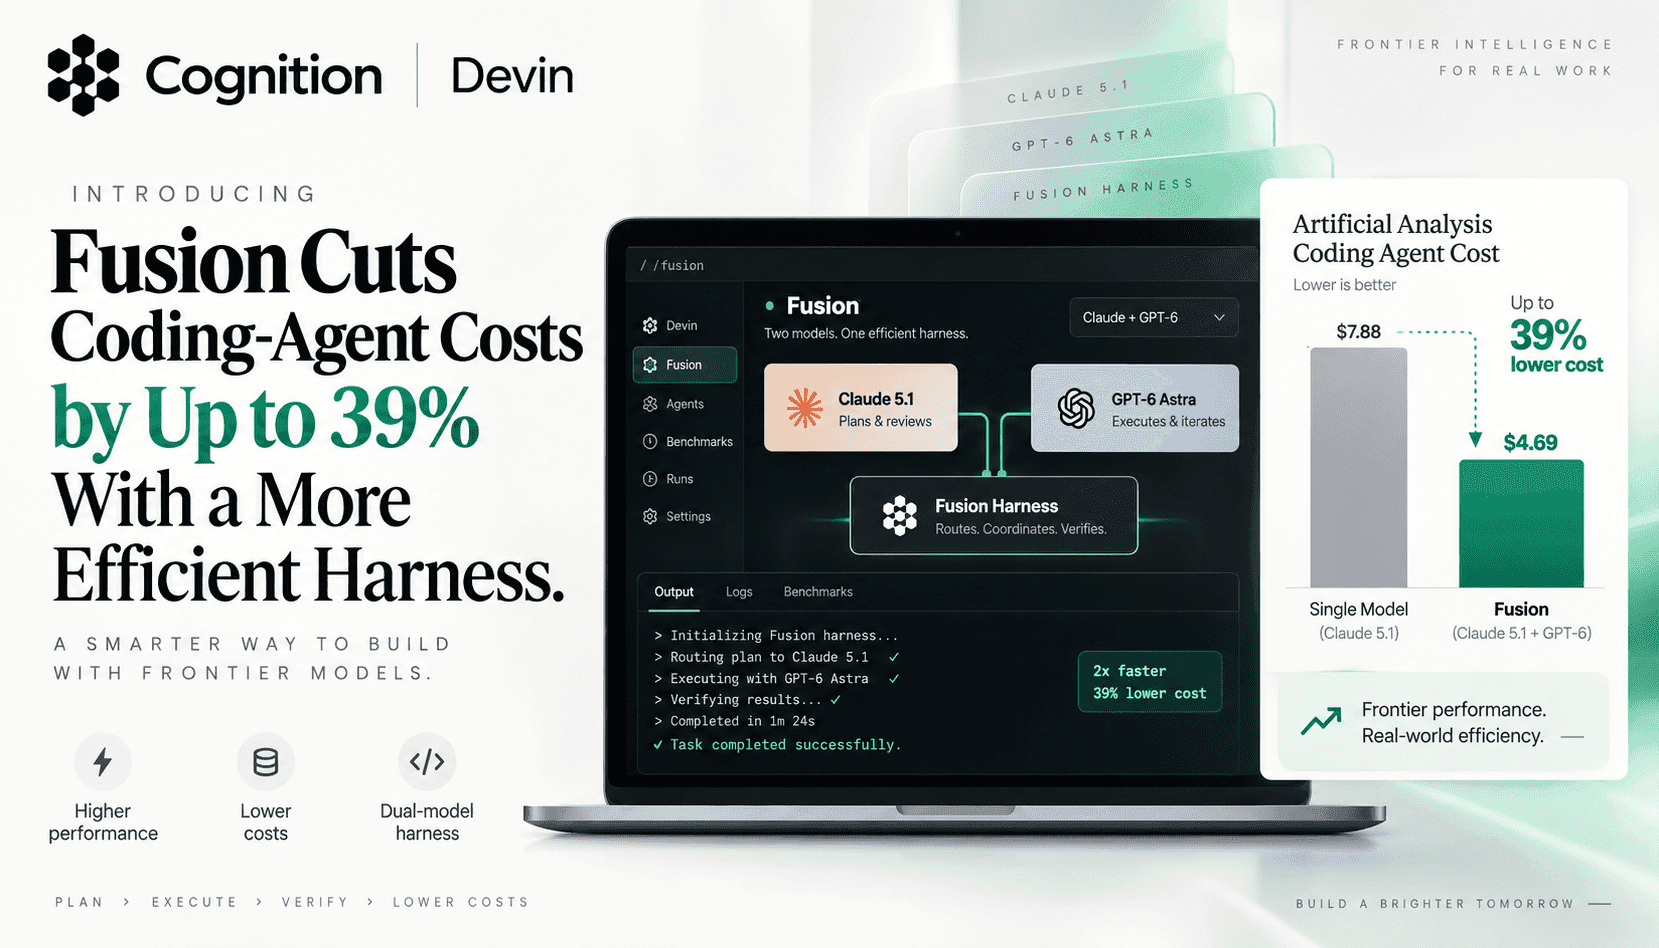
O novo sistema Fusion da Cognition combina um modelo “líder” de ponta com um “ajudante” econômico, reivindicando até 39% de redução nos custos dos agentes de codificação, mantendo a qualidade de referência. A mudança destaca a orquestração: contexto persistente, delegação baseada em briefings e cache de prompts — não troca de modelos — como a próxima alavanca para o retorno sobre investimento dos agentes.

NexusAI Research Desk14/09/20262.7K visualizações8 min de leitura
O Sistema Fusion da Cognition Transforma a Curva de Custos: Agentes de Codificação Até 39% Mais Baratos com Orquestração Líder-Ajudante
Resumo de IA

O Fusion da Cognition redefine a otimização para agentes de codificação: em vez de trocar modelos no meio da tarefa, ele executa um “líder” de ponta para planejar/revisar e um “ajudante” mais barato para executar, cada um com contexto persistente. Ao trocar briefings concisos e resultados — apoiado em cache de prompts — o Fusion reporta até 36–39% de redução de custo sem abrir mão do desempenho de referência. A ideia maior é preço por tarefa, não por token: líderes e ajudantes mais fortes (mesmo que mais caros) podem reduzir o total de interações, diminuir retrabalho e comprimir ciclos de revisão. Para equipes testando Astra, Claude ou similares, o campo de batalha agora é o sistema: política de delegação, cadência de revisão e estratégia de cache. A lição prática: avalie a orquestração multiagente junto com a escolha do modelo para desbloquear ganhos duradouros de custo/desempenho.

Fusion é um sistema com dois agentes projetado para trabalhos de codificação: um modelo líder de ponta planeja e revisa; um ajudante mais barato executa. Em vez de encaminhar conversas inteiras entre modelos, a dupla troca briefings estruturados e resultados enquanto cada um constrói seu próprio contexto persistente. Essa separação é importante. Trocar modelos no meio do fluxo frequentemente destrói caches e gera retrabalho. No Fusion, a delegação baseada em briefings mantém o contexto estável, permite que o ajudante avance rapidamente na implementação e reserva o raciocínio caro para os pontos de verificação do líder. O resultado, segundo benchmarks reportados, é qualidade de nível de ponta a um custo significativamente menor — especialmente em tarefas onde a execução constante domina o orçamento de tokens.

A mudança estratégica é da seleção de modelos para a qualidade da orquestração. O preço por token subestima a realidade de que planejadores melhores escrevem briefings mais precisos, precisam de menos tentativas e minimizam o vai-e-volta entre líder e ajudante. Na prática, um líder mais forte (às vezes mais caro) pode tornar o sistema mais barato delegando mais cedo e revisando menos. Da mesma forma, um ajudante mais capaz pode custar mais por token, mas reduzir o total de interações ao acertar a implementação na primeira vez. É por isso que as reivindicações do Fusion ressoam: eles operacionalizam uma mentalidade de preço por tarefa, harmonizando planejamento, execução e revisão em um fluxo de trabalho que protege caches e reduz retrabalho.

Para compradores, isso redefine as listas de verificação de avaliação. Benchmarks ainda importam, mas as perguntas relevantes agora são sobre a política do sistema: como os planos são formados, o que é delegado, com que frequência o líder revisa e como os erros escalam. Equipes que testam líderes do tipo Astra ou Claude devem medir custo, tempo e qualidade no nível da tarefa e instrumentar onde tokens e interações realmente ocorrem nas fases — planejamento, configuração, implementação, depuração, validação, encerramento. Se a maior parte do custo recai sobre implementação e depuração, um sistema com dois agentes, contexto persistente e cache de prompts provavelmente superará roteamento ingênuo ou loops de modelo único.

A adoção não é trivial. Os briefings de delegação devem ser ajustados para o par escolhido; a autonomia do ajudante deve escalar com sua capacidade; e a exploração que molda o plano geralmente deve ficar com o líder, a menos que o ajudante seja forte o suficiente para evitar interpretações erradas. Organizações também precisarão de governança: pontos de revisão rastreáveis, execuções reproduzíveis entre caches e limites para que o ajudante não ultrapasse ferramentas ou permissões. Mas o benefício é atraente: um canal de planejamento estável que concentra inteligência de ponta onde vale a pena, e um canal de execução que realiza mudanças no código rapidamente sem acordar repetidamente um cérebro caro.

Principais conclusões

O Sistema é o Novo Campo de Batalha da Otimização

Delegação líder-ajudante, contexto persistente e briefings conscientes de cache podem desbloquear economias maiores do que trocar modelos ou roteamento ingênuo — especialmente em tarefas com foco em implementação.

Avalie Preço por Tarefa, Não por Token

Modelos mais fortes (mesmo que mais caros) podem reduzir interações totais e retrabalho, cortando custo de ponta a ponta. Instrumente fases e taxas de aceitação para ver o ROI real.

Ajuste Políticas para o Par de Modelos

Dimensione corretamente o detalhe dos briefings, a cadência de revisão e a resistência do ajudante. Delegação excessiva ou ajudantes fracos corroem economias e podem degradar a qualidade.

O Que Mudou: Orquestração em Vez de Roteamento

O Fusion executa dois agentes persistentes em paralelo: um líder de ponta que controla o ciclo de planejamento e revisão, e um ajudante econômico que cuida da exploração, implementação e testes de código. Em vez de passar históricos completos de conversas entre modelos, eles trocam briefings compactos, resultados e feedbacks. Isso preserva caches de prompts, reduz o excesso de tokens entre modelos e diminui cascatas de erros causadas por troca de contexto. O sistema concentra raciocínio de alta precisão onde é valioso e mantém a execução barata e rápida. Comparado ao roteamento ingênuo, essa arquitetura evita trocas caras de modelos no meio da tarefa que invalidam caches e amplificam retrabalho.

Por Que Importa: Preço por Tarefa Vence Preço por Token

As economias reportadas de cerca de 36–39% em benchmarks de codificação têm menos a ver com tokens mais baratos e mais com menos interações e transições mais limpas. Um líder mais forte frequentemente delega mais cedo com critérios de aceitação claros, prevenindo retrabalho. Um ajudante mais forte implementa corretamente com menos tentativas, reduzindo ciclos de revisão. Juntos, eles elevam a eficiência do sistema além do que o preço por token prevê. Para compradores, isso redefine a avaliação: pergunte como o sistema molda a profundidade do plano, a cadência da delegação e os limites de revisão — depois meça custo total, latência e taxas de aprovação por tarefa, não por mensagem ou token.

Como Testar: Um Plano Prático de Avaliação

Comece com um par líder-ajudante (por exemplo, um planejador de ponta com um executor capaz, porém mais barato) e um perfil fixo do sistema. Instrumente fases — planejamento, configuração, implementação, depuração, validação — registrando tokens, interações, tempo real e resultados de aceitação. Use um conjunto misto de tarefas: correções de bugs, refatorações, migrações e pequenas funcionalidades. Otimize os briefings antes de trocar modelos. Depois ajuste a cadência de revisão e a autonomia do ajudante: permita contrapontos apenas quando o ajudante for forte o suficiente para agregar valor. Por fim, teste políticas de cache de prompts e escopos de ferramentas em A/B. O sucesso se traduz em qualidade estável com quedas mensuráveis no total de interações, tokens do líder e tempo real.

Riscos e Limites: Quando o Sistema de Dois Agentes Pode Falhar

Se o ajudante for muito fraco, a delegação vira microgerenciamento e retrabalho, anulando as economias. Delegar demais a exploração inicial também pode distorcer o plano, forçando correções caras depois. Políticas de cache devem ser reproduzíveis e auditáveis; caso contrário, custo e qualidade podem variar entre execuções. Limites de ferramentas precisam de disciplina para evitar que o ajudante faça mudanças arriscadas. Por fim, benchmarks podem ocultar falhas raras — monitore regressões reais no repositório, testes instáveis e taxas de reversão para detectar quedas de qualidade que métricas de tokens não capturam.

Perspectiva do Comprador: Contratos, Métricas e Roteiros

Negocie metas de preço por tarefa e telemetria do sistema, não apenas taxas por token. Exija métricas por fase, taxas de acerto de cache e proporções de revisão para implementação. Pergunte aos fornecedores como ajustam briefings entre pares de modelos e como lidam com escalonamentos quando o ajudante está sobrecarregado. Planeje atualizações de modelo: líderes ou ajudantes mais fortes podem reduzir custo total se cortarem interações — reserve orçamento para experimentos. Internamente, padronize permissões de agentes, portões de revisão de artefatos e caminhos de reversão para que políticas de orquestração sobrevivam a trocas de modelo. A estrela guia é throughput estável e auditável — não apenas tokens baratos.

Perguntas frequentes

Como saber se um sistema de dois agentes reduzirá custos no meu código?

Realize um piloto de 2 a 3 semanas com um conjunto representativo de tarefas e instrumente tokens, interações e tempo real por fase. Se implementação e depuração dominam o gasto, a delegação dual com contexto persistente geralmente vence. Acompanhe taxas de regressão e acertos de cache para verificar qualidade e estabilidade.

Quando a exploração deve ficar com o modelo líder?

Mantenha os passos exploratórios que moldam o plano — desambiguação de requisitos, varreduras de arquitetura, triagem de riscos — com o líder, a menos que o ajudante seja forte o suficiente para captar sinais relevantes. Exploração mal posicionada distorce planos e causa correções caras na revisão posterior.

Que governança é necessária para implantação empresarial?

Exija execuções reproduzíveis com versionamento de cache, telemetria por fase, briefings explícitos de delegação e pontos de revisão. Imponha limites de ferramentas, logs de auditoria e reversões. Padronize portões de aceitação para que ajustes no sistema e atualizações de modelo não quebrem conformidade ou confiabilidade.

#Armadura do Agente#Desempenho do Agente Harness#Agentes Paralelos#Arquitetura de Planejamento e Execução#Otimização de Custos Agente#Custo por Tarefa#Análise de Benchmark para Custo#Economia dos Modelos de Ponta#Roteamento de Modelo#Roteamento Multi-Modelo#Cache de Prompt#Agentes de IA Persistentes#agentes de codificação#Família de Modelos Astra#Claude Fable 5.1#CLI do Agente#Orquestração Multiagente#Preço Por Tarefa#Arquitetura Líder e Assistente#Referências de Agentes de Codificação#Contexto Persistente#Resumos de Delegação

Newsletter de Insights de IA

Receba as últimas atualizações de IA, novidades sobre ferramentas e insights direto na sua caixa de entrada.

Sem spam. Cancele a inscrição a qualquer momento.
Nesta página
1.O Que Mudou: Orquestração em Vez de Roteamento2.Por Que Importa: Preço por Tarefa Vence Preço por Token3.Como Testar: Um Plano Prático de Avaliação4.Riscos e Limites: Quando o Sistema de Dois Agentes Pode Falhar5.Perspectiva do Comprador: Contratos, Métricas e Roteiros
Compartilhar este artigo

Artigos relacionados

O Impulso de 2GW da NVIDIA na Austrália Transforma Fábricas de IA em uma Classe de Ativo Soberano
Notícias Gerais da Indústria de IA

O Impulso de 2GW da NVIDIA na Austrália Transforma Fábricas de IA em uma Classe de Ativo Soberano

11/09/2026

NeoMME 260M Prioriza a Recuperação: Um Codificador Multimodal de Transformador Único que Dobra a Taxa de Processamento de Páginas
Notícias de Produtos de IA

NeoMME 260M Prioriza a Recuperação: Um Codificador Multimodal de Transformador Único que Dobra a Taxa de Processamento de Páginas

4/09/2026

Claude Fable 5.1 Supera Opus 5 em Benchmarks de Agentes e Reduz o Custo por Tarefa
Atualizações de Modelos e Plataformas de IA

Claude Fable 5.1 Supera Opus 5 em Benchmarks de Agentes e Reduz o Custo por Tarefa

3/09/2026

GPUs Não São Suficientes: NVIDIA Spectrum‑X Move o Gargalo da IA para a Rede
Notícias de Produtos de IA

GPUs Não São Suficientes: NVIDIA Spectrum‑X Move o Gargalo da IA para a Rede

3/09/2026

De MCP para MHS: O Padrão de Hardware da Anthropic Transforma Agentes em Operadores do Mundo Real
Notícias de Produtos de IA

De MCP para MHS: O Padrão de Hardware da Anthropic Transforma Agentes em Operadores do Mundo Real

29/08/2026

Ferramentas de IA relacionadas

Ver tudo
Devin da Cognition: Engenheiro de Software Autônomo para Planejamento, Codificação e Entrega

Devin da Cognition: Engenheiro de Software Autônomo para Planejamento, Codificação e Entrega

Assistentes e Agentes de IA

Devin: Engenheiro de Software Autônomo com IA para Tarefas de Codificação de Ponta a Ponta

Devin: Engenheiro de Software Autônomo com IA para Tarefas de Codificação de Ponta a Ponta

IA para Desenvolvedor e Codificação