

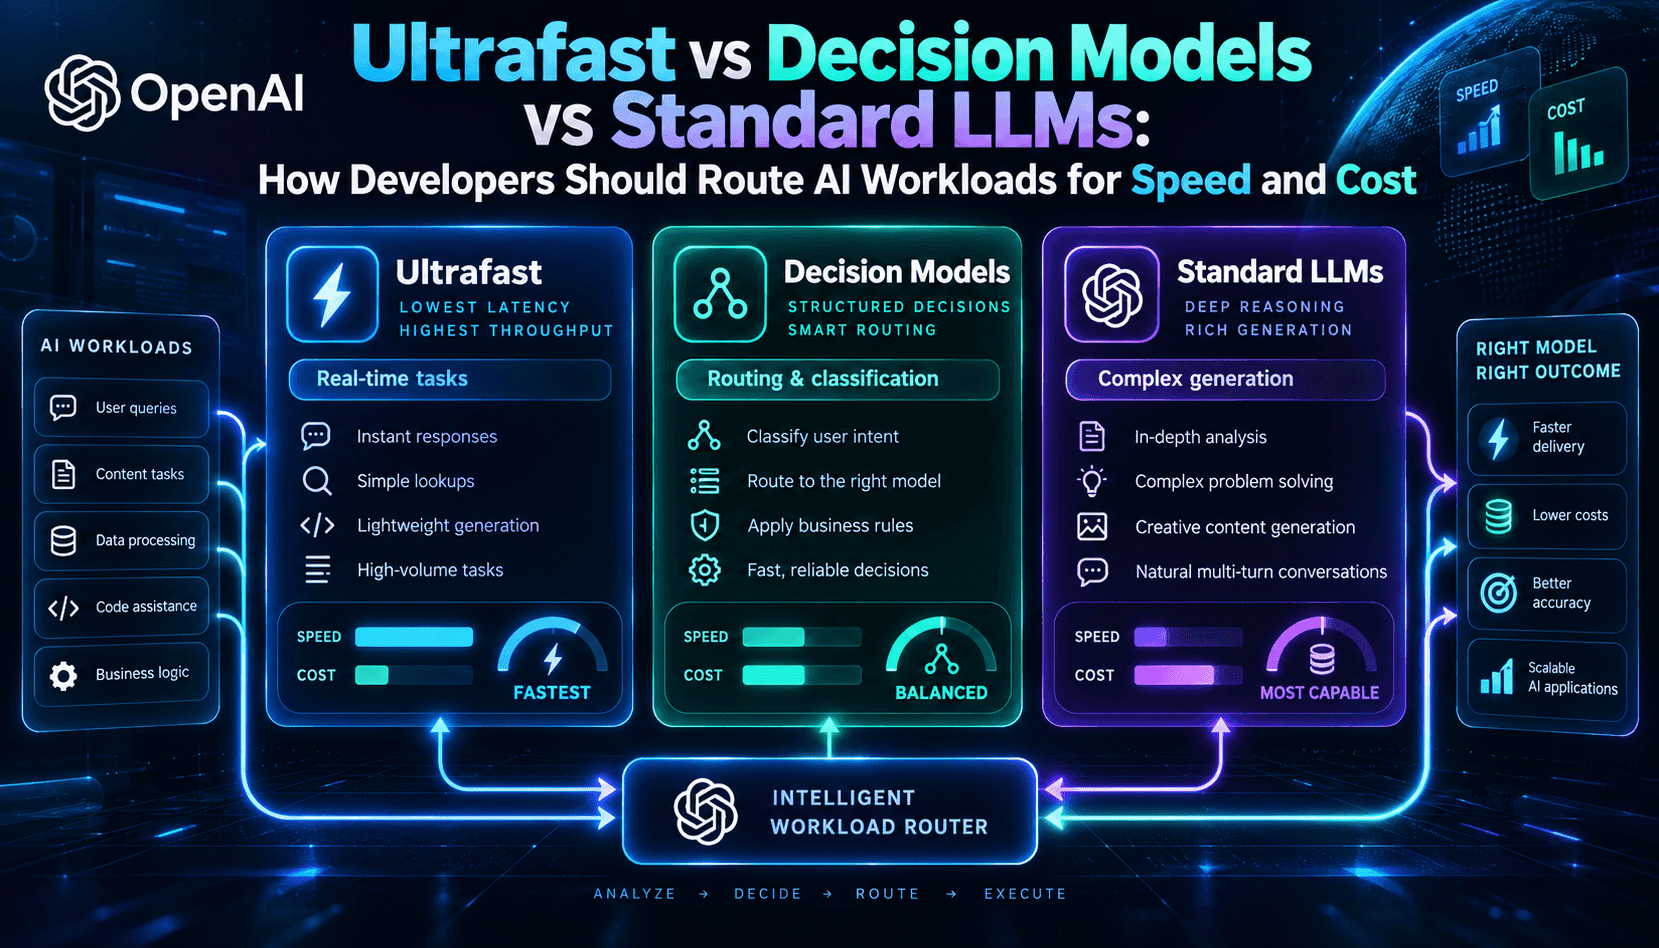
Desenvolvedores se deparam com uma escolha de arquitetura frequente: enviar tudo ao modelo mais capaz ou direcionar cada tarefa a endpoints especializados, mais rápidos e baratos. Os lançamentos recentes da OpenAI — GPT-6.1 Sol Ultrafast e GPT-6 Luna Decisions — tornam essa decisão mais prática. O Sol Ultrafast reduz a latência de saída de tokens em fluxos generativos; o Luna Decisions oferece respostas e decisões tipadas, com uma taxa de processamento cerca de dez vezes maior que a dos endpoints completos da API Responses. Este artigo transforma esses avanços da plataforma em estratégias práticas de roteamento que você pode adotar hoje.
Antes de rotear qualquer tarefa, classifique as cargas de trabalho em quatro dimensões: profundidade de raciocínio necessária (classificação simples ou cadeia de pensamento complexa), latência aceitável (interface com resposta em menos de 100 ms ou processamento em lote de vários segundos), estrutura da saída (decisão tipada ou texto livre) e sensibilidade a custos. Por exemplo, tarefas curtas e determinísticas de classificação e roteamento geralmente precisam apenas da API Decisions. A geração conversacional, que exige criatividade, se beneficia das variantes Sol ou Astra com raciocínio completo; já o streaming de tokens em interfaces de alto volume é ideal para o nível Ultrafast. Mapear as cargas de trabalho nessas dimensões evita o uso excessivo de modelos de ponta caros.
Na prática, implemente três vias de roteamento complementares: uma via Decisions (Luna) para decisões estruturadas de alto volume e tarefas de classificação; uma via generativa Ultrafast (GPT-6.1 Sol com service_tier:"ultrafast") para streaming de tokens com baixa latência e interfaces interativas; e uma via de raciocínio (GPT-6 Sol/Astra) para raciocínio complexo, síntese de código ou uso de ferramentas em várias etapas. Adicione um roteador leve que selecione a via com base em metadados, como tamanho do prompt, esforço de raciocínio esperado, limite de latência e necessidade de uma saída estruturada e tipada.
Exemplos concretos: use Decisions para detectar spam, rotear intenções, tomar decisões sobre flags de funcionalidades, fazer classificações simples e gerar saídas tipadas; use Ultrafast para conversas em streaming, preenchimento automático, sugestões em tempo real e experiências de interface em que os usuários aceitam um pouco menos de deliberação em troca de respostas instantâneas; reserve os modelos com raciocínio completo para geração de código, análises em várias etapas ou situações em que o uso de ferramentas e o raciocínio aprofundado alterem materialmente os resultados. Essas estratégias reduzem os custos gerais sem comprometer a precisão onde ela é mais importante.