

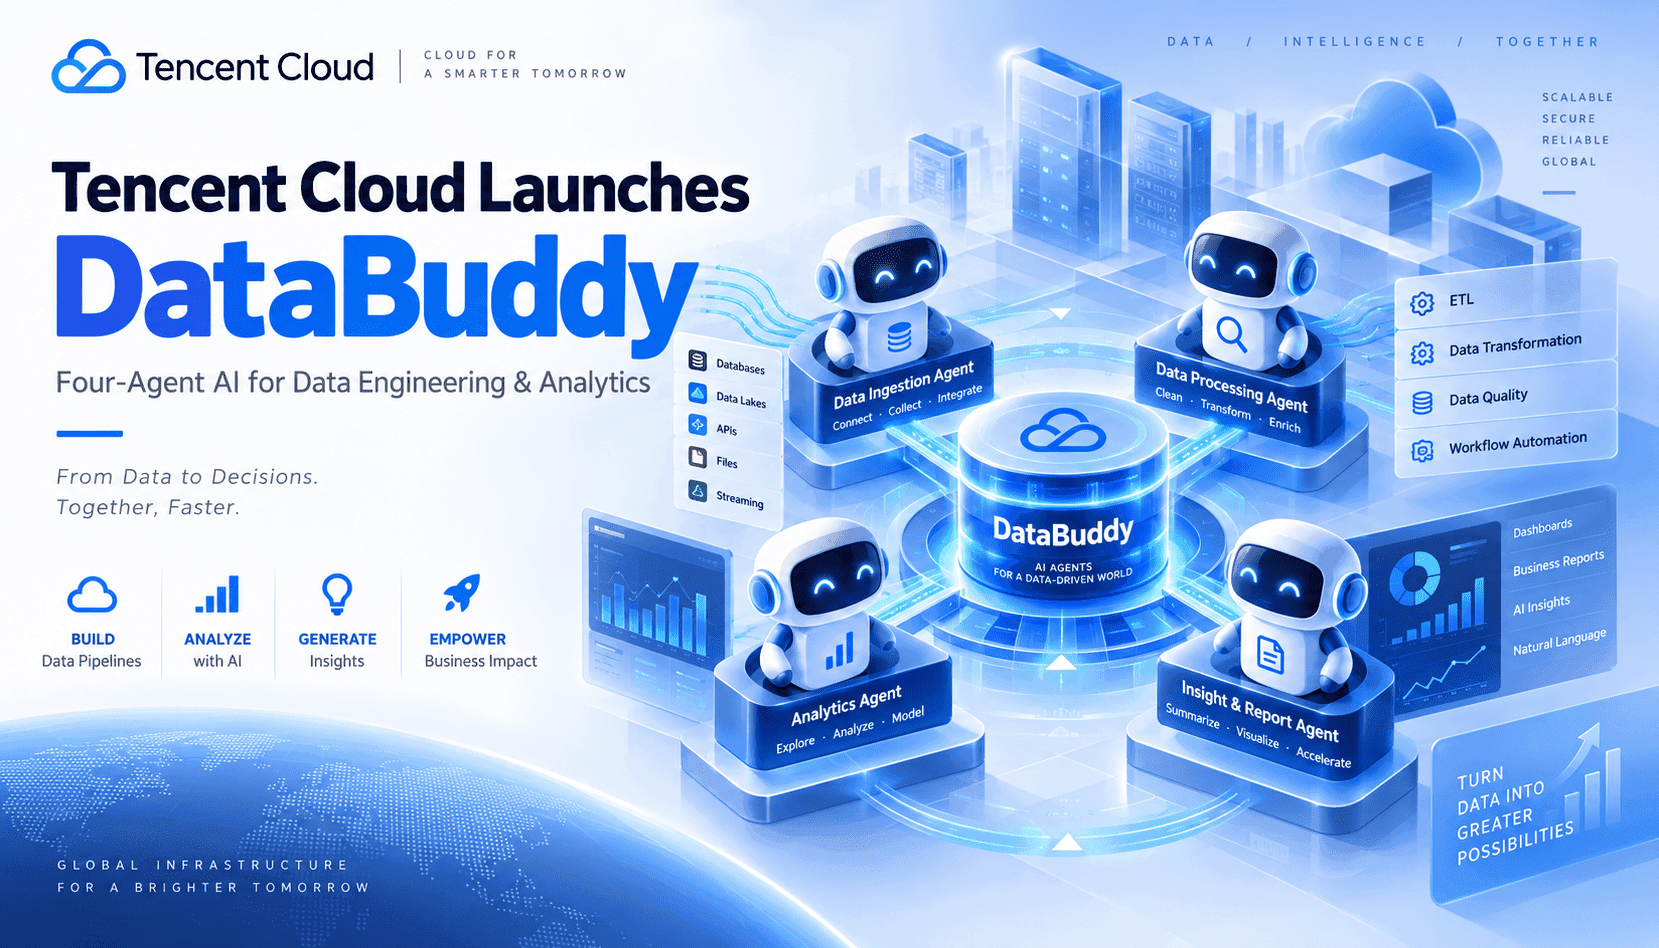
O DataBuddy da Tencent Cloud embala um padrão de quatro agentes em um serviço que resolve a dor mais crônica dos dados empresariais: mudanças lentas em ETL e BI baseadas em tickets. Em vez de encaminhar solicitações para engenheiros sobrecarregados, o DataBuddy orquestra agentes para montar pipelines, escrever SQL e explicar resultados sob regras de governança. A abordagem é opinativa, mas pragmática: codificar o trabalho rotineiro de dados em papéis de agentes, medi-los como serviços e manter humanos na revisão para acesso, privacidade e custo. Essa mudança reflete como o DevOps amadureceu — ferramentas, automação e políticas substituindo heroísmos e planilhas.
Por trás dos bastidores, um agente planeja tarefas, outro atua como engenheiro de dados gerando conectores, transformações e SQL, um terceiro funciona como analista produzindo insights e narrativas, e um quarto revisa qualidade e alinhamento com políticas. Esse último papel é crucial: verifica suposições de esquema, junções, risco de vazamento e exposição de dados pessoais antes de enviar resultados para dashboards ou notebooks. Quando bem instrumentado, logs capturam prompts, decisões, código gerado e linhagem para que equipes possam reproduzir resultados, reverter mudanças e comparar desempenho dos agentes entre conjuntos de dados — essencial para confiança e auditoria.
Onde isso se encaixa? Pense no DataBuddy como um plano de controle que fica entre seu lakehouse e seus consumidores. Ele deve complementar os trabalhos Spark/SQL existentes, governança de custos e ferramentas de catálogo, não substituí-los. Os pontos ideais são mudanças de BI com backlog pesado, exploração ad hoc que ainda deve respeitar políticas, e tarefas repetitivas de ingestão ou qualidade de dados. As perguntas abertas são de nível empresarial: como ele se conecta a identidade, catálogos e rede VPC; como aplica privilégio mínimo no nível de tabela/coluna; e como aloca computação para limitar gastos sem restringir o throughput.
Enquadramento da decisão: pilote com um domínio delimitado (ex.: operações de vendas ou atribuição de marketing), uma tabela fato conhecida e duas dimensões confiáveis. Defina critérios de aprovação/reprovação: tempo para o primeiro insight, precisão da consulta versus SQL referência, violações de qualidade de dados detectadas e custo por tarefa bem-sucedida. Direcione os resultados para dashboards existentes, não para um silo novo. Mantenha um revisor humano no processo para exceções de política. Se o piloto atingir os limites, escale adicionando produtos de dados, não tabelas aleatórias — trate cada produto como um contrato com SLAs, linhagem, testes e alertas, com agentes DataBuddy como camada de execução.