


NVIDIA RTX Spark
NexusAi 摘要: 面向本地 AI 智能体、创作者和开发者的紧凑型 RTX 硬件与软件平台。RTX Spark 将 Blackwell 级 RTX GPU 与 Grace CPU 和统一内存相结合,可在本地运行大型模型,并加速 3D、视频和推理工作流。
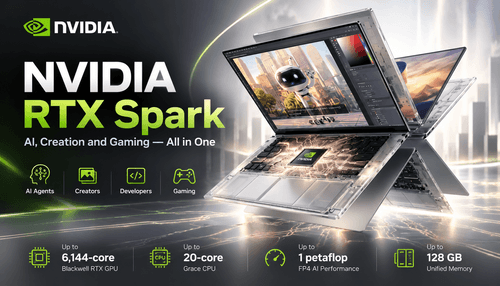
NexusAi 概览
在实际使用中,RTX Spark 让开发者能够在本地快速迭代:在设备上训练或微调模型、运行多组件智能体,并以 GPU 加速预览 3D 场景,无需承受云端延迟。统一内存可减少模型切分,让单台机器支持更大的上下文窗口。
功能与技术概况
RTX Spark 最适合需要本地运行模型和低延迟智能体的工程师及技术决策者:迭代模型行为的 AI 研究人员、构建私有智能体的开发者、需要离线渲染和高质量视频编码的创作者,以及希望获得桌面级推理能力又不想承担云服务费用的小型团队。它也适用于管理边缘部署、需要安全本地处理的运营团队。
- 借助最高 128 GB 统一内存,在本地运行大型模型推理。
- 支持原生 CUDA、TensorRT 和 NVFP4,加速 FP4 推理。
- 支持 HEVC、H.264 和 AV1 编解码,满足快速媒体工作流需求。
- 运行个人 AI 智能体,在保留本地数据的同时执行工作流。
- 代码可无缝扩展至云端 NVIDIA GPU,无需修改。
实用趋势与应用场景
设备端智能体工作流
首先准备一台搭载 Windows 11 的 RTX Spark 系统,安装 NVIDIA Studio 或 Game Ready 驱动,然后配置 CUDA 工具包。推理时可使用 TensorRT 和 NVFP4 优化;NGC 提供预构建容器和模型,帮助快速制作原型。开发者无需修改代码,即可在更大型的 NVIDIA 服务器上运行相同的二进制文件,从本地测试到云端扩展,工作流始终一致。NVIDIA 开发者门户上的文档和 SDK 涵盖驱动配置、性能调优和媒体编解码器用法,助你实现最佳吞吐量。
NexusAi: 在本地运行模型,实现即时迭代和可预测的成本,同时让敏感数据留在自己的设备上。
入门与开发者路径
RTX Spark 将高效硬件与 CUDA 生态系统相结合,缩小了笔记本的便捷性与数据中心级能力之间的差距。它能降低持续运行智能体工作负载的运营成本,加速创意工作流,并为隐私敏感型应用保留数据本地性。对于需要即时迭代模型并追求可预测设备端性能的团队而言,RTX Spark 是一款紧凑、以开发者为先的平台。
打开该工具并查看其核心产品体验。
创建账户或进入你已有的工作空间。
使用你自己的任务判断速度、质量和适配度。
在最终决定前查看类似 AI 工具。
NVIDIA RTX Spark
NVIDIA 打造加速 AI、图形和仿真的硬件与软件技术栈。公司在 GPU、CUDA 工具、驱动程序和开发者平台方面拥有深厚积累,帮助工作负载在本地设备与数据中心之间顺畅迁移。
RTX Spark 是一款紧凑型平台,将数据中心级 AI 能力带入轻薄笔记本和小型台式机。它集成 NVIDIA Blackwell RTX GPU、Grace CPU 和最高 128 GB 统一内存,支持大型模型本地推理、智能体运行以及 GPU 加速的创作工作流。该平台支持 CUDA、TensorRT 和 NVFP4 优化,可实现高吞吐量 FP4 推理、原生设备端开发,并在需要时无缝扩展至云端 NVIDIA GPU。RTX Spark 面向受益于低延迟、数据本地化和离线运行的工作流,包括交互式模型开发、实时智能体编排、设备端视频与 3D 渲染,以及在紧凑型台式机上不间断运行的全天候推理。它旨在缩短迭代时间,免除本地工作负载的按提示计费,并借助 NVIDIA 生态系统中通用的 CUDA 兼容工具链,提供从开发到部署的一致体验。
访问 NVIDIA RTX Spark
评论 (0)
暂无评论