

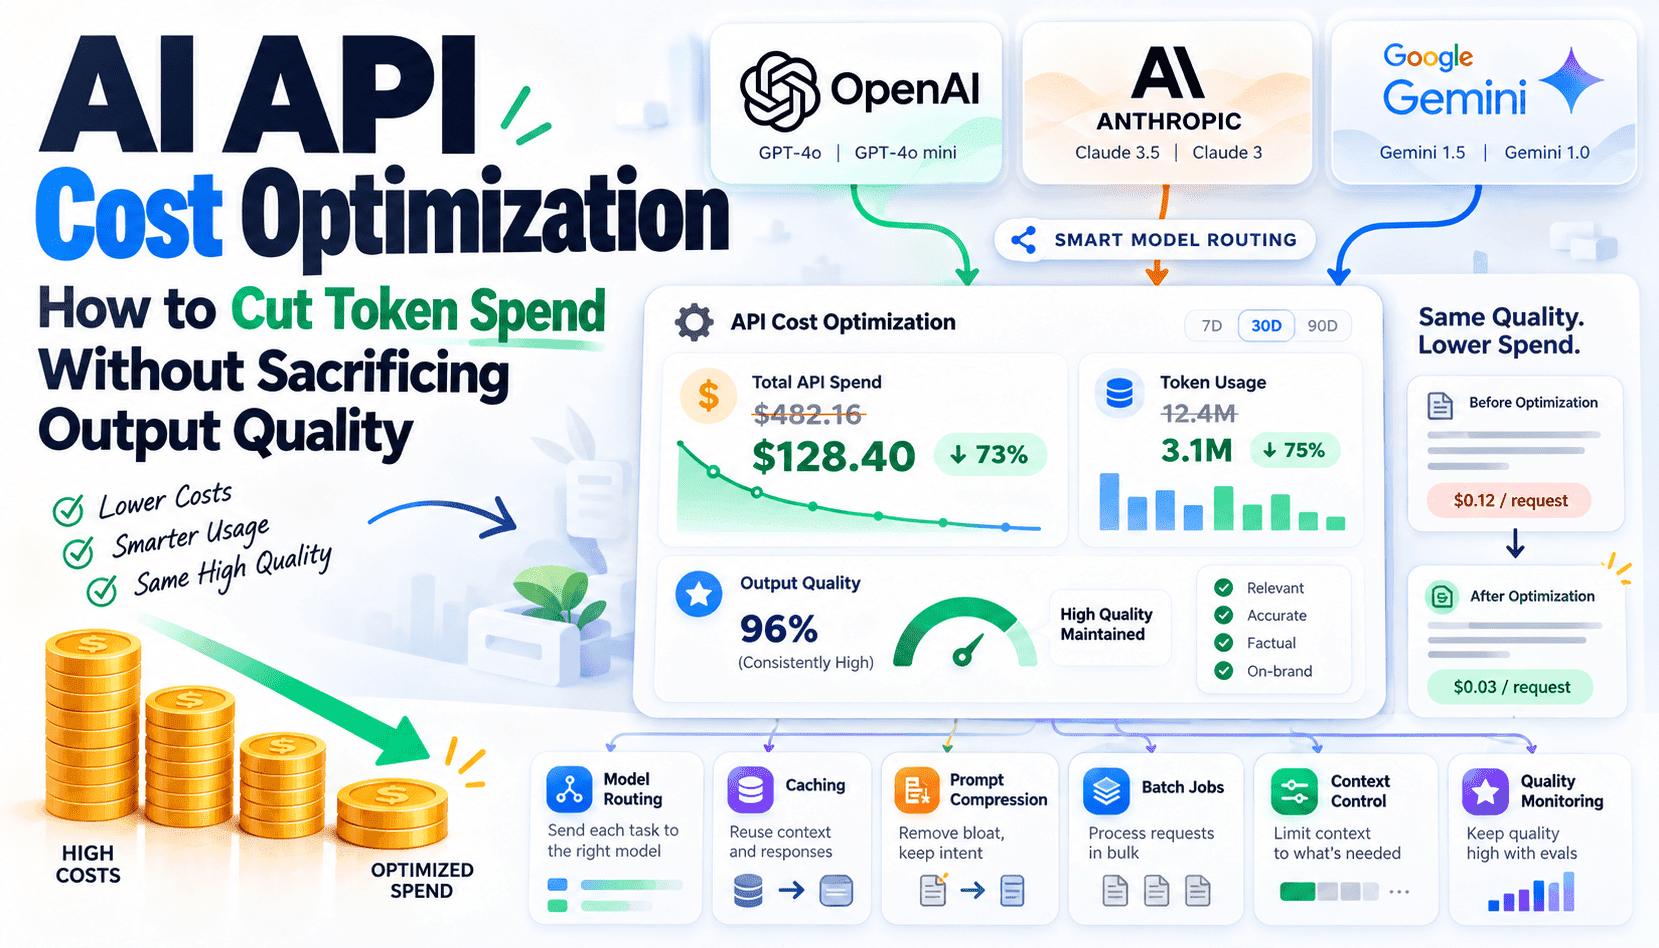
生成式 AI 的迅猛发展,使 Token 成本成为一项不可忽视的支出。如果缺乏管理,Token 开支会随着用户量增长、上下文变长以及输出失控而不断攀升。成本优化并不意味着始终选最便宜的模型,而是要根据任务复杂度匹配模型能力,减少输入和输出中的无用 Token,并调整工作流程,让高成本推理只用于能显著改善业务成果的场景。本文将介绍团队可以采用的运营手段,以及衡量权衡效果所需的指标。
首先,建立路由与能力映射:按照请求的复杂度和对质量的敏感程度进行分类,再将低复杂度任务交给更小、更便宜的模型或确定性模块处理。例如,简短文案润色、格式严格的翻译或简单的意图提取,通常可以由蒸馏模型或启发式规则完成;创意长文生成和细致的多步推理,则应交由能力更强的模型。为每条路由记录成功率和回退情况,以便发现低成本方案何时失效,并有选择地升级处理。
通过提示词工程控制成本,实际可行的做法有三种:精简指令但不损失语义、尽可能复用共享系统上下文,以及删减动态上下文。使用紧凑模板、编号的少样本示例和结构化函数 Schema,减少冗长内容。将稳定的系统上下文保存在服务器端,只追加增量动态信息。对于较长的对话历史,采用摘要,而不是重新发送原始消息;对于文档密集型任务,则检索并排序最相关的段落,而不是把整份文档都塞进提示词。
除了提示词,还应在技术栈中加入缓存、批处理和流水线控制。结合语义匹配与精确匹配的混合缓存,可以避免对相同请求重复执行高成本推理。在非高峰时段或成本更低的计算资源池中处理低优先级任务。尽可能设置输出上限、停止 Token,并使用确定性函数调用,避免模型生成无边界的文本。最后,采用统一的成本控制框架,同时跟踪输入 Token、输出 Token、缓存命中率、延迟和质量指标,让决策兼顾价格与产品成效。