

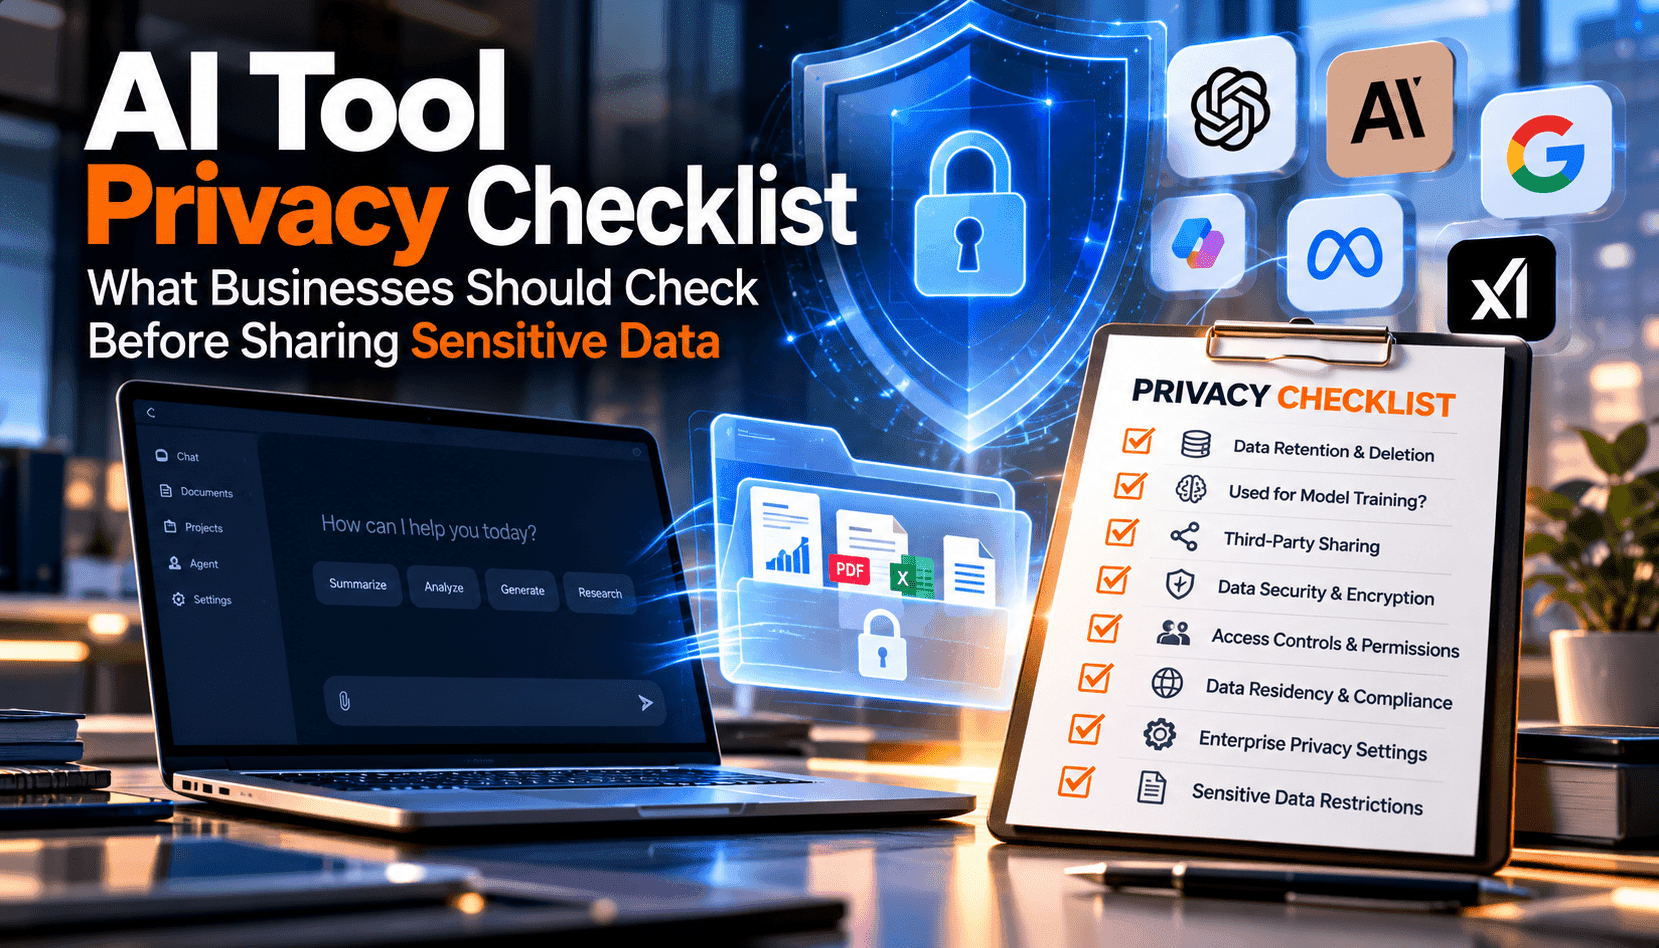
AI 工具现已融入日常工作流程——从销售笔记到法律草案——使隐私尽职调查成为前端必需,而非后台任务。在任何团队上传提示或文档之前,您需要明确谁可以访问数据、数据如何被处理,以及是否会被用于模型训练或分析。您的检查清单应精准、文档化且可重复执行,避免一线团队猜测。本指南汇总了一套实用的问题和决策测试,用于评估商业及公开可用的 AI 产品,重点关注敏感信息处理、供应商控制以及允许投入生产使用前应收集的证据。
从数据最小化原则开始:不要将个人或特别敏感的数据输入到公开可访问的生成式 AI 工具中。如果您的用例确实需要处理个人信息,请切换到带有合同保障和技术控制文档的企业计划。确认供应商或其子处理方是否能查看提示、附件或输出,以及这些材料是否被用于训练基础模型或微调模型。如果提供选择退出,验证其是否涵盖训练和更广泛的分析遥测,并且默认在您的租户和 API 级别启用,而不仅仅是用户界面。
保留、删除和数据流是提示发送后隐私风险持续存在的关键环节。要求书面说明日志保留、缓存窗口和模型产物存储的默认设置,以及涵盖备份和处理器副本的可验证删除路径。绘制每个环节:客户端、网关、模型主机、向量存储、文件转换器、内容过滤器和可观测性管道。要求传输和静态加密、支持强 MFA 的单点登录、基于角色的访问控制、私有网络选项以及阻止包含敏感标识符上传的 DLP 策略。最后,嵌入人工监督:准确性检查、升级路径,以及用户与 AI 系统交互时的明确提示。
将供应商入职视为生命周期的开始,而非绿灯事件。记录隐私影响评估、合法依据或同意模型,以及批准使用的具体目的。建立变更控制触发条件——新功能、处理器新增、区域变更或训练政策更新——确保工具在风险漂移前重新审查。监控输出的准确性和无意生成的个人数据,向员工发布安全提示指南,定期进行审计。如果风险无法控制——尤其是涉及敏感信息时——请将该数据排除在工具之外并重新设计工作流程。