

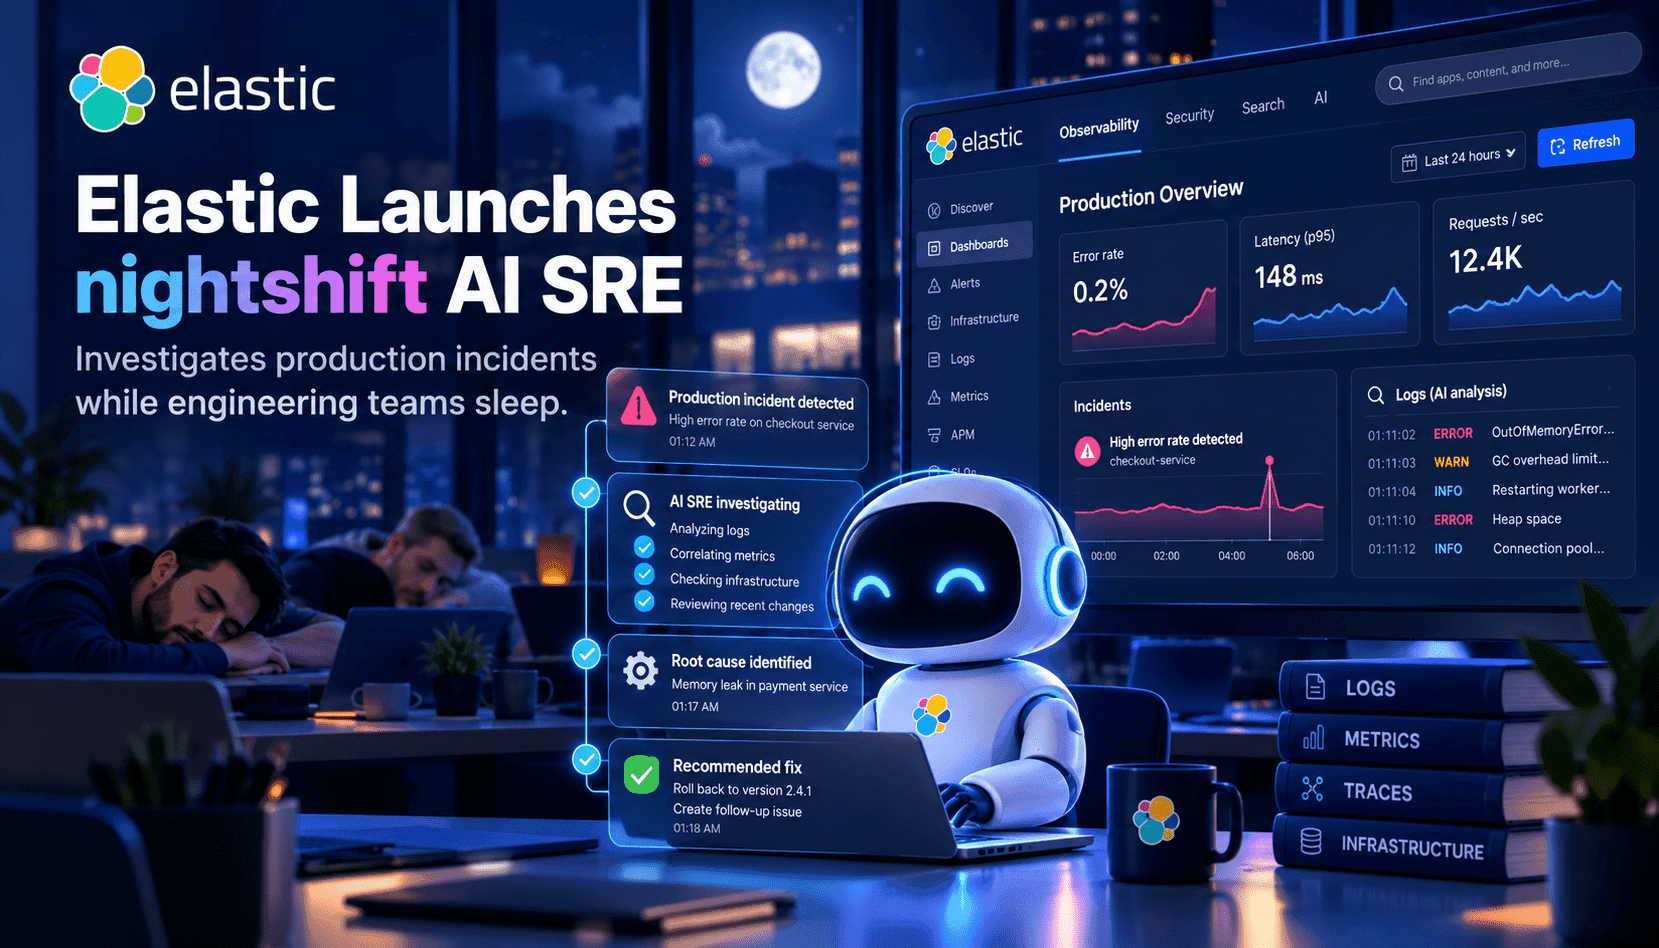
Elastic 全新的夜班 AI SRE 将自主智能体置于可靠性保障的一线:智能体不会等人来查询仪表板,而是持续监测日志、指标、链路追踪数据和上下文信息,发现异常、分诊事件并汇集证据。它带来的实际好处直接而明显——工程师收到告警时,调查工作已经有了清晰的开端:相关事件、可能的根因以及建议的修复步骤。这些前期工作能缩小排查范围,减少事件响应中成本最高的环节——在嘈杂、分布式的遥测数据中摸清状况。
从技术角度看,夜班能力依赖三项协同工作的功能:对日志、指标和链路追踪数据进行高保真采集与查询;将运行手册和拓扑信息关联到遥测数据的上下文存储;以及能够按顺序执行读取、归纳和操作步骤的智能体推理。Elastic 的技术栈本就具备强大的数据采集和搜索能力;其独特之处在于将这些能力整合进持久运行的智能体,让它们能持续数小时保留状态,只在需要人工判断时才升级处理。这改变了可观测性数据的组织、优先级排序和呈现方式——智能体成为遥测数据的主动使用者和整理者,而不再只是被动查看仪表板。
从运维角度看,持久运行的智能体持续完成发现和关联工作,从而缩短平均检测时间和平均解决时间。夜班智能体可以收集日志、生成时间线证据、依据历史基线验证假设,并执行设有保护措施的修复步骤(例如启用熔断器、切换日志级别或安全故障转移)。不过,这种模式能否发挥价值,取决于团队是否建立可信机制:可测试的操作手册、透明可追溯的智能体操作记录,以及明确的升级边界。这样,团队既能受益于非工作时间自动完成的工作,也能保留责任和决策权。
对于正在评估夜班类智能体的工程负责人和 SRE 来说,眼下需要考虑的都是实际问题:如何接入运行手册、需要达到怎样的遥测数据保真度、如何落实回滚和影响范围控制,以及如何衡量投资回报。试点项目应聚焦于范围明确的事件类型,例如内存泄漏、重试过多或外部依赖故障;这些场景的关联规则清晰,也有安全的修复步骤可用。衡量成效时,除了值班告警噪声、问题定位时间和修复时间是否下降,还应收集值班团队对系统的信任度等定性反馈。