

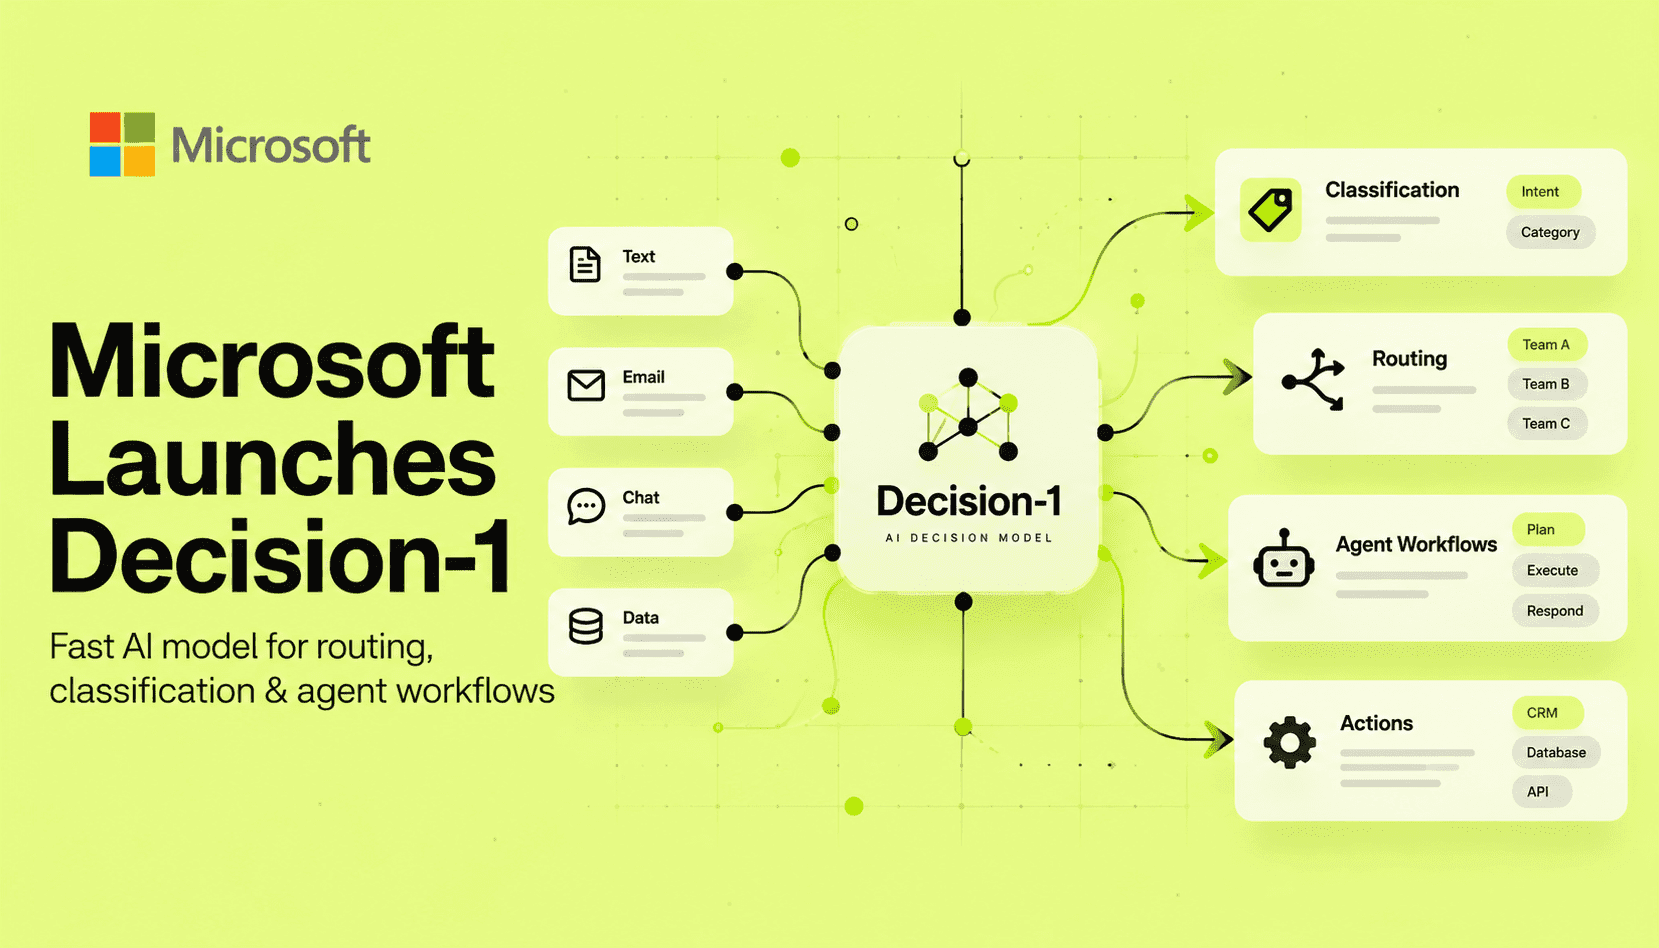
Microsoft-Decision-1 是一款专用评分模型,适用于需要作出决策的软件,例如选择、排序、分类、验证或评分,而非生成内容。与专注于生成流畅文本的通用 LLM 不同,它能通过一次前向推理输出结构化结果和经过校准的概率。对产品团队而言,这一区别至关重要:它能将决策密集型工作负载从成本高、延迟大的 LLM 调用,转变为轻量、确定性的评分步骤,适用于实时智能体、Webhook 和高吞吐量内容审核流水线。
从技术层面看,微软称该模型基于 Qwen3.5‑9B 构建,并针对概率校准和低延迟推理进行了优化。模型会为带标签的候选项输出概率,软件可以直接利用概率向量进行路由或基于阈值作出决策。这样既不必往返调用生成文本的 LLM,也省去了额外的解析或启发式信息提取。一次推理即可获得经过校准的分数,也让下游遥测更简单:团队可以衡量置信度、调整阈值并部署防护机制,无需投入高昂成本进行提示工程或构建多步验证链。
微软公布的基准测试结果颇为亮眼:Decision‑1 在涵盖 36 项基准的比较中准确率排名第一,而且速度远超生成式基线模型。据报告,在微软的测试中,它比 GPT-6 Sol 对照模型快 35 倍。当延迟、单次推理成本和吞吐量直接影响产品约束时,这样的提升尤为重要。不过,基准测试的环境、硬件、批处理方式和数据集匹配度都很关键;在调整架构之前,团队应先在生产技术栈上复现关键微基准测试。
在实际应用中,Decision‑1 介于轻量级分类器和大型 LLM 之间:它比小型分类器更专业,因为经过训练和校准,可处理多种决策任务;同时,与调用完整生成式 LLM 来解析并作出决策相比,它的成本和速度优势明显。对工程团队而言,这提供了一套清晰的实践方案:当任务是选择、路由、评分或验证时,用它替代完整文本 LLM 调用;而创作、摘要或长篇综合分析任务,则继续交给生成式 LLM。
将决策模型投入生产,需要关注概率校准、分布偏移,以及与现有智能体工具链的集成。团队应监控置信度阈值;一旦出现校准异常或数据漂移,就回退到生成式 LLM;同时建立训练和评估周期,使决策模型适配业务特定类别和成本目标。实施得当时,Decision‑1 可以降低延迟和推理成本,并提升决策密集型流程的确定性。