

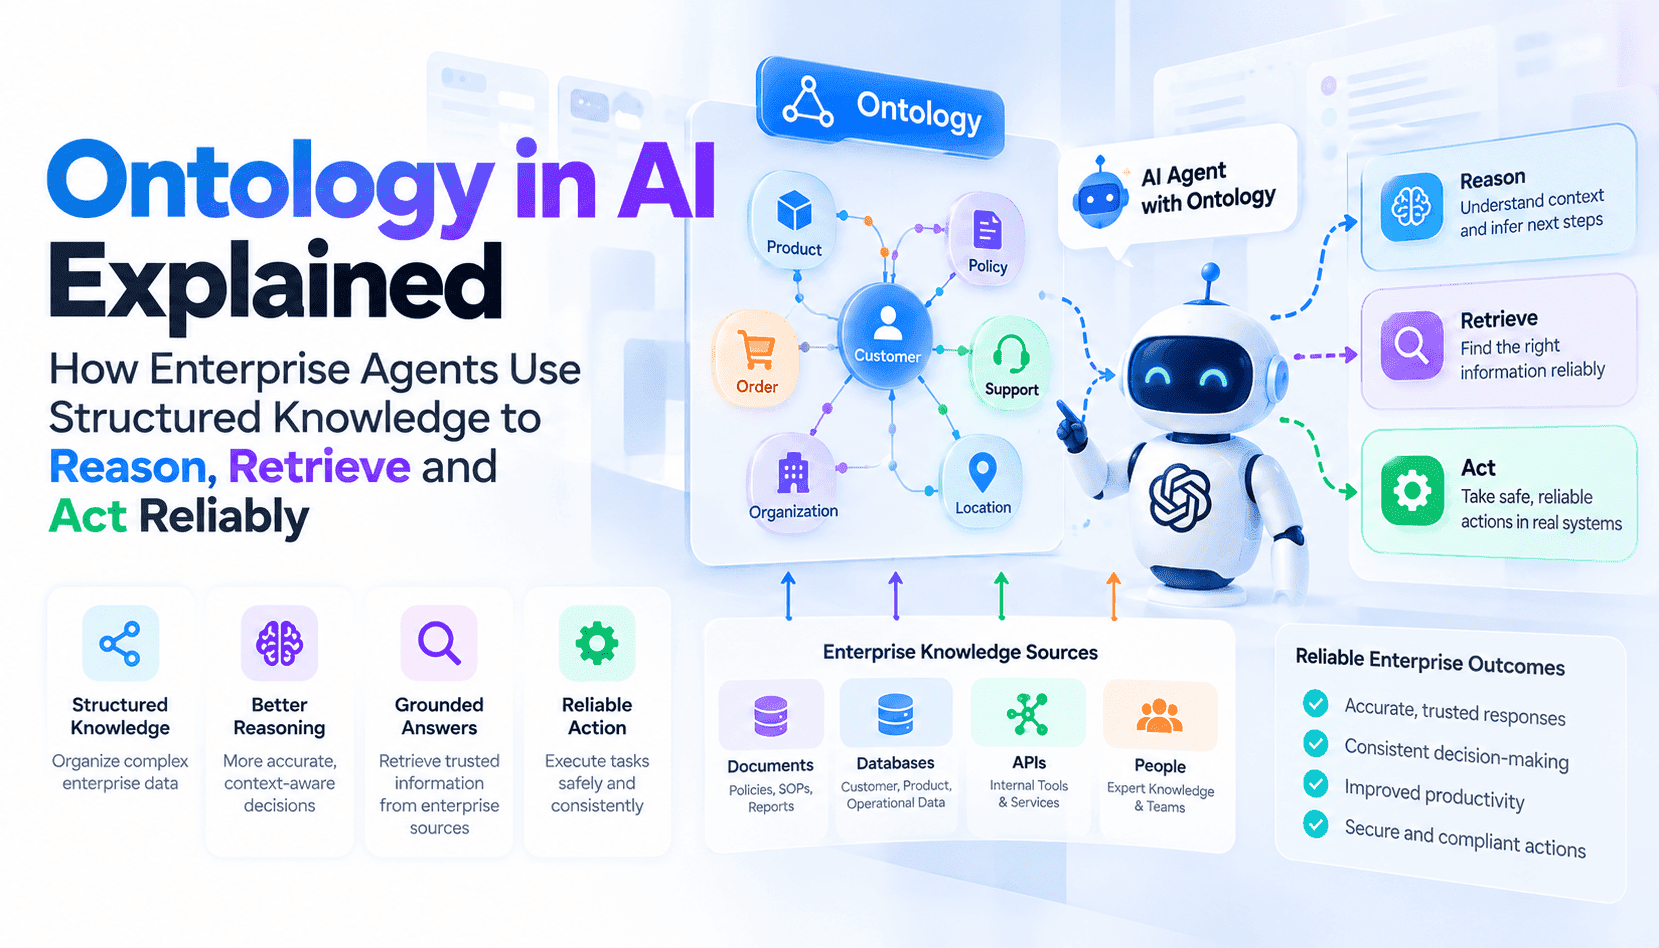
企业 AI 在数据接入方面已基本成熟:连接器、数据仓库和检索方法都已相当完善。如今更棘手的问题,是如何在大规模环境中保持语义一致。智能体即使能查询所有数据表,也仍可能误解 customer_status 或 revenue 这样的字段。本体论通过编码业务概念及其属性、关系和公理来解决这一问题,让 AI 系统能够推理数据的含义,而不是把数据当作没有标签的词元或模式元素。这个转变会影响自动核保、管理层报告等下游决策,因为程序化且反复发生的错误会不断累积。
本文从实际应用场景出发,介绍哪些组成要素能让本体论真正服务于智能体,说明本体论与分类体系、知识图谱和语义层有何不同,并通过客户风险画像、收入指标和保险理赔等具体案例,展示智能体在运行时所需的治理、数据血缘和访问控制信号。我们的目标着眼于实际落地:设计适用于 AI 的本体论,提供可追溯性、权威定义和执行控制接口,让智能体选对数据并采取恰当行动,同时也让人们能够有信心地审计决策。
本体论让推断成为可能。目录或分类体系只能对资产进行归类,而公理则能让智能体推断出数据中未明确存储的事实:包含个人身份信息(PII)的数据集会继承受限访问权限;两个条目如果共用同一税号,可能代表同一个法人实体;订阅到期并不意味着客户义务随之终止。这些推断能减少脆弱的规则清单,让运行时决策更稳健。但这需要有意识地建模:定义类、实例、属性、有向关系和形式化约束,并将它们映射到物理数据、负责人和策略。
最后,我们提供一套轻量级实施框架,可在最初 4–8 周内应用。先从一个决策或智能体工作流入手,建模 20–50 个高影响概念,定义推理所需的关系和公理,并立即将概念关联到数据血缘、质量评分和访问规则。衡量成效时,应关注推理准确性、可追溯性和访问感知能力,而不只是采用率。这样,本体论就能成为持续演进的治理资产,随着 AI 应用不断扩展,而不是逐渐沉寂在文档库中。