

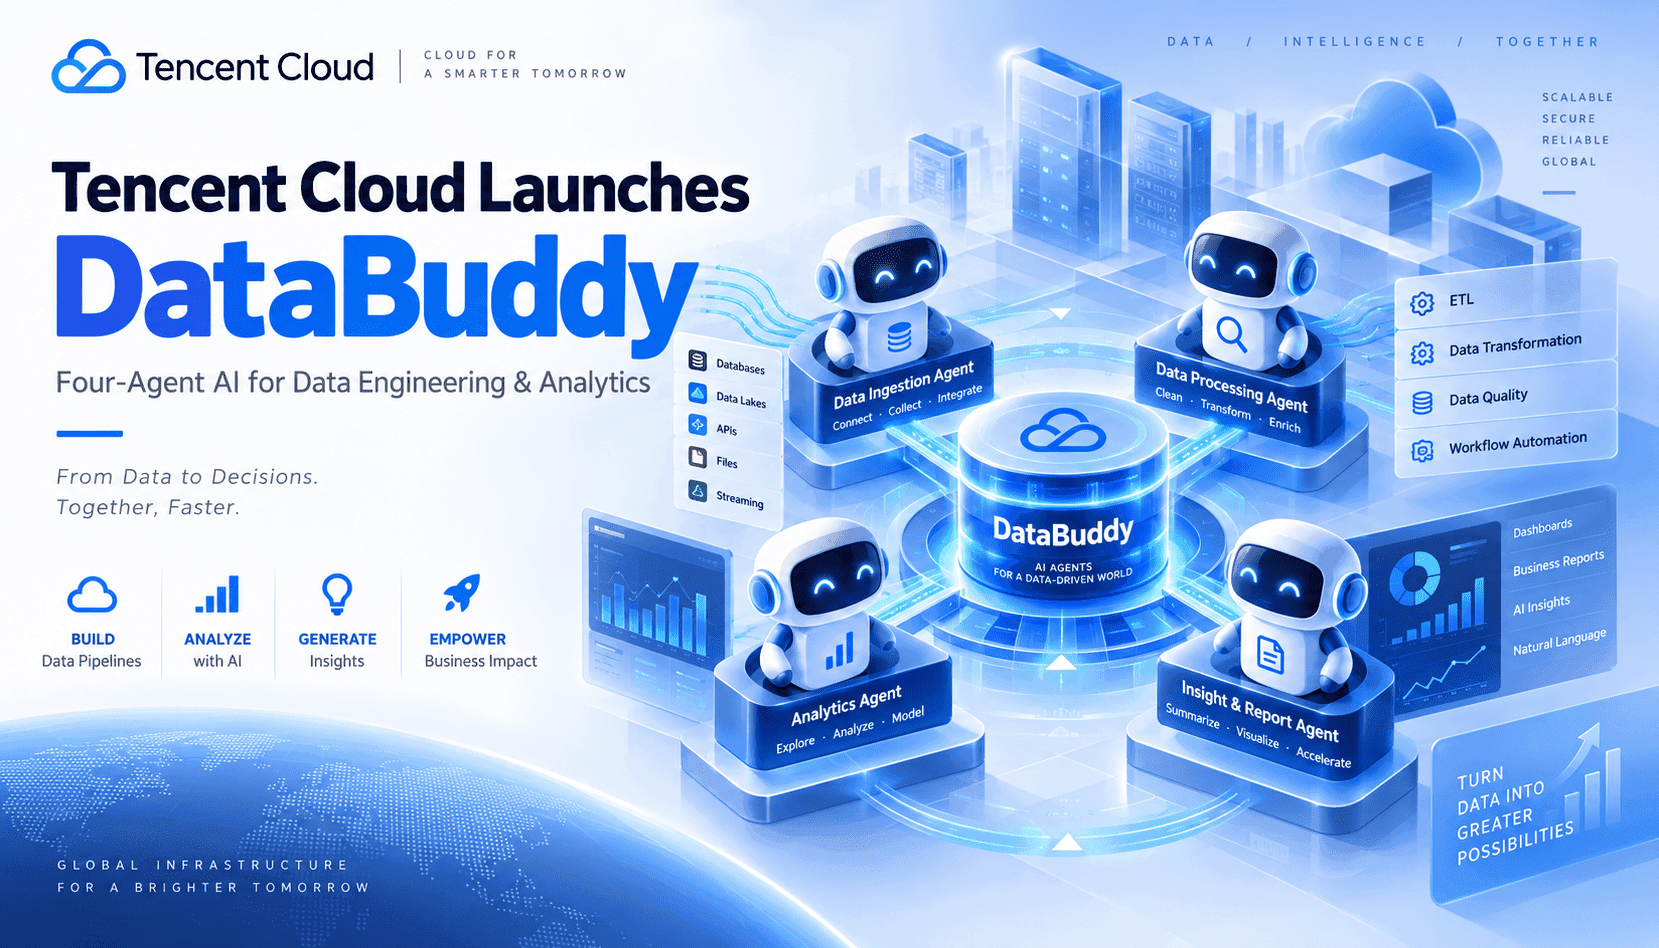
腾讯云的 DataBuddy 将四智能体模式打包成一项服务,解决企业数据中最顽固的痛点:缓慢且依赖工单的 ETL 和 BI 变更。它不再将请求转给过载的工程师,而是通过智能体协同组装数据管道、编写 SQL 并在治理规则下解释输出。该方法既有明确的指导思想,也非常务实:将常规数据工作编码为智能体角色,像管理服务一样衡量它们,并让人类负责访问、隐私和成本的复核。这一转变类似于 DevOps 的成熟过程——工具、自动化和策略取代了英雄主义和电子表格。
在系统内部,一个智能体负责任务规划,一个扮演数据工程师角色生成连接器、转换和 SQL,第三个作为分析师产出洞察和叙述,第四个负责质量和政策合规审核。最后一个角色尤为关键:它在结果发送到仪表盘或笔记本前,检查模式假设、连接、泄露风险和个人身份信息(PII)暴露。正确部署时,日志会记录提示、决策、生成代码和数据血缘,方便团队复现结果、回滚变更并比较不同智能体在数据集上的表现——这是建立信任和审计的关键。
DataBuddy 的定位是作为湖仓与消费者之间的控制平面。它应当补充现有的 Spark/SQL 作业、成本治理和目录工具,而非取代它们。其最佳应用场景是积压严重的 BI 变更、必须遵守政策的临时探索,以及重复的数据摄取或质量任务。企业级的开放问题包括:如何绑定身份、目录和 VPC 网络;如何在表/列级别执行最小权限;以及如何分配计算资源以控制开支而不影响吞吐。
决策框架:先在有限领域(如销售运营或市场归因)、已知事实表和两个可信维度中试点。定义通过/失败标准:首次洞察时间、查询准确度与标准 SQL 的对比、捕获的数据质量违规以及每个成功任务的成本。输出路由到现有仪表盘,而非新孤岛。保持人类复核以处理政策例外。若试点达标,按数据产品扩展,而非随机表——将每个产品视为包含 SLA、血缘、测试和告警的合同,DataBuddy 智能体作为执行层。