

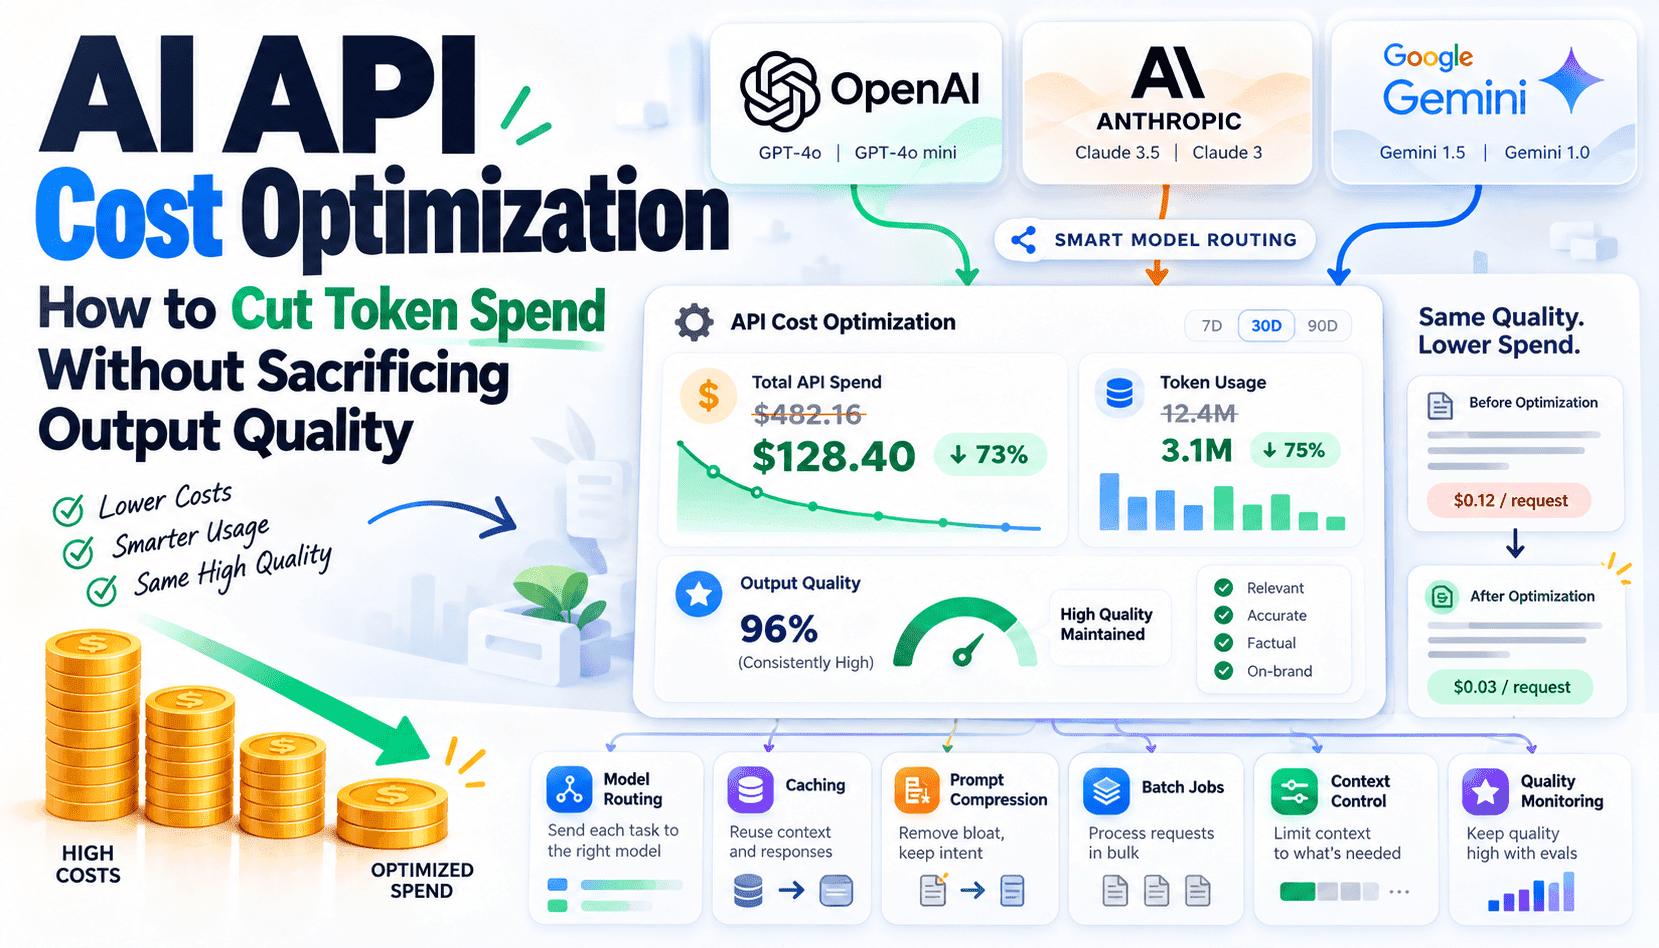
Das Wachstum generativer KI hat Token-Kosten zu einem bedeutenden Kostenfaktor gemacht. Werden sie nicht kontrolliert, steigen die Ausgaben mit der Zahl der Nutzer, langen Kontexten und unkontrollierten Ausgaben. Bei der Kostenoptimierung geht es nicht darum, immer das günstigste Modell zu wählen. Entscheidend ist, die Fähigkeiten des Modells an die Komplexität der Aufgabe anzupassen, unnötige Tokens in Ein- und Ausgaben zu reduzieren und Arbeitsabläufe so zu gestalten, dass teure Inferenz nur dann zum Einsatz kommt, wenn sie Geschäftsergebnisse spürbar verbessert. Dieser Artikel zeigt, an welchen Stellschrauben Teams im Betrieb drehen können und welche Kennzahlen nötig sind, um die Auswirkungen abzuwägen.
Beginnen Sie mit einer Routing- und Fähigkeitsübersicht: Klassifizieren Sie Anfragen nach Komplexität und Qualitätsanforderungen und leiten Sie einfache Aufgaben anschließend an kleinere, günstigere Modelle oder deterministische Module weiter. Kurze Textüberarbeitungen, Übersetzungen mit strengen Formatvorgaben und einfache Absichtserkennung lassen sich beispielsweise oft mit komprimierten Modellen oder Heuristiken erledigen. Kreative Langformtexte und anspruchsvolle mehrstufige Schlussfolgerungen sollten dagegen leistungsfähigeren Modellen vorbehalten bleiben. Erfassen Sie für jeden Routing-Pfad Erfolgsquote und Eskalationen. So erkennen Sie, wann günstigere Wege scheitern, und können gezielt auf leistungsfähigere Modelle ausweichen.
Für eine kosteneffiziente Prompt-Gestaltung gibt es drei praktische Ansätze: Anweisungen kürzen, ohne ihre Bedeutung zu verändern, gemeinsamen Systemkontext optimal nutzen und dynamischen Kontext begrenzen. Verwenden Sie kompakte Vorlagen, nummerierte Few-Shot-Beispiele und strukturierte Funktionsschemata, um überflüssige Länge zu vermeiden. Halten Sie stabilen Systemkontext auf dem Server vor und ergänzen Sie nur die jeweils neuen dynamischen Elemente. Fassen Sie lange Gesprächsverläufe zusammen, statt alle Nachrichten erneut zu senden. Bei dokumentenintensiven Aufgaben sollten Sie die relevantesten Passagen abrufen und sortieren, anstatt ganze Dokumente in den Prompt zu übernehmen.
Ergänzen Sie Ihren Stack über die Prompts hinaus um Caching, Batch-Verarbeitung und Pipeline-Kontrollen. Ein hybrider Cache, der semantische Ähnlichkeit und exakte Übereinstimmungen berücksichtigt, verhindert, dass dieselbe teure Inferenz mehrfach ausgeführt wird. Bündeln Sie Aufgaben mit niedriger Priorität und verarbeiten Sie sie außerhalb der Spitzenzeiten oder in günstigeren Rechenumgebungen. Begrenzen Sie Ausgaben, legen Sie Stopp-Tokens fest und nutzen Sie nach Möglichkeit deterministische Funktionsaufrufe, damit Modelle keine unbegrenzten Texte generieren. Führen Sie schließlich ein einheitliches Kostenkontrollsystem ein, das Eingabe- und Ausgabe-Tokens, Cache-Trefferrate, Latenz und Qualitätskennzahlen gemeinsam erfasst. So lassen sich Kosten und Produkterfolg gegeneinander abwägen.