Beitrag im FokusKI-Ausgaben im Blick
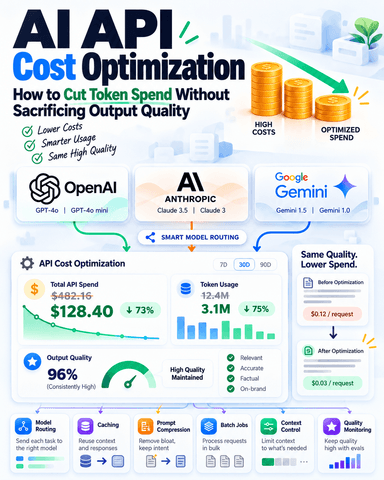
KI-API-Kosten optimieren: Token-Ausgaben senken, ohne Abstriche bei der Ausgabequalität
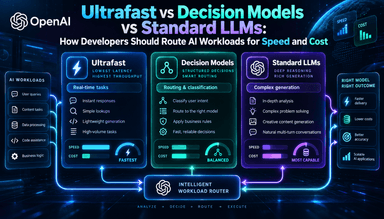
Ein praxisnaher Leitfaden für Engineering- und Produktteams, um die Token-Ausgaben für KI-APIs zu senken und gleichzeitig die Nutzererfahrung zu erhalten. Dieser Leitfaden kombiniert intelligentes Modell-Routing, Prompt-Komprimierung, Caching, Retrieval, Batch-Pipelines und einen Rahmen zur Kostenkontrolle. So können Teams Ausgaben reduzieren, ohne die Qualität zu beeinträchtigen.