

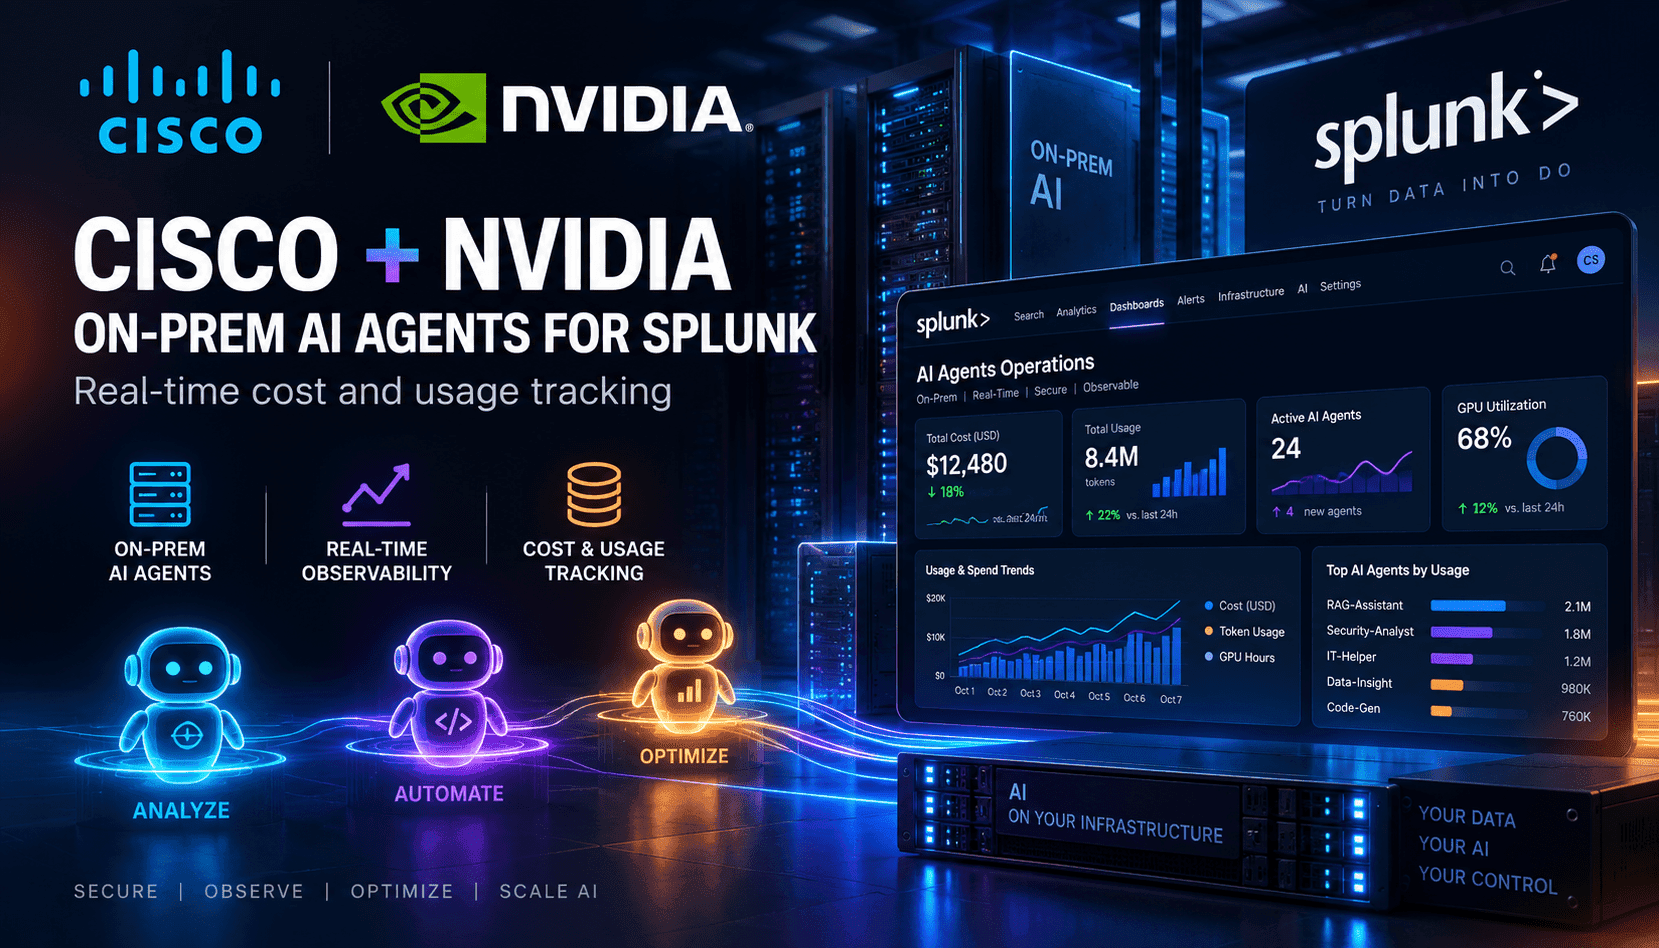
Unternehmen, die Telemetriedaten zentral in Splunk verwalten, standen lange vor einem Dilemma: Daten vor Ort für Souveränität und Sicherheit behalten oder in die Cloud verschieben, um moderne KI-Agenten zu nutzen. Das neue AI POD von Cisco für Splunk, basierend auf NVIDIA-beschleunigter Rechenleistung und einer Kubernetes-Laufzeitumgebung, schließt diese Lücke. Es ermöglicht Teams, Splunks AI Assistant und den aufkommenden Agent Launchpad direkt neben ihren Protokollen und Metriken auszuführen und dabei eine Mischung aus offenen und proprietären Modellen selbst zu hosten. Der vorvalidierte Stack reduziert Integrationsrisiken und die Zeit bis zum Nutzen, indem er Betriebs- und Sicherheitsteams eine Agentenbasis bietet, die sie mit den gleichen Kontrollen absichern können, die sie bereits für ihre Observability-Umgebung verwenden.
Die herausragende betriebliche Neuerung ist die Sichtbarkeit von Kosten und Verhalten. Die Tokenomics-Funktion von Splunk Agent Observability verfolgt den Tokenverbrauch nach Agent, Nutzer und Workflow – einschließlich Programmieragenten wie Claude Code, Codex oder Cursor – sodass Führungskräfte die Nutzung an Wert statt an Anekdoten messen können. Sie prognostiziert den Verbrauch mittels Zeitreihenmodellierung, warnt vor Endlosschleifen und ordnet Kosten den Geschäftseinheiten zu. Da dieselbe Plattform Eingaben, Antworten und Tool-Aufrufe überprüft, können Teams Laufzeitschutzmechanismen anwenden, um unsichere Aktionen zu blockieren und Halluzinationen einzudämmen. Praktisch bedeutet das, Budgets festzulegen, Übernutzung in Echtzeit zu verhindern und den ROI mit Wirtschaftlichkeitskennzahlen statt mit Überraschungen am Monatsende zu belegen.
Strategisch beschleunigt diese Architektur den Übergang von Pilotprojekten zu einem gesteuerten Agentennetzwerk. Indem die Modellausführung an die Daten gebracht wird, vermeiden Unternehmen fragile ETL-Pfade und reduzieren das Risiko von Datenabflüssen. Die Modellauswahl bleibt flexibel: Teams können offene Modelle wie die NVIDIA Nemotron-Familie neben domänenspezifischen Modellen wie Ciscos Deep Time Series Model für Prognosen betreiben. Der Kompromiss liegt in der betrieblichen Reife – Kubernetes, GPU-Planung, Modellevaluation und Prompt-Risikomanagement müssen als erstklassige Disziplinen behandelt werden. Für Käufer verschiebt sich die Frage von „Können wir hier KI einsetzen?“ zu „Welche Agenten rechtfertigen ihren Einsatz, auf welcher Hardware und unter welchen Schutzmechanismen?“ Die Organisationen, die diese Frage präzise beantworten, skalieren schneller und mit weniger Nachbesserungen.