

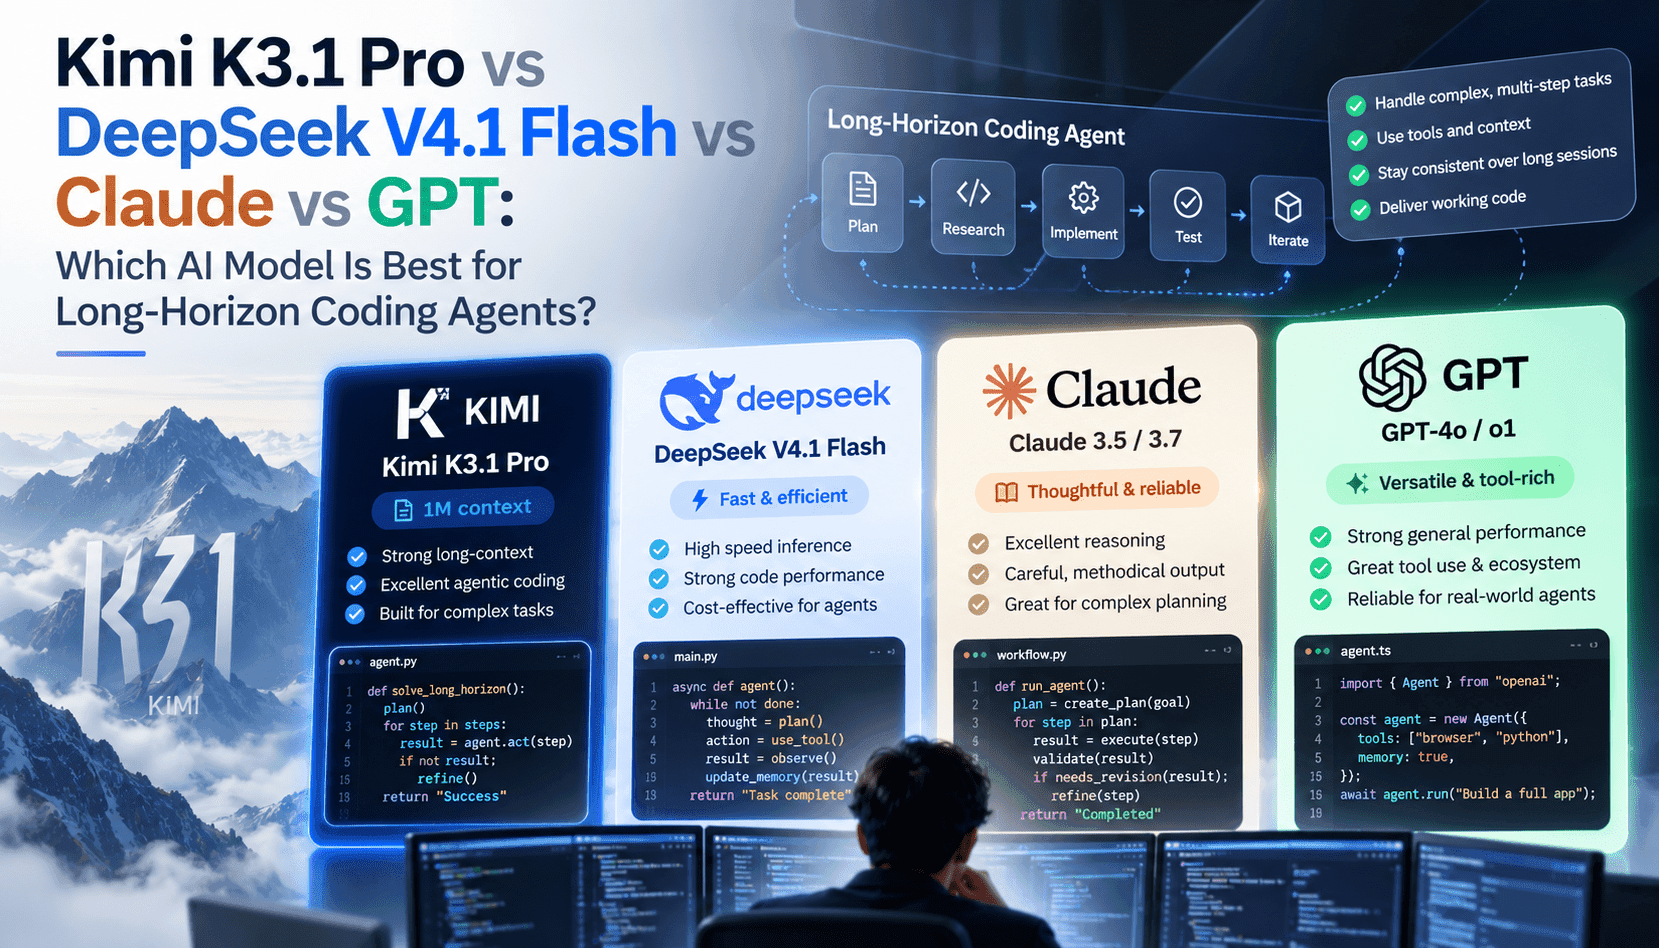
Coding-Agenten mit langfristigem Planungshorizont werden nach anderen Maßstäben bewertet als Modelle, die Code in einem einzelnen Schritt vervollständigen. Sie müssen über zahlreiche Tool-Aufrufe hinweg schlüssig denken, Zustände zuverlässig über Sitzungen hinweg zwischenspeichern, Änderungen effizient inkrementell verarbeiten und die Kosten pro Entwickleraufgabe kalkulierbar halten. Das 1-Million-Token-Kontextfenster und die Funktionen für den Denkmodus von Kimi K3.1 Pro sind gezielt auf diesen Ablauf ausgerichtet. DeepSeeks Flash-Variante setzt auf geringe Latenz und hohen Durchsatz beim Streaming, Claude legt den Schwerpunkt auf Sicherheit und kontrollierbares Schlussfolgern, während GPT-Modelle ein breites Ökosystem und häufig die besten konversationellen Toolchains mitbringen. Für Entwicklungsteams geht es nicht darum, welches Modell objektiv „am besten“ ist, sondern welches zur Größe ihrer Repositories, ihrem CI/CD-Rhythmus, ihrem Budget und ihrer Risikobereitschaft passt.
Die praktischen Abwägungen werden deutlich, wenn man die Modellfunktionen den Agenten-Workflows gegenüberstellt. Ein Kontextfenster mit einer Million Token ist hilfreich, wenn Agenten über mehrere Module, umfangreiche Designdokumente und kumulierte Tool-Ausgaben hinweg Zusammenhänge herstellen müssen – etwa bei Refactorings über mehrere Pull Requests oder Migrationen über mehrere Repositories hinweg. Der Vorteil kommt jedoch nur zum Tragen, wenn der Agent selektiv komprimiert, Retrieval-Augmented Prompting nutzt und den Sitzungscache geschickt verwaltet, statt irrelevante Token zu übermitteln. Eine schnellere Inferenz – etwa mit K3.1 Pro Highspeed oder DeepSeek Flash – verkürzt die Laufzeit und verringert die Wartezeit für Entwickler. Ob schnellere Modelle im Produktivbetrieb tatsächlich die Betriebskosten senken, hängt jedoch von den Kosten pro Token, der Batch-Größe und dem I/O-Aufwand ab.
Offene Modellgewichte verändern die Bereitstellungsabwägung: Teams können Agenten auf eigener Infrastruktur betreiben, die Telemetrie kontrollieren und eine Abhängigkeit von einzelnen Anbietern vermeiden. Dafür müssen sie den betrieblichen Aufwand selbst tragen – von der Inferenzlatenz und dem Sharding langer Kontexte bis hin zur laufenden Aktualisierung von Sicherheitsfiltern. Proprietäre Spitzenmodelle sparen weiterhin Zeit: Besseres Schlussfolgern direkt nach der Einrichtung, integrierte Tool-Ökosysteme und verwaltete Schutzmechanismen verringern den Implementierungsaufwand. Die richtige Wahl hängt davon ab, ob Datenschutz und Latenz im eigenen Rechenzentrum Vorrang haben oder ob möglichst wenig Integrationsaufwand gewünscht ist und man sich bei Sicherheitsupdates und Modellverbesserungen auf die SLAs des Anbieters verlassen möchte.
Neben der reinen Leistungsfähigkeit sollte man auch das Verhalten der Modelle in Agenten mit mehreren Tools prüfen: Unterstützen sie eindeutig definierte Tool-Aufrufe, strukturierte Denkmodi, gestreamte Tool-Ausgaben und Freigaben mit klar geregelten Berechtigungen? Kimi soll mit seinem Denkmodus und den Sitzungssteuerungen Halluzinationen in langen Abläufen reduzieren. Die Leistung von DeepSeek Flash verringert Timeouts in eng getakteten CI-Schleifen. Claudes sicherheitsorientierte Heuristiken machen das Modell für Unternehmen mit strengen Compliance-Anforderungen attraktiv, während GPT-Modelle von einer Vielzahl von Integrationen und Orchestrierungsframeworks von Drittanbietern profitieren. Berücksichtigen Sie bei jedem Modell den Integrationsaufwand, die Nachvollziehbarkeit und das Verhalten bei der Wiederherstellung, wenn ein Tool mitten in einem Plan ausfällt.