

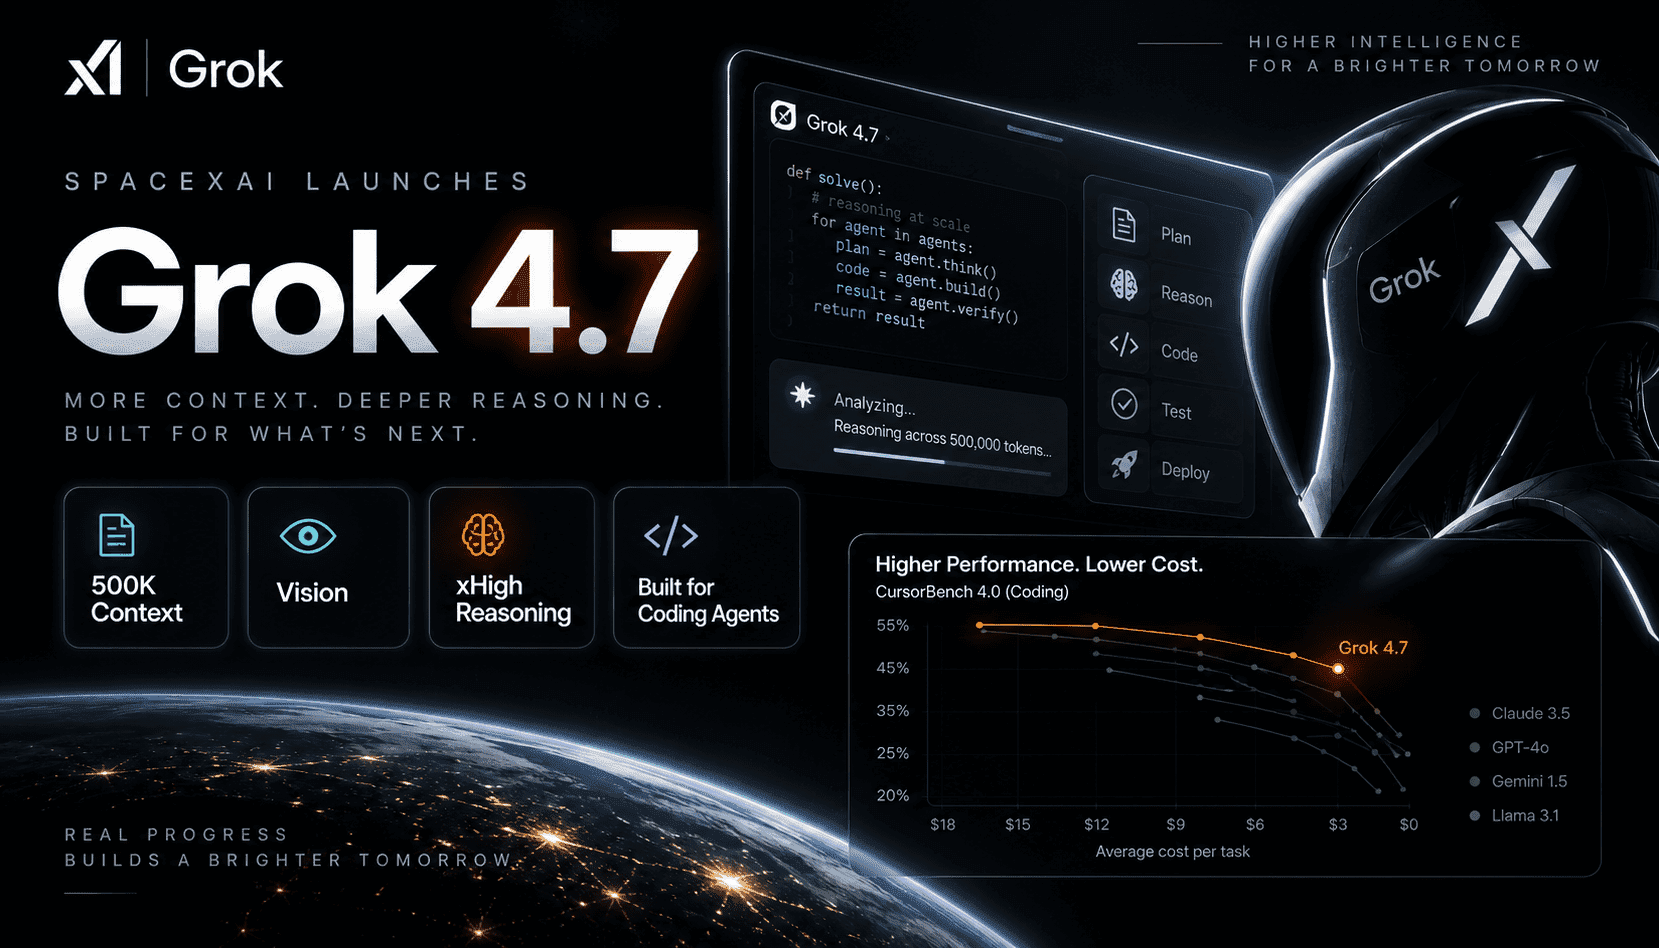
SpaceXAI’s Grok 4.7 ist für nachhaltige Programmier- und Wissensarbeit konzipiert. Ein 500K-Token-Kontextfenster reduziert Abrufzyklen, indem ganze Repositories, Mehrdatei-Diffs oder umfangreiche Spezifikationsdokumente im Speicher gehalten werden können. Die native Vision des Modells bietet Nutzen beim Debuggen von Screenshots, Überprüfen von Diagrammen und Erklären von UI-Zuständen. Am wichtigsten ist, dass 4.7 xHigh Reasoning und Selbstverifikation betont, was längere, zuverlässigere mehrstufige Ausführungen mit weniger Übergaben zwischen Werkzeugen ermöglicht. Angeboten zum gleichen Preisniveau wie 4.6 mit einer schnellen Variante, zielt es direkt auf Entwicklerumgebungen, Programmieragenten und mehrstündige professionelle Aufgaben ab, bei denen frühere Kontext- und Verifikationsgrenzen Reibung verursachten.
Frühe Signale deuten auf ein starkes Preis-Leistungs-Verhältnis bei lang andauernden Programmieraufgaben hin, mit Verbesserungen bei CursorBench 4.0 und besserer Ausdauer bei mehrstündiger Büro- und Terminalarbeit. Fortschritte bei DeepSWE und EEBench deuten auf stärkere Reasoning-Fidelität und Fehlererholung in technischen Bereichen hin, während das trainingsbezogene Harness-Awareness darauf abzielt, Gesprächsdrift in Agenten-Workflows zu reduzieren. Die Kombination aus längerem Kontext und sichereren Standardeinstellungen sollte die Architektur vereinfachen: weniger Chunking-Tricks, schlankere Retriever und kleinere Prompt-Gerüste. Für Teams, die große Spezifikationen oder Compliance-Dokumente verwalten, kann der erweiterte Arbeitsspeicher von 4.7 mehrstufige Abläufe in Ein-Durchlauf-Pläne mit kontextbezogenen Notizen und strukturierten Selbstprüfungen verwandeln.
Die Sicherheit ist deutlich robuster. Der neue Schutzstapel meldet stärkeren Widerstand gegen Jailbreaks und bessere Handhabung von Dual-Use, ohne legitime Sicherheitsarbeit übermäßig zu blockieren. Das ist wichtig für die Unternehmensakzeptanz, wo agentenbasierte Systeme oft mit Terminals, Codeausführung und sensiblen Daten interagieren. Operativ ist 4.7 über API, Programmier-Harnesses und Router verfügbar, mit $2 pro Million Eingabe-Token und $6 pro Million Ausgabe-Token, sowie einer optionalen schnelleren Stufe mit doppelter Geschwindigkeit und Preis. Teams sollten direkte Vergleichstests mit ihren realen Workloads durchführen und dabei die Qualität der Aufgabenerfüllung, Zuverlässigkeit der Werkzeugaufrufe und Gesamtkosten pro abgeschlossener Aufgabe messen, statt isolierte Latenz oder einzelne Benchmark-Ergebnisse.