

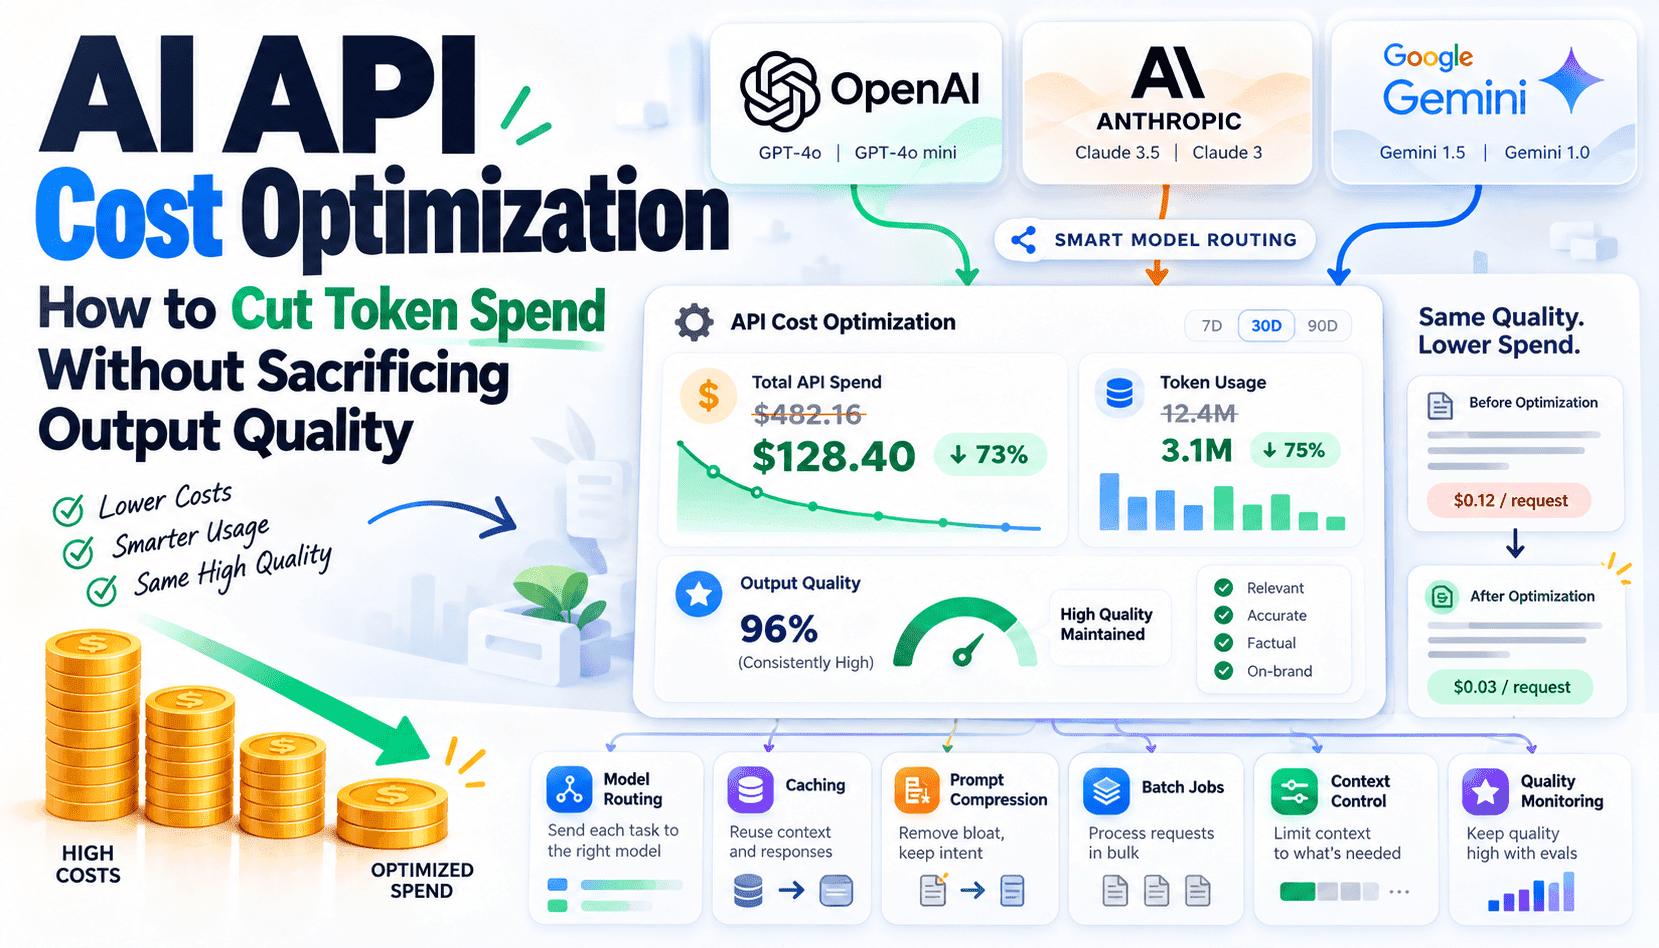
L’essor de l’IA générative a fait des coûts liés aux tokens un poste de dépense important. Sans suivi, ces coûts augmentent avec le nombre d’utilisateurs, la longueur des contextes et des sorties non maîtrisées. Optimiser les coûts ne consiste pas à toujours choisir le modèle le moins cher : il s’agit d’adapter les capacités du modèle à la complexité de la tâche, de limiter les tokens superflus dans les entrées comme dans les sorties, et de revoir les processus pour ne recourir à une inférence coûteuse que lorsqu’elle améliore réellement les résultats métier. Cet article présente les leviers opérationnels à la disposition des équipes et les indicateurs nécessaires pour mesurer les compromis.
Commencez par définir une cartographie des capacités et du routage : classez les requêtes selon leur complexité et le niveau de qualité requis, puis orientez les tâches simples vers des modèles plus petits et moins coûteux, ou vers des modules déterministes. Par exemple, de courtes retouches de texte, des traductions au format strict ou une extraction d’intention simple peuvent souvent être traitées par des modèles distillés ou des heuristiques. En revanche, la génération créative de textes longs et le raisonnement nuancé en plusieurs étapes doivent être réservés à des modèles plus puissants. Mesurez le taux de réussite et le taux de réorientation de chaque parcours pour repérer les échecs des options moins coûteuses et ne faire remonter que les requêtes qui le nécessitent.
Pour maîtriser les coûts, l’ingénierie des prompts s’appuie sur trois pratiques concrètes : condenser les consignes sans en perdre le sens, tirer parti du contexte système partagé et réduire le contexte dynamique. Utilisez des modèles compacts, des exemples few-shot numérotés et des schémas de fonctions structurés pour limiter le verbiage. Conservez le contexte système stable côté serveur et n’ajoutez que les éléments dynamiques nécessaires. Pour les longs historiques de conversation, préférez un résumé au renvoi des messages bruts ; pour les tâches reposant sur de nombreux documents, récupérez et classez les passages les plus pertinents au lieu d’injecter des documents entiers dans le prompt.
Au-delà des prompts, intégrez à votre infrastructure des mécanismes de mise en cache, de traitement par lots et de contrôle des pipelines. Un cache hybride, combinant correspondance sémantique et correspondance exacte, évite de relancer les mêmes inférences coûteuses. Regroupez les tâches peu prioritaires pendant les heures creuses ou sur des ressources de calcul moins coûteuses. Dans la mesure du possible, imposez des limites de sortie et des tokens d’arrêt, et privilégiez les appels de fonctions déterministes afin d’éviter les générations de texte sans borne. Enfin, adoptez un cadre unifié de maîtrise des coûts qui suit conjointement les tokens d’entrée et de sortie, le taux de succès du cache, la latence et les indicateurs de qualité, pour que les décisions tiennent compte à la fois du prix et de la réussite du produit.